

Всем привет! Меня зовут Никита, я старший разработчик в команде Storage. Мы в Ozon делаем собственное S3-совместимое хранилище, которое уже хранит 130 PB данных. Какое‑то время назад мы очень подробно рассказали, почему нам перестали подходить коробочные решения, по каким критериям мы выбирали технологии для собственной реализации и описали основную схему получившегося хранилища.
Хранилище постоянно растёт, и вместе с ним появляются задачи, которых раньше просто не существовало в таком масштабе. Одна из них звучит довольно просто: как перенести огромный бакет из одной части S3 в другую, продолжая принимать запросы на чтение и запись и не заставляя пользователей вообще думать о том, что где‑то идёт миграция.
Слона будем есть по частям. Чтобы понять, зачем нам понадобилось перемещать данные, сначала коротко разберём архитектуру.
Содержание
Архитектура S3 Ozon
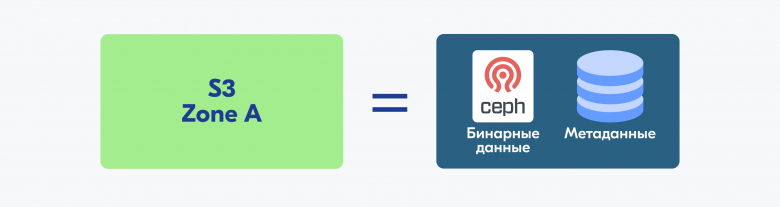
Весь наш большой S3 состоит из нескольких десятков зон. Если по‑простому, зона S3 — это отдельный кластер объектного хранилища. Он состоит из трёх частей: кластера Ceph, где лежат бинарные данные объектов, кластера NoSQL‑СУБД с метаданными (далее БД метаданных) и сервиса, который реализует S3-протокол. Причём зона самодостаточна — это полноценное объектное хранилище, с которым можно работать напрямую.
Если бы все зоны жили отдельной жизнью, это было бы очень неудобно. Представьте, вы как клиент хотите пойти в бакет за данными. Если зоны существуют сами по себе, вам придётся помнить, в какой именно зоне лежит ваш бакет. Поэтому все зоны находятся под одним зонтиком — это сервис s3front. Он знает всё о местоположении ваших данных. Все запросы приходят в s3front, он понимает, к какому бакету вы обращаетесь, и маршрутизирует запрос в нужный кластер. Схема на рисунке ниже: вы хотите сходить за объектом в бакет mybucket, отправляете запрос в s3front, тот понимает, что бакет живёт в зоне A, и отправляет запрос дальше.
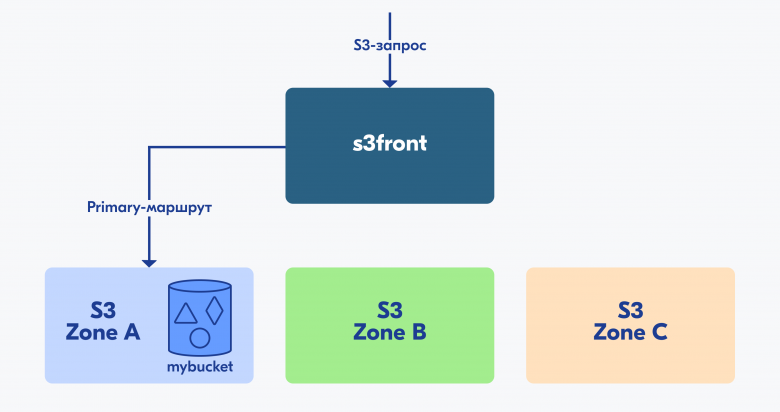
Чем хороша такая схема? Во‑первых, понятно, как масштабировать хранилище. Нужно сохранить ещё несколько десятков петабайтов? Не проблема, заведём новые зоны, если есть железо. Запросы как ходили в s3front, так и ходят, клиентам не нужно прописывать адреса новых зон.
Но проблемы в такой конструкции тоже возникают. Основная проблема — независимость зон оборачивается неравномерной утилизацией ресурсов. Для наглядности посмотрим на картинку ниже.
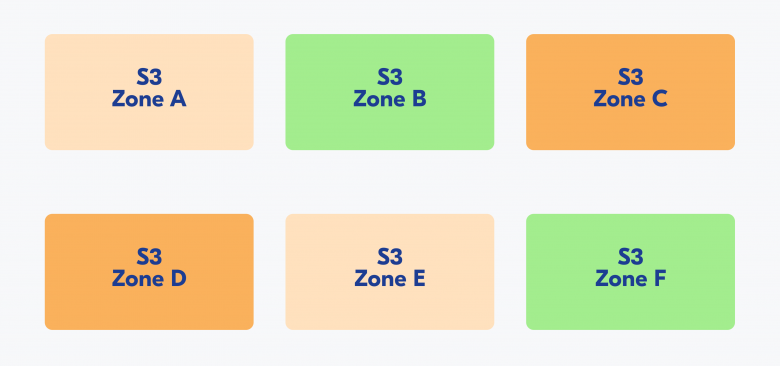
В зоне C дисковое пространство может быть утилизировано на условные 70%, в зоне A на 40%, а в зоне F вообще на 30%. Места в хранилище ещё много, но если данные в зоне C продолжат расти, будет, мягко говоря, нехорошо. И ладно бы только диск, есть и другие измерения: количество объектов, количество удалений, трафик в зону. Количество объектов и удалений напрямую связано с нагрузкой на БД метаданных, и если по объектам есть перекос, то в этой зоне будет повышенная нагрузка на фоновые джобы. Хотелось бы, чтобы ресурсы во всех зонах утилизировались равномерно.
Прежде чем рассказывать о решении, поясню один важный момент. Внимательный читатель сразу спросит: «А может, не нужны десятки зон, сделаем один большой кластер, и балансировать ничего не придётся?» Идея хорошая, но надо вспомнить про ограничения. Составная часть зоны S3 — это кластер Ceph, который хранит бинарные данные объектов. С учётом требований к размеру доменов отказа и имеющихся дисков наш опыт эксплуатации говорит, что кластеры Ceph не стоит растить бесконечно. В одной зоне мы держим несколько петабайтов данных. Технически Ceph тянет и больше, но эксплуатация таких зон становится сложнее. Значит, из нашего ограничения на объём одного кластера Ceph следует ограничение на объём одной зоны. Зон будет много, и придётся решать проблему неравномерного распределения данных.
Миграция как один из способов решить проблему неравномерной утилизации
Обсудим способы решения. Вернёмся к примеру: в одной зоне данных много, в другой почти нет. Очевидное решение — это перенести данные из более нагруженной зоны в менее нагруженную. Как это сделать?
Выбор способа миграции
Мигрировать данные можно разными способами, но концептуально в нашем случае есть два подхода: переносить данные по S3-протоколу или переносить данные с помощью внутренних интерфейсов, зная детали реализации нашего объектного хранилища.
Подход с S3-протоколом понятен. В самом простом случае для переноса объекта между зонами достаточно выполнить GetObject из кластера‑источника и PutObject в целевой кластер. С внутренними интерфейсами сложнее из‑за того, что нам нужно думать не о переносе единого S3-объекта, а о переносе его составляющих — строк в таблице БД метаданных и связанных с ними объектов Ceph. При этом такой подход позволяет использовать некоторые оптимизации, которые на уровне S3-протокола недоступны.
Кроме простоты S3-протокола, стоит отметить ещё один важный фактор — миграция на этом уровне позволяет переносить данные между разными реализациями S3. И именно этот фактор оказался решающим в своё время. Дело в том, что данные мы мигрировали и раньше. В статье про нашу реализацию S3 мы подробно описывали перенос с Ceph RGW на наше объектное хранилище с помощью сервиса‑мигратора s3-migrator. Поэтому на момент обсуждения проблемы неравномерной утилизации ресурсов у нас уже был сервис, который мог бы решить поставленную задачу. Разберём во всех подробностях, как он работает, и проверим, подходит ли он для новой задачи.
Миграция без простоя
Для этого вернёмся к примеру с бакетом mybucket. Пусть он живёт в зоне A, где критически высокая утилизация дискового пространства, а в зоне B свободного места много. Чтобы зона A не встала на запись, бакет хочется перенести в зону B. Важно, чтобы пользователи не замечали, что их бакет переезжает. Основное требование к хранилищу — данные всегда доступны на чтение и запись. Если оно не выполняется, довольных не будет.
Миграции с downtime (offline‑миграции) нам не подходят: мы не можем сказать пользователям «подождите час‑другой, мы тут данные перевезём». Такое приемлемо разве что для архивных хранилищ, где нет требований к быстрому доступу. Значит, нам нужны миграции без простоя, они же online или live. Посмотрим, как это можно обеспечить. До миграции запросы маршрутизируются так:
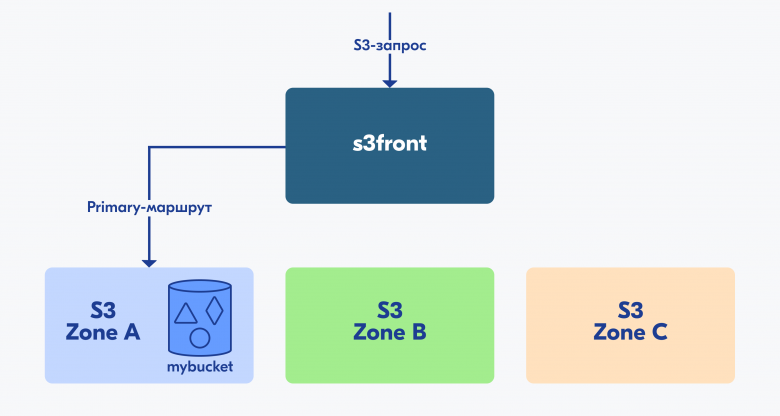
Маршрутизация запроса
Все запросы приходят в s3front, который маршрутизирует их до нужной зоны. Пока маршрут один (он же primary), всё тривиально: есть единственный путь, по нему и идём. Чтобы мигрировать данные в другую зону, нужно создать бакет с теми же свойствами в целевой зоне (да, именно бакет‑пустышку с тем же именем), переключить маршруты и начать перенос. Получится такая картинка:
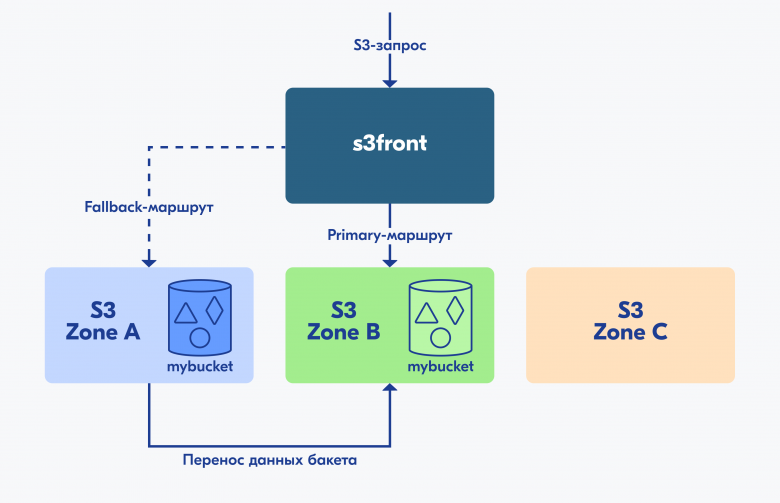
Данные переносятся не мгновенно, а запросы идут почти сразу после переключения маршрутов. Запрос на чтение сначала идёт по primary‑маршруту. Может оказаться, что объект ещё не успели перенести, тогда зона B ответит 404: объекта там пока нет. s3front обработает такую ситуацию и пойдёт по fallback‑маршруту, где объект найдётся. В итоге пользователь получит свой объект и не узнает, что его бакет переезжает. С записью проще: она идёт только в primary‑маршрут.
Нюансов, конечно, хватает. К примеру, удалять объект нужно из обоих кластеров. При переносе нужно убедиться, что в целевом кластере не лежит более новая версия объекта, иначе новую версию можно затереть старой. Отдельные сложности связаны с использованием S3-протокола.
Особенности использования S3-протокола
При загрузке объекта в S3 вы не можете проставить желаемую дату и время создания. У объектов есть единственный timestamp, который отдаётся наружу — LastModified. Причём на него завязаны как механики самого S3, так и пользователи. Если не обработать эту ситуацию, то LastModified станет датой миграции, и сломаются Lifecycle‑политики. Давайте рассмотрим конкретный пример.
Допустим, у вас есть правило: удалять объекты старше месяца. При переносе данных все объекты в целевом кластере будут выглядеть новыми, вне зависимости от даты их создания. Таким образом, правило отрабатывать не будет, и первые удаления объектов начнутся только через месяц после миграции. В какой‑то момент бакет может просто переполниться по месту, потому что никто не закладывался на то, что правило перестанет отрабатывать. А если срок больше — скажем, будет правило на удаление объектов старше года, — ждать придётся год? Ещё хуже, если на это поле завязана бизнес‑логика клиента: последствия тогда непредсказуемы. Чтобы такого не происходило, наша реализация понимает, какие запросы идут от мигратора, и сохраняет LastModified неизменённым. Благодаря этому клиенты по‑прежнему не замечают миграцию.
Теперь стоит отдельно проговорить, что объекты в S3 могут грузиться разными способами: с помощью PutObject можно загрузить целый объект сразу, или по частям (партами) тремя методами CreateMultipartUpload, UploadPart, CompleteMultipartUpload. После переключения маршрутов новые запросы на PutObject просто пойдут в новую зону, а вот с частями составного объекта всё сложнее. Например, мы начали загрузку объекта по частям, загрузили первые несколько частей, после чего primary‑маршрут переключился в другой кластер. Нужно решить, как позволить клиенту дозагрузить оставшиеся части объекта. Формально в кластере‑источнике объекта ещё нет, есть только его части. Клиент вполне может не собирать объект вовсе и сделать AbortMultipartUpload. Мы решили эту проблему так: разрешаем клиенту дозагрузить парты в кластер‑источник, а если объект в итоге будет создан, доперевозим его.
С особенностями протокола разобрались. Осталось рассмотреть сам процесс миграции данных.
s3-migrator V1
Разберём, как устроен s3-migrator, и поймём, где его можно улучшить. Концептуально миграция делится на несколько фаз: Listing, Transfer, Checking и дополнительная фаза Relisting. Пройдёмся по каждой.
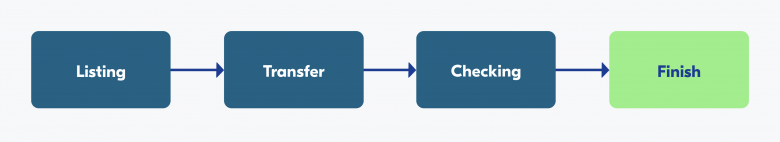
Listing. Чтобы переносить объекты, нужно понять, что лежит в бакете в кластере‑источнике. s3-migrator листит все объекты из источника в персистентное хранилище в PostgreSQL. Некоторые инструменты, такие как rclone, листят бакет и хранят список объектов в оперативной памяти. Для наших объёмов это не подходит: миграцию хочется уметь останавливать и возобновлять, а листить весь бакет заново при любом отклонении от штатного сценария слишком дорого. Поэтому храним всё в таблице PostgreSQL.
Transfer. Тут просто: читаем таблицу из PostgreSQL и переносим объекты из источника в целевой кластер.
Checking. Этап сверки нужен, чтобы финально проверить, что всё перенеслось корректно, включая метаданные объектов. Если сверка нашла ошибки, мы их классифицируем и, например, повторно переносим сам объект или его метаданные.
Relisting. Дополнительная фаза для мультипартов, про которые говорили выше. Мы проверяем, не появились ли в кластере‑источнике новые объекты, собранные из частей. Если появились, переносим и их.
По окончании мы проверяем, что у миграции нет ошибок и походов по fallback‑маршруту за контрольный период. Если всё хорошо, миграцию можно завершить: удаляем fallback‑маршрут, и у бакета остаётся только primary в новый кластер. Вся схема работает потому, что после переключения маршрутов в кластер‑источник уже никто не пишет (кроме мультипартов), то есть мигратор листит данные из снимка бакета. С фазами разобрались, дьявол в деталях реализации.
Архитектура s3-migrator выглядит так:
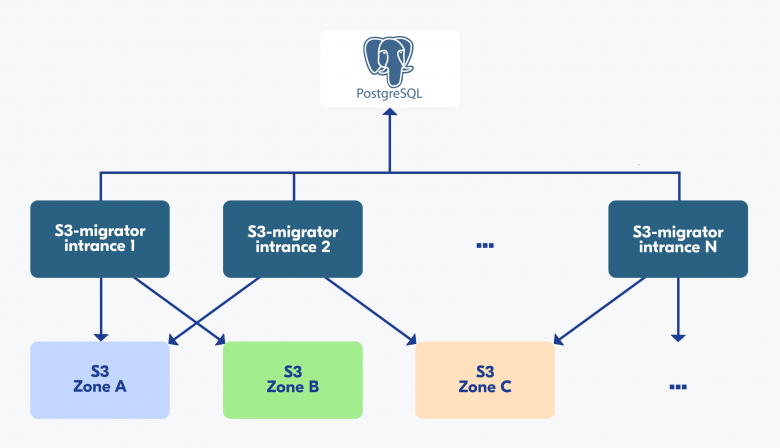
Есть персистентное хранилище PostgreSQL, в которое мы листим объекты. Сервис‑мигратор развёрнут в виде подов, как и s3front, но поды ходят в зоны S3 напрямую, минуя s3front. Напомню, что каждая зона самодостаточна, поэтому s3-migrator может работать с зонами напрямую. Прямые походы помогают оптимизировать сетевой трафик.
Следующий вопрос: как поды распределяют миграции между собой? Вариантов синхронизации много: с лидером, без лидера, со знанием соседей и без. Мы выбрали самый простой: кто первым успел сделать INSERT строки с ID миграции и названием фазы (например, transfer), тот и победил.
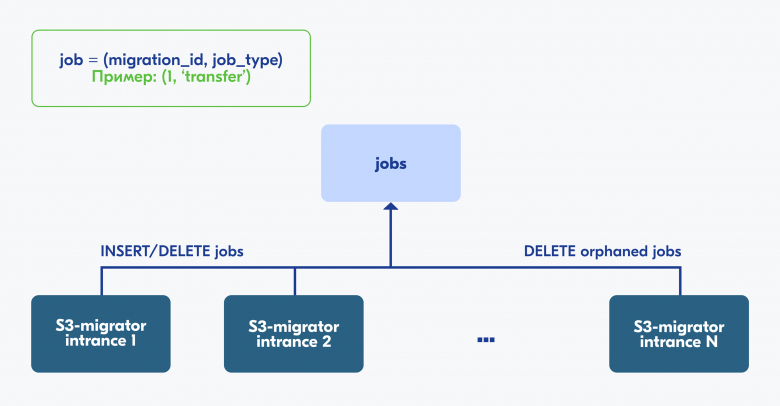
С распределением задач понятно. Теперь вопрос: как хранить объекты? Для понимания масштаба: в одном бакете спокойно лежат несколько сотен миллионов объектов. Хранить всё в одной таблице, с которой мы ещё и хотим активно работать — это не очень хорошее решение. Во‑первых, при нескольких активных миграциях придётся решать вопрос конкурентного доступа нескольких подов к одной таблице. Во‑вторых, чтобы удалить записи об объектах конкретной миграции, придётся делать селективные запросы на удаление. Классический трюк — это партиционирование. Удобно: завершил миграцию, дропнул партицию целиком.
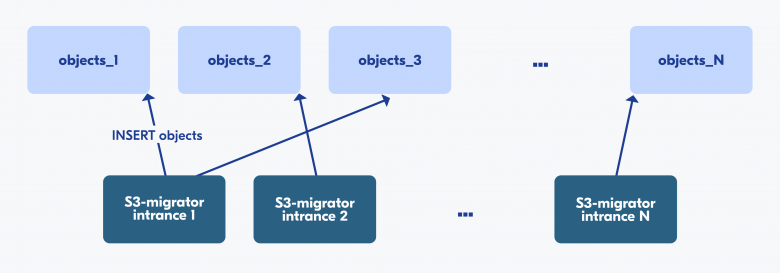
Мы прошлись по основной схеме работы мигратора. Перечислим плюсы этой версии:
Отслеживаем состояние миграции, можем узнать статус каждого объекта (всё лежит в PostgreSQL, просто используем SQL‑запросы).
При наличии проблемных объектов не листим бакет заново, а разбираемся с отдельными объектами (тоже за счёт персистентного хранилища).
Можем массово запускать миграции благодаря масштабированию (мигратор развёрнут в N подов).
Такое решение работало до определённого момента, но потом появились новые требования.
s3-migrator V2
В какой‑то момент у нас произошло важное событие: хранилище доросло до того, что мы сняли ограничение на количество объектов в одном бакете. Ядро хранилища к этому было готово, у нас спокойно жили бакеты практически с любым количеством объектов, которое требуется клиентам. Но для мигратора это серьёзное требование. Если количество объектов в бакете почти безгранично, то и таблица объектов в PostgreSQL должна быть почти безгранична. Да, мы партиционировали таблицу для каждой миграции, но этого уже недостаточно: то, что раньше считалось большим бакетом, сегодня в лучшем случае — средний.
Кроме того, бакет мало корректно залистить, его нужно ещё и перевезти за разумное время. Причём интересна не скорость сама по себе, а именно время переноса. Везти гигантский бакет несколько часов или пару дней нормально, мы никуда не спешим. А вот если бакет едет несколько недель, эксплуатировать такое неудобно.
В первой версии поды договаривались, кто какую фазу возьмёт. Допустим, какой‑то под взял трансфер конкретной миграции. Он один и будет везти гигантскую партицию. То есть мигратор первой версии хорош, когда нужно перенести много небольших бакетов. Если бакет один и гигантский, его везёт один под. Миграция — это I/O‑bound операция. В основном мы завязаны на сеть: шире полоса, быстрее перенос. Единственный способ ускориться это выкрутить конкурентность так, что под займёт всю полосу кубер‑ноды, а в кластере, где живут и другие сервисы, это непозволительно. Когда очень нужно было, мы временно на это шли. Разово так пожить можно, но уходить от этого надо. Нужен распределённый трансфер: если одну миграцию везут N подов на разных нодах, суммарная полоса растёт горизонтально, и упираться в одну ноду больше не нужно.
Вторая проблема в том, что в схеме первой версии был один инстанс PostgreSQL. Партиций много, и они немаленькие. При массовом переносе бакетов в PostgreSQL может лежать несколько терабайт данных, а для одного инстанса это многовато. Приходилось ждать, когда предыдущая пачка миграций закончится, данные почистятся и место освободится. Итого мы упирались в общее место в PostgreSQL.
Перечислим проблемы первой версии:
Трансфером миграции занимается только один под, из‑за чего скорость переноса гигантских бакетов оставляет желать лучшего.
Один под мигратора может упереться в сеть.
Перед массовыми миграциями приходится смотреть на свободное место в PostgreSQL.
Чтобы это решить, мы пришли к такой архитектуре:
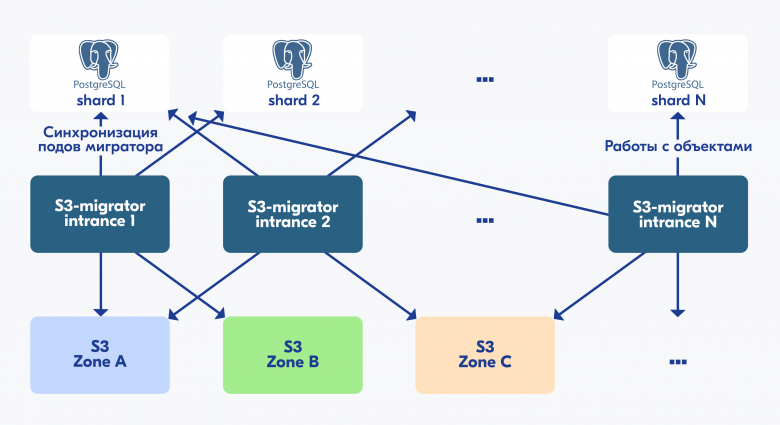
Если нужно почти безграничное дисковое пространство в PostgreSQL, базу надо шардировать — решение вполне классическое. У нас будет N инстансов PostgreSQL вместо одного. Благо есть платформенная команда, которая выдаёт шардированный PostgreSQL по кнопке. Шардирование закрывает нехватку места: теперь миграции можно запускать пачками, не оглядываясь на свободное место.
Перейдём к более интересному: как распределённо переносить объекты одной миграции. Подходов несколько. Первый — конкурентно разбирать записи объектов в несколько подов. Можно взять FOR UPDATE SKIP LOCKED или более хитрый pg_advisory_lock, но всё это про то, как конкурентно работать с одной таблицей. Конкурентный доступ — всегда накладные расходы на синхронизацию: приходится думать про lock contention и про цену каждого подхода. Есть и второй подход: организовать распределённый трансфер вообще без конкурентного доступа. Сделать это можно так:
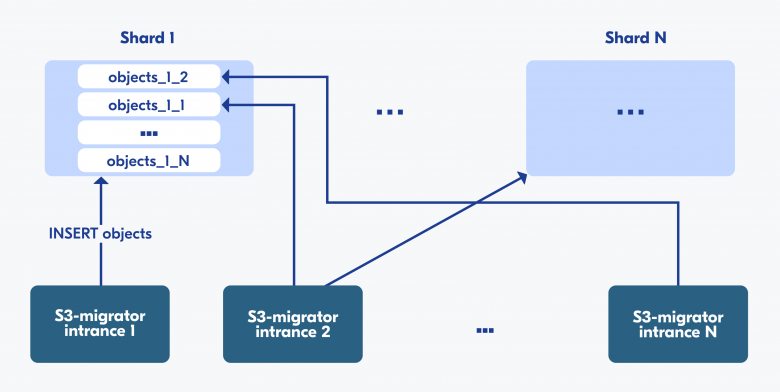
Раньше мы партиционировали таблицу объектов для каждой миграции и так избегали конкурентного доступа к одному ресурсу. Теперь мы делим партицию каждой миграции ещё на N частей, фактически это каскадное партиционирование. N подов работают с N отдельными таблицами одной миграции без конкурентного доступа. Заодно единица работы (партиция партиции) уменьшается в те же N раз, что важно для бакетов с гигантским количеством объектов. При старте миграции нам известно количество объектов в бакете, поэтому оптимальное количество партиций мы можем прикинуть заранее.
Результаты
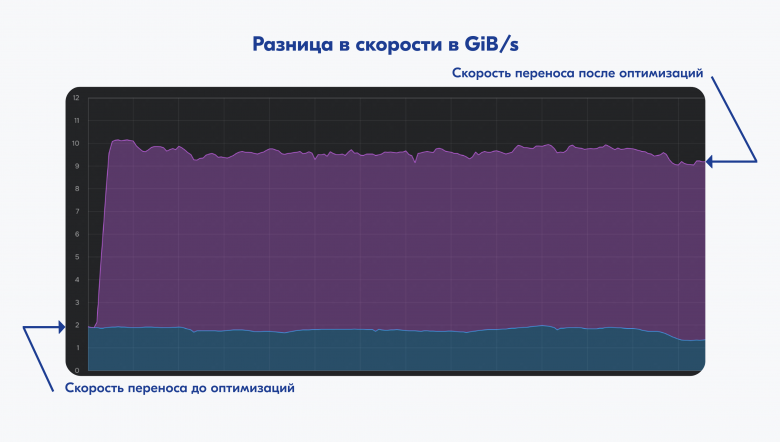
Давайте посмотрим на продовые данные. Как отмечали выше, миграция это I/O‑bound операция и в основном про сеть, поэтому на графиках мы видим ожидаемую картинку. Синяя линия это перенос первой версией мигратора, где данные вёз один под. Сиреневая это тот же по размеру и структуре бакет, но уже после всех улучшений, в пять подов. Скорость выросла примерно пропорционально числу подов: с 2 GiB/s до 10 GiB/s (не путать GiB/s с Gb/s). В этот момент скорость миграции стала ограничиваться влиянием на кластеры, а не пропускной способностью сетевого интерфейса. Очень важно не мешать пользовательскому трафику при миграции данных, мы же хотим остаться незаметными!
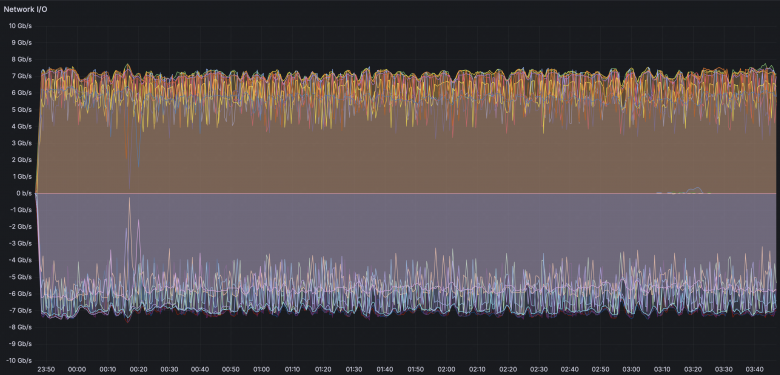
Отдельно отмечу, что поды не должны попасть на одну ноду. Если бы все пять приехали на одну ноду, мы получили бы ту же самую сверхутилизацию сети и всё равно не выросли бы до 10 GiB/s из‑за ограничения сети одной ноды. Вот как все пять подов равномерно везли данные (вверх — приём, вниз — передача):
Ещё мы смогли запускать массовые миграции, не проверяя каждый раз, хватит ли места в PostgreSQL. Итог: миграции идут быстро, соседям не мешаем, запускать можно пачками. Мигратор рассчитан на те объёмы, которые реально лежат в нашем хранилище.
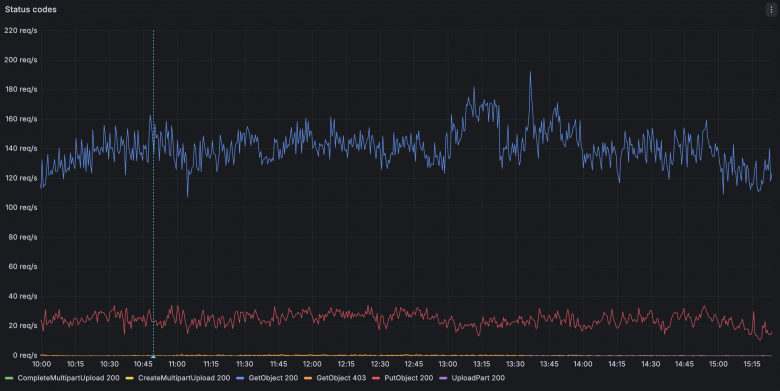
Отдельно посмотрим на миграцию со стороны клиента. Вертикальная линия на графике ниже — начало миграции: переключаются маршруты, запись уходит в целевой кластер. Для клиента не изменилось ничего: тот же RPS, те же коды ответов, и ни одного 404, хотя внутри fallback‑походы уже пошли. Миграция и правда прошла незаметно!
Какие выводы можно сделать? Я бы выделил два пункта:
Создавайте сложные системы по потребностям, а не по инженерному желанию. Сложные системы вырастают из простых. Архитектуру мигратора мы усложнили тогда, когда появилась реальная потребность. Если бы объёмы не росли, спокойно жили бы на первой версии.
Все части системы должны бежать с одной скоростью. Если одна часть убежала вперёд, это только полдела. Не появись мигратор второй версии, перенос гигантского бакета в срочном порядке стал бы проблемой.
В этой статье мы на конкретном примере посмотрели, как эволюционируют большие системы. Заметьте: мы разобрали проблемы, подходы и решения, пришли к новой версии мигратора, а для пользователей процесс миграции как был невидимым, так и остался. И сколько ещё таких слоёв, где меняется всё, а снаружи не видно ничего, вопрос открытый.
Собственно, для этого платформа в Ozon и существует. Продуктовые команды должны думать про свой домен. Если им нужно хранить миллиард объектов, они приходят к нам обсудить, оправдан ли такой объём и как лучше разложить данные. А если объём оправдан, инженерам продуктовой команды не нужно становиться специалистами по объектным хранилищам: это наша работа. Забавно, что мы и сами выступаем заказчиками продвинутых фич: шардированный PostgreSQL заказали по кнопке. Мы могли бы стать специалистами по шардированию PostgreSQL, но это время явно полезнее потратить на наш S3.
Хранилище продолжает расти, появляются новые инженерные задачи, о которых тоже хочется рассказать. Спасибо за внимание, надеюсь, было интересно!
P. S.
Статья написана по мотивам одноимённого доклада на infra.conf, посмотреть его можно тут. Подробностей там меньше из‑за тайминга, зато есть детали, которые в статью не вошли: как классифицировать миграции в общем случае и почему нам не подошёл rclone.
Комментарии (9)


Manabreaker
29.10.2026 06:44А рассматривали вариант не листить все объекты заранее в PostgreSQL, а получать их через
ListObjectsV2постранично и сразу переносить, сохраняяContinuationTokenдля восстановления после сбоев?Так можно было бы избежать хранения миллиардов записей в БД. Почему выбрали именно предварительный листинг?

phiker Автор
29.10.2026 06:44Тут есть несколько моментов. Начнём с того, что мы используем S3-протокол, поэтому, чтобы узнать, что лежит в бакете в кластере-источнике, нужно использовать
ListObjectsV2или аналог. Листинг фактически однопоточный, поэтому эта фаза миграции будет запущена только на одном поде. Мы можем залистить страницу объектов, перенести пачку этих объектов, проверить, что всё перенеслось без ошибок и пойти дальше, ошибки куда-то сохранить. Если вдруг под упал, то после старта достаёмContinuationTokenи продолжаем работу. Вполне понятный вариантНо это однопоточная схема, а хочется переносить объекты в несколько подов. Получается, нужно организовать передачу этой пачки или постоянного потока объектов из листинга другим подам, чтобы они начали переносить параллельно. Причём
ContinuationTokenописывает позицию в листинге, а не состояние переноса: как только объекты внутри страницы везутся конкурентно, по токену уже не понять, что залистили, что успели перенести, а что упало с ошибкой. В этот момент можно рассматривать разные схемы, но один из вариантов будет просто листить все объекты в персистентное хранилище и параллельно начать их переносить, как у нас и реализованоНу и некоторые фазы опираются на сравнение двух снапшотов листинга. Например, релистинг, который ищет объекты, собранные из частей мультипарта
Manabreaker
29.10.2026 06:44Понял, спасибо! Вообще, я скорее имел в виду один pod для листинга и несколько для параллельного переноса через персистентную очередь, но тогда действительно возникает необходимость отдельно отслеживать состояние задач. А про сравнение снапшотов при релистинге не подумал.
greeensnake
Добрый день, зачем использовать дополнительный уровень абстракции дискового пространства в виде ceph, имея проблемы с ним при его масштабировании, особенно при наличии миллиардов мелких файлов (10ки КБ), вы не смотрели в сторону архитектуры Storage Grid от нетапа?
XmaksvellX
во-первых, кажется, неочень корректно сравнивать open source и коммерческий софт
во-вторых, у Ceph на уровне librados с учетом CRUSH алгоритма как раз-таки нет проблемы мелких файлов просто by design
она есть на уровне их реализации объектного интерфейса, но это уже совсем другая история
greeensnake
Добрый день, а разве я что то сравнивал? Я лишь поинтересовался анализом иной архитектуры на применимость в рамках озвученных задач. Я рад что в вашем окружении вы не сталкиваетесь с проблемами мелких файлов, однако, гипотетически - если у вас есть бакет с 15млрд объектов по 5КБ, он живет в одной из ваших зон (т.е в кластере ceph), и в этом кластере выходит из строя сервер с потерей данных, запускается восстановление избыточности - какое влияние на предоставляемый вами сервис будет?
XmaksvellX
да, сталкивались, конечно, и как раз в начале статьи дана ссылка на другой рассказ про то, почему для индекса объектов в RGW это проблема, и как она была решена: https://habr.com/ru/companies/ozontech/articles/818433/
ну и собственно CRUSH алгоритм как раз и призван нивелировать влияние доменов отказа (диск, хост, серверная стойка) на производительность кластера
подробнее про то, как реализована работа с большими доменами отказа в Ozon рассказывали в нескольких докладах, думаю, как-нибудь соберемся описать и в более удобном и информативном формате статьи
phiker Автор
Архитектур S3-совместимых хранилищ, конечно, много. Можно разделять слой метаданных и бинарных данных, как это делаем мы. Можно хранить метаданные рядом с бинарными данными, как MinIO. Есть хранилища, которые прям заточены под маленькие объекты, к примеру SeaweedFS, но везде свои нюансы
Справедливо, что Ceph ограничивает размер зоны, и хочется подумать, как снять это ограничение. Причём сам Ceph как хранилище бинарных данных у нас не вызывает вопросов. Для снятия ограничений я бы думал не в сторону замены Ceph, а в сторону шардированных бакетов, которые могут жить в нескольких зонах (и, соответсвенно, в нескольких кластерах Ceph) сразу. Для этого не нужно заменять Ceph или менять размеры его кластеров, основные вопросы лежат в области метаданных и маршрутизации запросов в нужную зону