

Несколько десятков черных полос когда-то изменили мировую торговлю: кассиру больше не нужно было вручную вводить цену каждого товара, а магазины впервые получили возможность автоматически учитывать огромные потоки продукции. Потом полоски превратились в квадраты, информации стало помещаться значительно больше, а поврежденный код научился восстанавливаться буквально по оставшимся кускам. К торговле добавилась логистика, медицина, реклама и еще сотня разных отраслей. Разберемся, как устроены линейные штрихкоды, QR и Data Matrix, чем они отличаются и какие задачи решают.
И почему на молоке именно Data Matrix? Все ответы ниже.
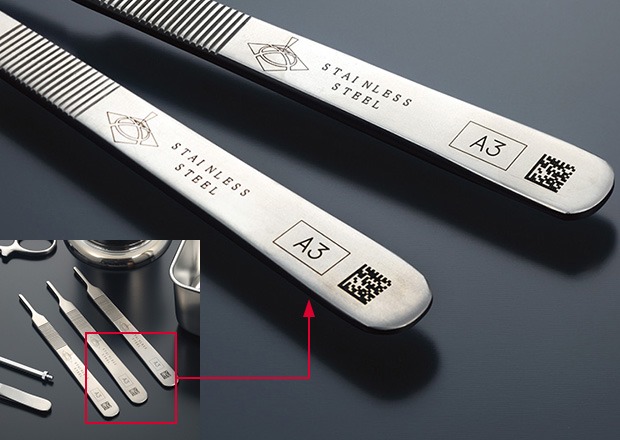
Отсканируй это!
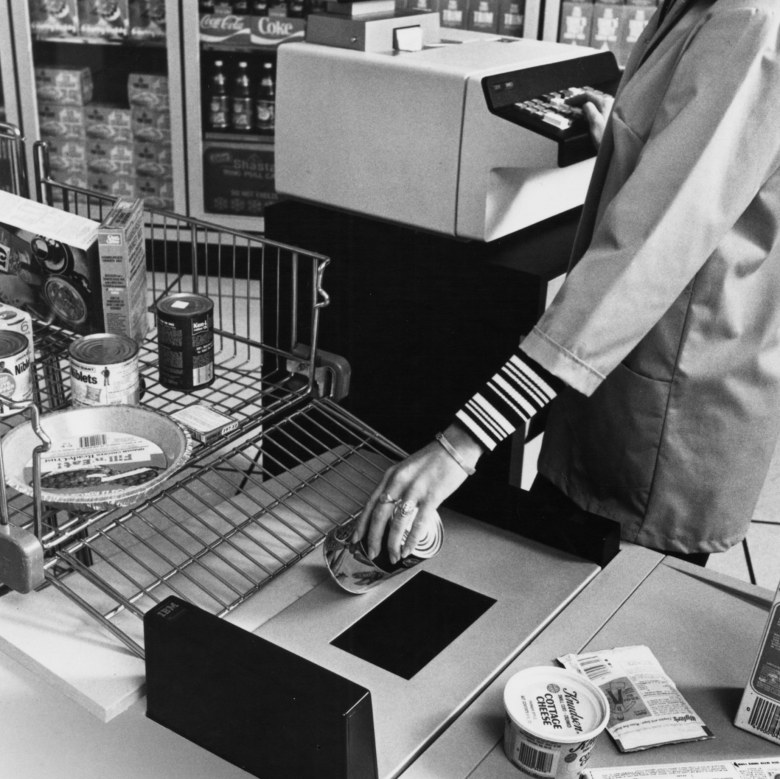
Каноническая история начинается 26 июня 1974 года в 8:01 утра. Супермаркет Marsh в городке Трой, штат Огайо, кассир Шэрон Бьюкенен, Клайд Доусон из отдела исследований и разработок Marsh и упаковка из десяти пачек Juicy Fruit за 67 центов. Так случился первый в истории скан кода UPC на кассе. Знаменитая пачка, вопреки популярной легенде, в музей не попала — она осталась у Доусона. Зато в Смитсоновском музее хранится другая упаковка Wrigley’s того же времени и один из первых сканеров.
Скрытый текст
UPC (Universal Product Code) — это 12-значный американский стандарт штрихкода, который используется для отслеживания товаров в магазинах и идентификации музыкальных релизов на цифровых платформах
Погодите. Первый скан UPC — да. Но экспериментальные автоматизированные кассы со штриховым кодом появились на два года раньше. 3 июля 1972 года в магазине Kroger Kenwood Plaza в Цинциннати заработала система RCA (Radio Corporation of America). Код у неё был круглый, его ещё называли «бычий глаз» из патента Вудланда и Сильвера: концентрические кольца разной толщины.
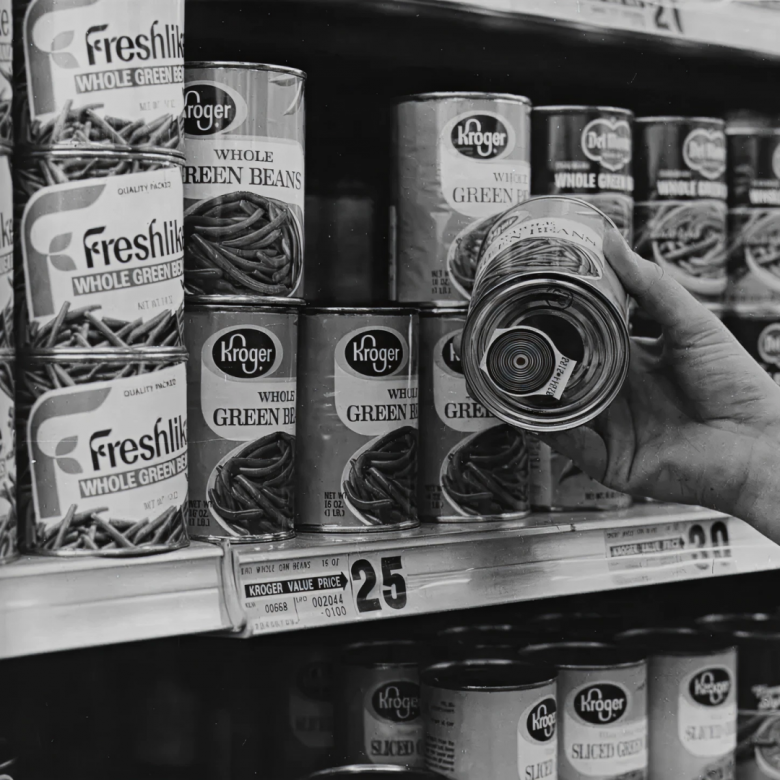
Что же пошло не так? В 1973 году отраслевой комитет выбирал единый символ для всей продуктовой торговли США, и RCA со своим кругом, обкатанным на живом магазине, выглядела фаворитом. Круг ведь читается с любой стороны — ради этого Вудланд его и придумал. Но победил прямоугольник IBM, который нарисовал Джордж Лорер и который все мы сейчас знаем как штрихкод. Почему?
Ответ кроется в несовершенстве типографского оборудования того времени. Печатная машина размазывает краску вдоль хода бумаги.
Если будет дефект с «размазом», то кольцо превращается в овал, толщина колец в разных направлениях становится разной, и код перестает читаться. А если размазать вертикальные полосы, лишняя краска просто стекает вверх и вниз. Полосы становятся выше, но ни на йоту не шире. Лорер потом прямо писал, что круговые коды было непрактично печатать с нужными допусками.
Что касается емкости, то от нового идентификатора хотели десять цифр, и ни одной больше, столько насчитали консультанты. Все остальное было скорее служебное: символ должен печататься стандартными машинами, печатающими упаковки, занимать не больше полутора квадратных дюймов вместе с цифрами. И давать не больше одной необнаруженной ошибки на 20 тысяч считываний.
В общем, штрихкод победил из-за особенностей, а точнее ограничений в печати тех лет.
Штрихкод наших дней
Переместимся в наше время. Классический EAN-13, тот, что на любой пачке в российском магазине, содержит 13 цифр. Допустим 4601234567893. Как это закодировано?
В штрихкоде 95 модулей — узких вертикальных полосок единичной ширины, каждая либо черная, либо белая. Выглядит формат так: 3 модуля защитного шаблона слева (черный-белый-черный), 42 модуля на шесть левых цифр, 5 модулей центрального разделителя, еще 42 на шесть правых и 3 на правый защитный. 3 + 42 + 5 + 42 + 3 = 95.
Каждая цифра — это семь модулей. Первый вопрос: раз на цифры у нас отведено 84 модуля, то где 13-я цифра? Пока выходит 84/7 = 12. Запомним этот вопрос, он важный.
Если вы думаете, что кодирование каждой цифры задано жестко, то чуть-чуть ошибаетесь. Способов кодирования каждой цифры не один, их три: A, B и C. В наборе A у каждой цифры нечетное число черных модулей, в наборе B — четное, а набор C — просто негатив набора A.
Скажем, шестерка в наборе A выглядит как 0101111: пробел, штрих, пробел и жирный штрих в четыре модуля. В наборе C — 1010000, то же самое, но черное с белым поменяли местами. В наборе B — 0000101, то есть картинка из C, прочитанная задом наперед.
Зачем так? Что за злобный любитель шифров это придумывал?
Дело в том, что правые шесть цифр всегда рисуются набором C. А вот левые шесть — вперемешку из A и B, и именно порядок этой смеси и есть первая цифра. Для нуля все шесть левых — набор A (и это как раз UPC-A, американский 12-значный код, который поэтому и является частным случаем EAN-13). Для нашей четверки порядок такой — A B A A B B.
Сканер читает шесть левых цифр, смотрит, у каких четное число черных модулей, а у каких нечетное, и по узору четности достает из таблицы первую цифру. Ее физически нет на этикетке. Она размазана по чужой четности.
У этого решения есть и второй бонус. Раз слева стоят наборы A и B, а справа только C, сканер по четности первого же прочитанного знака понимает, с какой стороны начинается код. Перевернули пачку вверх ногами — читается. Протащили справа налево — читается. А всенаправленное чтение на кассе — это уже заслуга высоты штрихов и многолучевого сканера, которому четность и подсказывает, что он прочел и в какую сторону. Подрежьте код по высоте, чтобы влез в макет, и на кассе он начнет капризничать.
Чтобы точно ничего не напутать, у штрихкода есть еще контрольная сумма. Считается она так. Берем первые 12 цифр, в нашем случае 4 6 0 1 2 3 4 5 6 7 8 9. Каждую вторую, начиная со второй, умножаем на 3, остальные оставляем как есть, и все складываем.
Цифры на нечетных местах (1-я, 3-я, 5-я и так далее): 4 + 0 + 2 + 4 + 6 + 8 = 24.
Цифры на четных местах: 6 + 1 + 3 + 5 + 7 + 9 = 31, умножаем на 3, получаем 93.
Вместе 24 + 93 = 117. Теперь смотрим, сколько не хватает до ближайшего числа, которое делится на 10. Ближайшее сверху — 120, не хватает 3. Вот эта тройка и есть контрольная цифра. Если бы сумма вышла, скажем, 120, контрольная была бы 0.
Сканер повторяет эту арифметику: 117 + 3 = 120, делится на 10 — код прочитан верно. Не делится — что-то перепутано, читай заново. Такая проверка ловит любую неверно прочитанную цифру и почти любую перестановку двух соседних. «Почти» — потому что если перепутать местами цифры, которые отличаются на 5, контрольная сумма не изменится. Это слабое место EAN-13, но вероятность на него нарваться не так уж высока.
Скрытый текст
Особенность штрихкодов – элементарная, но не всегда интуитивная арифметика. Давайте разберем ситуацию выше. Возьмём в нашем номере соседей 1 и 2 (позиции 4 и 5). По правилу «каждую вторую умножаем на 3» единица стоит с весом 3, двойка с весом 1. Они дают в сумму 1*3 + 2*1 = 5. Поменяем их местами: теперь двойка с весом 3, единица с весом 1: 2*3 + 1*1 = 7. Сумма изменилась на 2, до кратного 10 уже не дотягивается, сканер видит ошибку. Всё хорошо.
А теперь возьмём соседей 2 и 7. Правильно: 2*3 + 7*1 = 13. Перепутали: 7*3 + 2*1 = 23. Разница ровно 10. А проверка смотрит только на то, делится ли сумма на 10, — и 10 лишних она не замечает. Код с перепутанными 2 и 7 пройдёт проверку как правильный.
Идем дальше
Итак, что же лежит в этих 95 модулях? Только номер. Внутри — префикс компании GS1 переменной длины, номер товара и контрольная цифра. Сам префикс включает префикс национальной организации GS1 и часть, выделенную конкретной компании, поэтому граница между «кодом предприятия» и «кодом товара» находится не в фиксированном месте.
Префикс — это не страна производства, как думают многие. 460–469 значат не «сделано в России», а «номер выдан российской организацией GS1 — ЮНИСКАН».
ЮНИСКАН, кстати, зарегистрировали в Моссовете 22 марта 1991 года. «Коммерсантъ» тогда написал заметку с заголовком «Штрих-коды в СССР: заплатите нам 300 долларов, и мы наставим вам палок». 300 долларов стоило присвоение кода предприятию; до этого СССР в европейской ассоциации EAN представляла Торгово-промышленная палата. То есть массовая раздача номеров нашим предприятиям — это, если строго, история последних месяцев Союза, хотя место в EAN у страны было и раньше.
Ну и раз в коде только номер, у магазина есть лазейка. Префиксы 20–29 GS1 отдала под номера ограниченного обращения: правила для них пишет национальная организация, и наружу, в мировой оборот, такие номера не выходят. У нас их обычно используют внутри магазина или сети. Именно поэтому на этикетке с весов у вас код начинается с двойки: магазин сам зашивает туда свой код товара и вес или цену.
Есть еще 977, который отдан журналам (ISSN), 978 и 979 — в основном книгам.
Скандал в супермаркете
Раз уж цены в коде нет, откуда она берется в чеке? Из базы магазина. Касса шлет номер, база отвечает ценой. Сегодня это звучит логично и даже банально, а в 1974 году это был, не поверите, просто скандал.
Дело в том, что до сканера цена была написана на каждом товаре в виде приклеенного ценника. Магазины, естественно, хотели от этого избавиться: перемаркировка при каждом изменении цены была одной из самых значительных статей расходов, и именно ее консультанты и обещали схлопнуть, уговаривая внедрить маркировку штрихкодом. Потребительские организации поняли это мгновенно и взбунтовались: сегодня сканер, а завтра ценники с банок уберут. И ведь правда уберут, если не помешать.
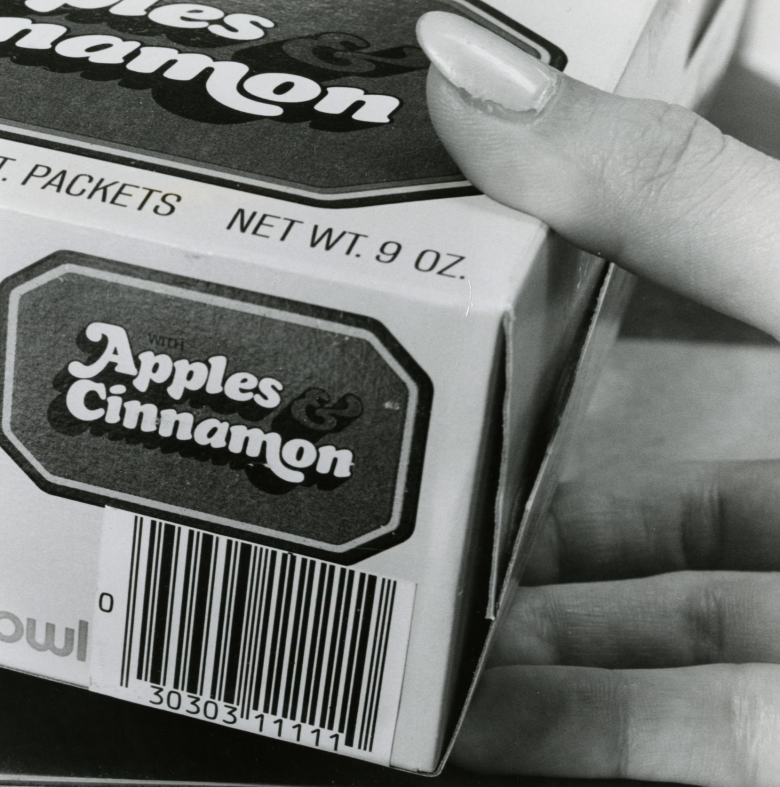
Дальше все по классике. Летом 1974 года тема попала в шоу Донахью, в декабре Сенат США провел симпозиум по универсальному коду товара, на открытиях магазинов стояли пикеты. К марту 1978 года уже шесть штатов приняли законы об обязательном ценнике на каждой единице товара, сканер там или не сканер.
Права потребителей были защищены, на переклейке магазины сэкономить не смогли. Но удобство полосатого идентификатора все равно оценили. В 1978 году сканеры стояли менее чем в одном проценте продуктовых магазинов США. К середине 1981-го — в десяти, к 1984-му — примерно в трети.
Помимо удобства для пробивки, штрихкоды принесли пользу там, где от них этого не ждали. В 1999 году PwC (PricewaterhouseCoopers, входит в четверку лучших аудиторов мира) оценила годовой эффект от UPC для продуктовой отрасли в 17 миллиардов долларов. Прогнозы 1970-х называли от 40 миллионов до полутора миллиардов, смотря кто и что считал. Разница все равно на порядок, а то и на два. Откуда?
Из данных.
Уже в январе 1980 года компания IRI запустила BehaviorScan, исследовательский сервис на данных кассовых сканеров. Магазины покупали сканеры, чтобы сэкономить на кассирах, а получили в руки инструмент аналитики, равного которому тогда просто не было. Да, в век наших «Честных знаков» это уже подзабылось, но ведь раньше с аналитикой магазинов были реальные проблемы. Откуда ее брать-то? А тут вам пропасть данных, после введения полосатого знака.
Двадцать знаков и потолок
Все бы хорошо, но есть проблема. Линейный штрихкод растет только в одну сторону — в длину.
Denso, о которой речь пойдет ниже, оценивала практическую емкость обычного штрихкода примерно в 20 буквенно-цифровых знаков. Можно, конечно, и больше, но тогда его не впихнуть ни на одну этикетку.
Первый очевидный ход — положить несколько штрихкодов друг на друга стопкой. Так появились стековые коды: Code 49 в 1987 году у Intermec, PDF417 у Symbol в 1991-м. Это все еще полоски, просто в несколько этажей, и лазерный сканер, если водить им по строчкам, их читает. Но тут стоит поставить себя на место этого сканера (как бы странно это ни звучало).
Лазерный сканер не видит картинку, он видит одну строчку. Луч бежит по коду, фотодиод меряет отраженный свет, и на выходе получается сигнал во времени: светло-темно-светло-темно.
Стековые коды вроде PDF417 — промежуточный вариант: данные уже разложены в две оси, но отдельные строки всё ещё можно последовательно считывать растровым лазером. А вот когда данные распределены по двум координатам как единая матрица, как в QR или Data Matrix, нужен приёмник, который видит плоскость целиком. То есть камера. А камере нужно решать совсем другую задачу: не «где тут края штрихов», а «где вообще на этой картинке код, как он повёрнут, где у него углы и какого размера клетка».
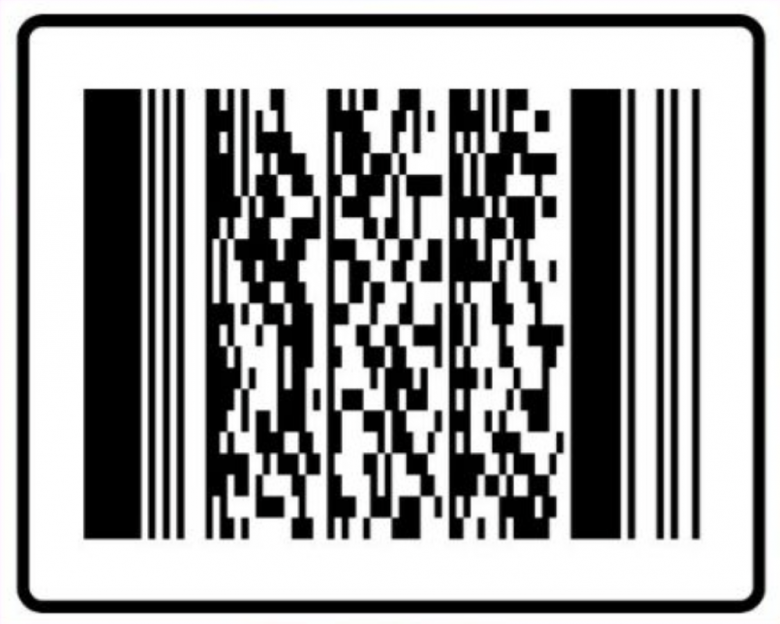
И это настоящая проблема. Добавление второй оси координат делает задачу кратно сложнее и требует куда более продвинутой техники. Впрочем, эта задача мало-помалу, но была решена.
Детальная маркировка
В начале 1990-х на отгрузке автокомпонентов в Denso (это поставщик группы Toyota, из нее же и выделившийся) на одну коробку с деталями клеили до десяти штрихкодов подряд. По 20 знаков каждый. Масахиро Хара, который потом придумал QR, вспоминал, что это было больше похоже на работу по чтению штрихкодов, чем на работу по производству деталей. А если коробку заляпали маслом, код не читался вовсе.
Задача сверху пришла простая: сделайте что-нибудь. Побольше данных, включая иероглифы, побыстрее чтение и чтобы не боялось грязи. Всего-то.
Команда — два человека, включая самого Хару. Срок — Хара пообещал начальнику два года, Denso в своей официальной истории пишет про полтора; начали в 1992-м, закончили в марте 1994-го.
В целом, сначала думали делать многоэтажный штрихкод. Однако Хара был большим любителем игры го. Он играл в нее в обеденный перерыв и именно оттуда ему пришла идея не про много этажей полос, а про черные и белые камни на сетке. Вот так и надо класть данные, такая матрица проще и экономичнее! И не поспоришь. Если бы не одна трудность.
Камера видит коробку, на коробке текст, логотип, полосатый скотч, старые этикетки. Как ей за долю секунды понять, где среди всего этого код? Нужна метка, которой в остальной печатной продукции не бывает.
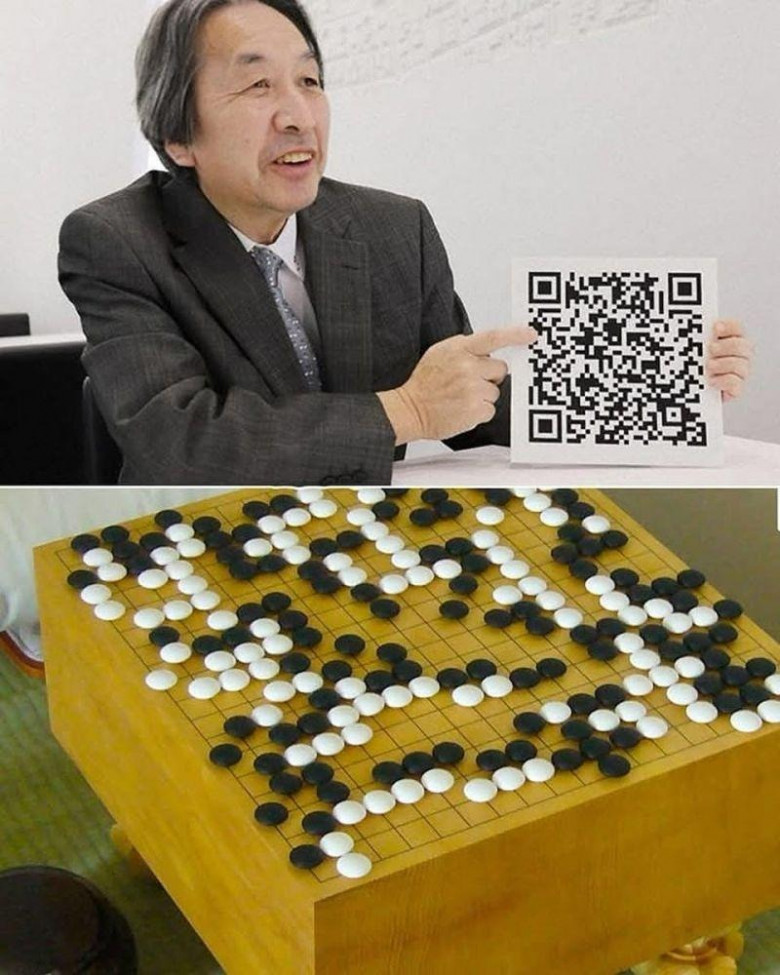
Хара говорил, что идея особой метки пришла ему при взгляде на здание из окна: верхние этажи выделялись другим расположением окон. Только метка должна быть простой, иначе ее долго распознавать: скажем, соотношение ширин, как в штрихкоде, но такое, какого в печати почти не бывает.
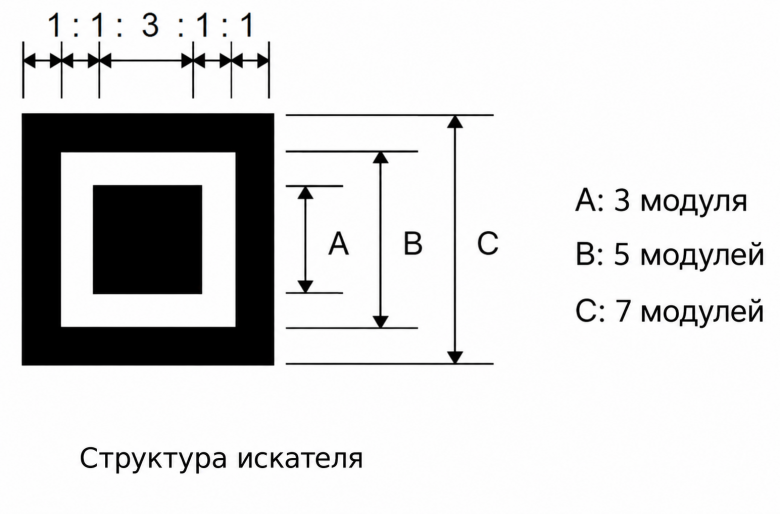
И дальше начинается совершенно нетипичная для «озарения» работа. Хара несколько месяцев фотографировал газеты, журналы, листовки, картонные коробки и гонял программу, которая считала соотношения ширин черного и белого. Самым редким в печати оказалось соотношение 1:1:3:1:1.
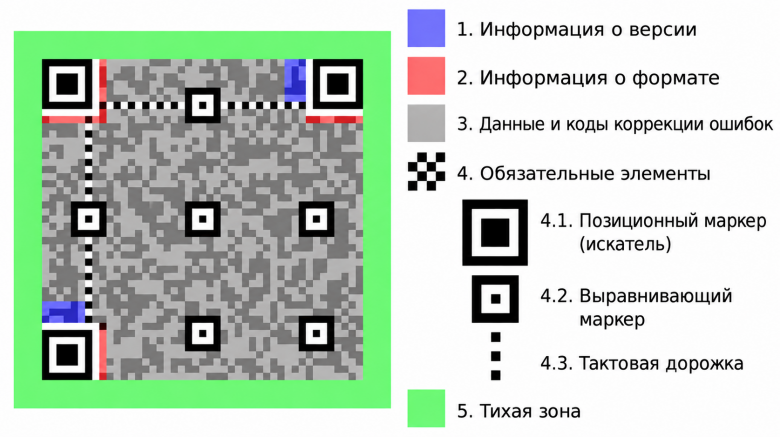
Посмотрите на любой QR. Три больших квадрата по углам — это оно и есть. Каждый квадрат — матрёшка: чёрная рамка в одну клетку, белый зазор в одну клетку и чёрная сердцевина в три клетки. Проведите через центр линию, хоть прямо, хоть по диагонали: чёрное, белое, чёрное, белое, чёрное, и длины отрезков всегда относятся как 1:1:3:1:1. Камера идёт по фотографии строчка за строчкой и высматривает пять отрезков подряд с этой пропорцией. Нашла три таких места — вот и углы кода, вот и его размер, вот и поворот.
Читался такой код, по данным Denso, более чем в 10 раз быстрее других кодов того времени. Отсюда, собственно, и имя: Quick Response, быстрый отклик. Не «много данных», а «быстро».
Скрытый текст
Denso патенты на QR получила, но пользоваться ими для стандартных кодов не стала. Логика простая и, на самом деле у японцев встречающаяся довольно часто: никто бы не стал пользоваться тем, что требовало лицензионных отчислений. Denso зарабатывала иначе. Компания делала считыватели, и ее новинка была способом продать больше сканеров.
Конечно, сканеры мог начать делать кто угодно, но разработка требовала времени, а у Denso уже все готово и пусконалажено.
Сами патенты на QR компания сохранила, но объявила, что не будет осуществлять патентные права в отношении стандартизованного QR Code. То есть пользоваться самим стандартом можно без лицензионных отчислений. А вот словосочетание «QR Code» — зарегистрированный товарный знак DENSO WAVE до сих пор.
Разбираем QR
Как работает QR? Про паттерн, за который цепляется камера, мы уже поняли, а что еще там есть? Давайте проследим работу камеры по шагам.
Шаг первый — найти тот самый паттерн. Для этого и нужны три больших квадрата по углам, те самые с соотношением 1:1:3:1:1. В обычной печати такое почти не встречается, поэтому если нашлось три таких места, это почти наверняка углы кода. По трём углам понятно, где код, какого он размера и как повёрнут. Четвёртого угла нет и понятно почему: раз квадрата три, а не четыре, у кода нет симметрии, и камера сразу знает, где у него верх. Читать можно вверх ногами или под углом — всё равно понятно. Квадраты, кстати, называются искателями.
Шаг второй — разбить картинку на клетки. Код состоит из модулей, маленьких квадратиков, чёрных и белых, и камере нужно знать, сколько их по стороне и где проходят границы между ними. Для этого от угловых квадратов друг к другу идут две дорожки из чередующихся чёрных и белых клеток: одна по горизонтали, одна по вертикали. Это линейка или тактовая дорожка. Посчитав клетки на дорожке, программа узнаёт размер сетки, а по их положению — где именно на фотографии каждая клетка, даже если бумага помята или снята под углом. В кодах побольше внутри стоят ещё маленькие квадратики с точкой в центре, для той же цели: по ним сетка подправляется на изгибах.
Шаг третий — прочитать данные. Рядом с угловыми квадратами лежат 15 клеток служебной информации: два бита говорят, какой уровень коррекции ошибок использован, три — какая из восьми масок наложена (об этом чуть ниже), остальные десять защищают эти пять от порчи. Записана эта информация дважды, в двух разных местах, на случай если одно замажут. Прочитав её, программа знает, как раскладывать остальные клетки. Дальше она идёт по коду змейкой парами столбцов справа налево: сначала снизу вверх, затем сверху вниз и так далее. Клетки читаются как биты: чёрная — единица, белая — ноль. Восемь клеток — байт. Из байтов собираются данные: сначала четыре бита «в каком режиме записано» (цифры, буквы с цифрами, байты, иероглифы), потом длина, потом сами данные.
Про маску. Представьте, что данные так легли, что получилось большое белое пятно. Или, того хуже, случайно сложилась пропорция 1:1:3:1:1 где-нибудь посреди кода: камера решит, что это четвёртый угол, и всё поехало. Чтобы этого не произошло, перед печатью данные «размешивают»: накладывают на них одну из восьми шахматных или полосатых масок, переворачивая цвет клеток по определённому правилу. Из восьми вариантов выбирают тот, где меньше всего длинных однотонных полос, сплошных квадратов 2×2 и ложных углов, а общая доля чёрных модулей ближе к 50 процентам. Номер выбранной маски и записан в тех трёх битах. Камера, прочитав номер, накладывает ту же маску ещё раз и получает исходные клетки. По сути, это просто договорённость: «я перемешал по правилу номер 5, ты перемешай обратно, и всё вернётся».
И еще. QR-код должен быть обрамлен в однотонную рамку с цветом, контрастным черному. Это защитный интервал или, в терминологии QR «тихая зона» (Quiet zone). Нужна для более четкой работы сканера. Маркетологи обожают подрезать эту зону или раскрашивать ее в цвет, похожий по контрасту на черный, и этим сильно путают электронику.
Шаг четвёртый, главный, — исправить ошибки. В коде всегда лежат не только данные, но и проверочные байты. Не путайте их долю с привычными 7, 15, 25 и 30 процентами: эти числа обозначают примерно, какую долю повреждённых кодовых слов может восстановить уровень L, M, Q или H, а количество проверочных байтов зависит от версии и уровня коррекции. Считаются они по методу Рида — Соломона, опубликованному в 1960 году. Если очень грубо, идея такая. Через две точки проходит одна прямая. Если передать не две точки, а пять точек той же прямой, приёмник может потерять любые три и по оставшимся двум всё равно провести прямую. Больше того, если одна из пришедших точек соврала и не лежит на одной прямой с остальными, это видно, и её можно выкинуть. Рид и Соломон делают то же самое, только вместо прямой — кривая посложнее, а вместо точек — байты. Данные задают кривую, проверочные байты — лишние точки на ней. Это, конечно, только геометрическая аналогия: в настоящем QR вычисления идут с многочленами над конечным полем GF(256).
Есть у этого метода одно слабое место: он исправляет отдельные испорченные байты. А условная клякса на QR выкинет не отдельные байты, а сразу их группу. Поэтому в кодах побольше данные делят на несколько блоков и печатают вперемешку: байты первого блока, второго, третьего, снова первого. Пятно кофе задевает все блоки понемногу, и каждый исправляется своим запасом проверочных байтов.
Вот, собственно, и весь QR.
Семь тысяч цифр мелким шрифтом
Какова ёмкость QR? Вроде пишут, что он вмещает 7089 цифр?
Вмещает, да. Но это версия 40 — самый большой QR, 177×177 модулей, при самом слабом уровне коррекции L.
Версий всего 40: первая — 21×21 модуль, каждая следующая на четыре модуля больше. При обычном модуле в 0,33 мм версия 40 — это квадрат со стороной почти 6 сантиметров. Ооочень удобно на визитке [сарказм]. Печатают такое, понятно, редко.
Реальный QR со ссылкой на сайт — это версия 2 или 3. Ссылка в 30 байт при уровне коррекции L укладывается в версию 2, 25×25 модулей. При уровне M, который по данным Denso выбирают чаще всего, уже нужна версия 3, 29×29.
Коррекция ошибок тут на высоте. Четыре уровня коррекции — L, M, Q, H — дают примерно 7, 15, 25 и 30 процентов, и Denso честно уточняет, что это доля от общего числа кодовых слов, а не от площади картинки.
В версии 1, например, всего 26 кодовых слов по 8 бит. При уровне L из них 19 — данные и 7 — проверочные, и исправить такой код может всего 2 испорченных слова. При уровне H — 9 слов данных и 17 проверочных, исправляются 8. То есть две трети места мы отдаем за право потерять треть.
А теперь то, чего процент не покрывает. Рид — Соломон защищает кодовые слова, то есть область данных. Искатели и тактовая дорожка им не защищены никак (у поля формата, помните, свой маленький код BCH и дубль). Поэтому обещанные 7–30 процентов не означают, что можно безнаказанно вырезать такую же долю из любого места QR. Небольшое повреждение искателя детектор ещё может стерпеть, но если серьёзно разрушить один из больших угловых квадратов, стандарт уже не гарантирует обнаружение кода и вероятность чтения резко падает.
Это, кстати, объясняет, почему логотип посреди небольшого QR обычно работает: логотип отъедает часть данных из бюджета коррекции, а углы не трогает.
Пятнадцать лет без сканера
Итак, QR готов в 1994 году. Бесплатен с 1996-го. Стандартизован в 2000-м. Почему же в Европе и Америке он «выстрелил» только в пандемию, через четверть века?
Тут встал вопрос, который мы задавали выше. А чем вообще считывать эту двумерную матрицу? Понятно, что были специализированные устройства, но для настоящей популярности вне торговли нужно было что-то, что под рукой у многих пользователей. Например, телефон.
В Японии первым телефоном с чтением QR стал Sharp J-SH09 для оператора J-Phone, август 2002 года. Уже в феврале 2005-го опрос Infoplant среди почти десяти тысяч пользователей i-mode показал, что 53,8 процента хотя бы раз пользовались QR-кодами. Половина! 2005 год!
США и Европа тут отстали. И «отстали» – это еще очень слабый термин. iPhone научился распознавать QR штатной «Камерой» только в iOS 11, 19 сентября 2017 года. Между J-SH09 и iOS 11 — 15 лет. На Android у Google штатное чтение из камеры пришло с Pixel 3 в 2018-м, у остальных производителей — кто когда.
И все эти годы код был совершенно тот же. Не было толкового приемника.
А вот к пандемии он впервые оказался у всех в кармане в виде, который не требует ничего скачивать.
Квадратик с уголком
Data Matrix часто путают с QR или даже считают его каким-то частным случаем последнего. Это, на мой взгляд, несправедливо. Во-первых, он старше QR. Во-вторых, устроен принципиально иначе.
Заявку на патент Деннис Придди и Роберт Цимбальски подали 5 мая 1988 года, патент выдан 3 июля 1990-го. И уже в самой заявке описана фирменная конструкция: две сплошные стороны и две стороны из чередующихся темных и светлых клеток. Компания-разработчик с тех пор несколько раз перепродавалась, а символику отдали в общее пользование — с осторожной оговоркой «в той мере, в какой это нужно для отраслевых стандартов».
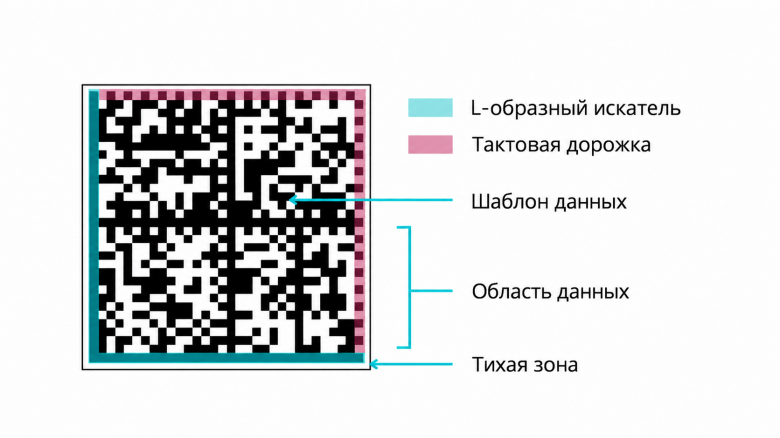
Посмотрите на любой код «Честного знака» внимательно. Слева и снизу — сплошная черная линия, буквой L. Сверху и справа — пунктир, черная-белая-черная-белая. Вот, собственно, и весь «искатель».
Сплошной уголок говорит камере, где код, как повернут и не искажен ли. Пунктирная рамка — тактовая дорожка: по ней декодер считает, сколько в коде строк и столбцов и какого размера клетка. Все то же, что у QR, преамбула плюс тактовая, только потрачен на это не три квадрата с дорожками, а один периметр.
Ноль служебных клеток внутри. Почти. У крупных символов внутри появляются дополнительные дорожки, но молочного 20×20 это не касается.
Внутри — тот же Рид — Соломон, но с одним важным отличием: уровень коррекции здесь выбирать нельзя. Он просто зашит в размер. В Data Matrix ECC 200 (единственная версия, которую сегодня используют) размеры только четные: от 10×10 до 144×144, плюс прямоугольные от 8×18 до 16×48, а с 2020 года еще и пачка вытянутых прямоугольников по отдельному стандарту ISO/IEC 21471, под ампулы. И у каждого размера своя фиксированная пара «данных плюс проверочных».
У крохотного 10×10 всего 8 кодовых слов: 3 данных и 5 проверочных, 62,5 процента избыточности. У 24×24 — 36 и 24, 40 процентов. У крупных — около 28. У самого большого, 144×144, 1558 слов данных и 620 проверочных в 10 перемежающихся блоках. Максимум влезает 3116 цифр или 1555 байт, то есть вдвое меньше, чем в QR версии 40.
Момент. Получается, что квадратик с уголком проигрывает по емкости? Не совсем…
Почему маленький Data Matrix выигрывает на маленькой упаковке
Давайте посчитаем. Код маркировки на пачке молока — это 30 символов плюс один служебный разделитель. Возьмем те же 31 символ и закодируем двумя способами. В Data Matrix они укладываются в символ 20×20, с тихой зоной в один модуль — 22×22. В QR при уровне M и нормальной сегментации числовых и байтовых участков достаточно версии 2, 25×25 модулей, а с тихой зоной в четыре модуля — 33×33.
Площадь: 484 клетки против 1089. QR занимает примерно в 2,25 раза больше площади.
И это при том, что Data Matrix 20×20 может восстановить около 22 процентов своих кодовых слов, почти как QR на уровне Q (не спрашивайте, зачем на йогурте столько, так уж устроен размер). Тот же код, тот же Рид — Соломон, а занимаемая площадь — более чем вдвое меньше. Просто потому, что три искателя и четыре модуля тихой зоны у QR при небольших данных стоят очень дорого.
Для плаката это, в общем, без разницы. Для крышки йогурта, для ампулы, для блистера с таблетками — разница огромная: тот же объём данных занимает заметно меньшую площадь.
GS1 на вопрос, почему для медицины рекомендован именно GS1 DataMatrix, а не QR, отвечает примерно так же: больше данных на меньшей площади, возможность маркировать мелкие инструменты прямо по металлу и то, что в фарме Data Matrix уже внедряли задолго до того, как GS1 вообще одобрила QR. Плюс принцип «один символ на упаковке», потому что два разных кода на лекарстве — это риск перепутать.
Европейский регламент 2016/161 требует на лекарстве Data Matrix ECC 200 с качеством печати не ниже 1,5 по ISO/IEC 15415; основная дата начала применения — 9 февраля 2019 года. Италия и Греция воспользовались переходным периодом до 2025-го, а Бельгия присоединилась к системе с 2019 года. Для GS1 DataMatrix на этикетках регулируемой медицинской продукции GS1 задаёт размер модуля примерно от 0,254 до 0,495 мм, целевой — 0,380 мм. Диапазон до 0,615 мм с целевыми 0,300 мм относится уже к отдельным сценариям прямой маркировки изделий, а не к обычной этикетке лекарства.
Честный-честный знак
Как вы уже знаете, для «Честного знака» в нашей стране выбрали именно Data Matrix. Но не простой.
От обычного Data Matrix он отличается служебным символом FNC1 в самом начале. Сканер, увидев его, отдает кассе строку с идентификатором ]d2 (если, конечно, сканер настроен передавать этот идентификатор), и касса понимает, что дальше идут поля GS1 с идентификаторами применения. Поля переменной длины разделяются символом GS — кодом 29 (0x1D) ASCII. Постановления правительства, кстати, воспроизводят это почти дословно, вплоть до фразы «с использованием FNC1 как признака символики».
Для молока по постановлению 2099 от 15 декабря 2020 года код такой: (01) и 14 цифр кода товара, (21) и 6 символов серийного номера, разделитель, (93) и 4 символа кода проверки. Итого 30 знаков плюс разделитель — те самые, что я считал выше. Это для товара фиксированного веса; у весового сыра к ним добавится еще масса, и код подрастет. Модуль — от 0,255 миллиметра, рекомендованный размер символа 20×20, качество печати не ниже класса 1,5 по ISO/IEC 15415.
Обратите внимание на длину кода проверки: 4 символа. Это короткий криптографический код проверки, который используется системой для проверки подлинности кода. Сам по себе четырёхсимвольный хвост — не цифровая подпись в привычном смысле. И вот тут самое интересное.
У лекарств этот хвост изначально был 88 символов. 88!
По отчету об испытаниях на 34 площадках, о котором писала «Российская газета», при подписи в 88 символов более чем в 80 процентах испытаний брак составлял десятки процентов, а кто-то вообще не смог нанести код. «Акрихин» при 88 символах и скорости 350 упаковок в минуту получил 78 процентов брака, а при 32 символах — 0,1 процента. Не в два раза, не в десять. В 780.
Не влезло.
Постановление 1118 от 30 августа 2019 года сократило код проверки лекарств до 44 символов. По моему очень грубому расчету с 88 символами весь код лекарства ложился в Data Matrix 40×40, а то и 44×44, смотря что попадется в подписи, а с 44 — в 36×36.
Отрасль и 44 считала многовато и просила еще короче. Но на тех же тестах 32-символьный вариант полностью прошел лишь в двух третях попыток. Остановились на 44. А у «быстрых» групп вроде молока и табака сразу сделали короткий 4-символьный код проверки, а проверку подлинности перенесли на сервер. Касса спрашивает у системы, а не проверяет подпись сама.
Табачная пачка — вообще отдельный случай. На ней стоит не GS1 DataMatrix, а обычный Data Matrix без идентификаторов применения и без FNC1: постановление 224 от 28 февраля 2019 года прямо делает для сигарет исключение. Четыре группы подряд: 14 цифр кода товара, 7 символов серийного номера, 4 символа максимальной розничной цены в перекодированном виде и 4 символа кода проверки. Всего-то 29 знаков.
Цена в четырех символах — это число копеек по основанию 80, записанное цифрами, латинскими буквами и спецсимволами. Так что если вам скажут, что «в штрихкоде цены не бывает», то в этом российском коде она таки есть. Правда, это не цена конкретной продажи, а установленная максимальная розничная цена, закодированная прямо в средстве идентификации.
Теперь сложите все вместе. 1973 год: форму кода выбрала печатная машина. 1993-й: форму метки выбрала статистика типографской продукции. 2019-й: длину кода выбрал струйный принтер на линии, который не тянул 88 символов при 350 пачках в минуту.
Емкость каждый раз стояла в очереди второй. Или третьей.
Немного про считки
Лазерный сканер, как мы выяснили, видит одну строчку и матричный код прочитать не может в принципе. Стековые коды растровым лазером еще можно, матричные — только имиджером, то есть камерой с процессором.
Первые ручные имиджеры появились в конце 1990-х (Welch Allyn IMAGETEAM 4400, например, по спецификации 1998 года), но в рознице они долго были экзотикой. Маркировка все перевернула. Чек по маркированному товару должен содержать реквизит «код товара», из полосок его не взять, и 2D-сканер на каждой кассе стал обязательным де-факто.
С экраном телефона у лазера тоже все плохо, но по другой причине. Экран, в отличие от бумаги, почти не рассеивает луч: назад прилетает в основном зеркальный блик от стекла, одинаковый над светлым и темным пикселем, а у старых ЖК еще и поляризаторы съедают отражение. Для лазера светлые и темные пиксели выглядят одинаково темными.
Имиджер с этим справляется, потому что снимает картинку, а не измеряет отражение: увидел светящийся экран — приглушил подсветку и подстроил выдержку. А фокус с несколькими кадрами и подсветкой с разных сторон — это уже для бликующего металла и глянцевых банок. Поэтому посадочный на экране телефона имиджером читается, а старым лазерным пистолетом — нет.
Ну и про молоко. В декабре 2022 года Союзмолоко оценивал долю кодов, которые не читаются на кассах, примерно в 2 процента; торговые сети говорили о более чем 10. Причины довольно прозаичные: мягкая упаковка, конденсат, код, напечатанный струйником на бегущей линии. Все то же, что в 1973-м, только вместо смазанной краски капли на пленке.
Сетям тогда даже готовили послабление: до 1 июня 2024 года продавать без сканирования кода не более 2 процентов месячного объема молочки. А с 1 апреля 2024-го поэтапно включили разрешительный режим: касса по каждому коду спрашивает у «Честного знака», можно ли его продавать. Сначала табак и пиво в кегах, с 1 мая — вода и молочка в сетях от 50 магазинов, с 1 сентября 2024-го — они же во всей рознице. Дальше по очереди пошли остальные группы.
Заключение
За полвека маркировка стала куда сложнее, но принцип не изменился: побеждает не маркировка, в которую можно запихнуть больше всего данных, а тот, который можно быстро и надёжно напечатать, считать и обработать в реальных условиях.
Поэтому для товарного номера когда-то хватило полос, для ссылок удобен QR, а для компактной поэкземплярной маркировки — Data Matrix. В итоге форму кода определяет задача.
Одна проблема… Когда на пачке молока есть и штрихкод, и QR, и Data Matrix — чёрт его знает, что вообще подносить к считывателю… Ой, простите — к имиджеру.
Размещайте облачную инфраструктуру и масштабируйте сервисы с надежным облачным провайдером Beget.
Эксклюзивно для читателей Хабра мы даем бонус 10% при первом пополнении.
