

Наступила эпоха, когда любая домохозяйка за несколько промптов поднимает себе CRM: фронтенд на JS, бэкенд на Go, данные в Postgres. И при этом не понимает ни слова из того, что я сейчас написал.
А куда заведёт кривая гика, который пятнадцать лет отдал коммерческой разработке ещё в доLLMную эпоху?
Дело было вечером, подписка на Claude Code простаивала, мысли вертелись. Перебирая прожитые годы, я вспомнил детскую мечту: написать свою операционную систему. Хорошую, чтобы всех радовала и приносила людям пользу. Как Windows, только лучше.
Windows из списка хороших систем я вычеркнул ещё в школе, вместе с синим экраном. Да и Linux перестал казаться идеалом, когда я начал считать микросекунды.
Что не так с Linux
В целом всё в порядке, сказал бы я, пока не начал плотно заниматься проектами в трейдинге.
Когда из железа надо выжать максимум и счёт идёт на микросекунды, тюнинг ОС превращается в попытку обойти все её механизмы, какие только получится. В идеале ОС запускает процесс, сажает его на выделенное ядро процессора и забывает о нём. В этой точке пути ОС и приложения расходятся.
Добиться такого очень трудно. Даже на изолированном ядре приложению всё равно нужны системные вызовы, примитивы синхронизации, часы, память, диск и сеть. За каждую из этих услуг ОС берёт плату, и ниже я разберу, из чего она складывается.
В специализированных торговых приложениях многое обходится программно: kernel bypass для сети, busy-poll вместо сна, свои аллокаторы, свои часы. Но 99.99-й перцентиль tick-to-trade это всё равно не спасает. Остаются прерывания, тик таймера, сброс TLB, соседи по кэшу и тяжёлый слой безопасности, который делает дороже каждый вход в ядро.
По сути всё это — борьба с ОС и срезание её функциональности снаружи. Справедливости ради, торговое приложение — очень узкий класс софта, и мы упорно запускаем его на ОС общего назначения. Отсюда боль и страдания.
Немного о базовой терминологии
Ядро процессора (core) — это главный физический вычислительный блок внутри центрального процессора (CPU), который отвечает за выполнение инструкций, расчеты и обработку данных. Ядро ОС (kernel) — программа, которая управляет железом и раздаёт его процессам. Дальше, где из контекста неясно, я буду писать «ядро CPU» и «ядро ОС».
Пространство пользователя и пространство ядра. Процессор умеет работать в разных режимах привилегий. Ваша программа работает в непривилегированном режиме (на x86 он называется ring 3) и не может напрямую трогать устройства или чужую память. Ядро ОС работает в привилегированном режиме (ring 0). Когда программе нужно что-то от железа — прочитать файл, отправить пакет, заснуть до события, — она делает системный вызов: специальная инструкция переключает процессор в ring 0 и передаёт управление ядру ОС. Это делается через системный вызов, или «сискол».
Латентность и перцентили. Среднее время ответа мало что говорит о сервере. Если 999 запросов из тысячи отвечают за 50 мкс, а один за 10 мс, среднее выглядит прилично, но тот самый медленный запрос рано или поздно достанется вашему клиенту. Поэтому смотрят перцентили: p99 — время, быстрее которого отвечают 99 % запросов, p99.9 — 999 из тысячи, p99.99 — 9999 из десяти тысяч. Всё, что выше p99, называют хвостами. Эта статья в основном про хвосты.
Формулируем задачу
А что если срезать лишнее не снаружи, а на уровне ядра ОС? Так, чтобы без приседаний быстро работали не только торговые роботы, но и обычные серверные приложения.
Допустим, наша база данных живёт в доверенном контуре. Снаружи периметр, внутри все сотрудники добрые и хорошие. Нужны ли тогда ядру ОС все механики защиты от злонамеренного кода?
А если база одна на виртуальную машину и других жильцов там нет? Зачем тогда пользователи, сессии и честное деление ресурсов между незнакомцами?
А с многопоточностью что? Поток, который ждёт мьютекс, по-хорошему должен проснуться от записи соседа в слово памяти, а не ждать, пока ядро ОС соизволит его разбудить.
Отсюда рамки:
Одно доверенное приложение (или его процессы) на виртуалку. Масштабируемся количеством ВМ, а не тысячей соединений на узел.
Защита от багов приложения остаётся: отдельное адресное пространство на процесс, W^X, guard-страницы, проверка указателей в сисколах. Защиты от враждебного кода нет, это работа внешнего периметра.
Совместимость с Linux ABI. Бинарники запускаются без пересборки: PostgreSQL, MariaDB, MongoDB, Redis, Clickhouse, nginx, JVM.
Цель — хвосты латентности, а не средняя пропускная способность.
Как это писалось
Руки сами потянулись к клавиатуре:
Дорогой Claude Code, напиши мне операционную систему. Чтобы хорошая была, быстрая, с Linux ABI совместимая, и…
С первого захода я не получил того, чего хотел. С пятого и с десятого тоже. Пришлось садиться и писать полноценную спецификацию: мотивация, аналоги, архитектура, что обязано работать и как это проверить. Следующий промпт начинался так:
Извини, Claude Code, но пришло время для серьёзного разговора.
С этого момента дело пошло. Дальше было почти пять десятков рабочих сессий. Между сессиями агент ничего не помнит, поэтому каждая заканчивалась журналом: что сделано, что измерено, какие гипотезы убиты. Следующая сессия начиналась с его чтения.
Код и замеры делал агент. Моя часть — спецификация, выбор следующего шага, недоверие к хорошим новостям и решение, что считать доказательством. Последнее оказалось главным: агент пишет код быстро и уверенно и так же быстро и уверенно объясняет любую цифру. Несколько эпизодов, после которых в проекте появились правила.
Зелёный, но короче. Регресс отчитался «481 из 481, ошибок 0». Всё хорошо, только накануне проверок было 486: при сборке образа не скачался пакет, пять тестов тихо ушли в пропуск, а итоговая строка осталась зелёной. С тех пор смотрим не на слово «ноль ошибок», а на общее число проверок и сравниваем его с прошлым прогоном.
Тест, который не может упасть. Тест на гонку при создании разделяемой памяти проходил всегда. Потом выяснилось, что он не проверял ничего: окно гонки длилось микросекунды, потоки в нём ни разу не встретились, а вторичные ядра CPU вообще не поднялись. Теперь тест на гонку обязан доказать, что гонка была: в окно вставляется задержка, ядро ОС считает, сколько раз потоки реально столкнулись, и тест проверяет этот счётчик, а не только итог. Общее правило: тест, который не показал, что умеет падать, не тест.
Чужие 8 миллисекунд. Три сессии подряд мы объясняли класс хвостов по 8 мс на сервере и находили всё новые правдоподобные причины. Оказалось, что генератор нагрузки (он тоже работал на Talaria) никогда не засыпал, гипервизор отбирал у него ядро CPU на 8 мс, и эта пауза записывалась в хвост сервера. Когда генератор научили спать, событий длиннее 4 мс стало не 638, а ноль. Правило: если результат удивил, первым подозревается прибор.
Прибор раньше правки. Напрашивалась групповая фиксация журнала: собирать несколько
fsyncв одну транзакцию. Звучит разумно, и написать это заняло бы дни. Вместо этого сначала поставили счётчик: замок ФС брали 597 раз из 597 без ожидания, объединять было нечего. Правку убил один прогон стенда. Правило: никакой правки производительности, пока прибор не назвал долю проблемы числом. «Наверное, это тик» — не диагноз.Один бинарник, два ответа. Одно и то же ядро ОС, замеренное на двух подъёмах стенда, в одном случае проиграло три точки по медиане, а в другом ни одной. Ни строчка кода при этом не менялась. С тех пор класс проблемы существует, только если воспроизвёлся на двух подъёмах. На одном это всего лишь кандидат.
Таких правил набралось на отдельный документ, и в нём есть раздел для ИИ-агентов: одна задача — один коммит — один тест, сначала число, потом правка, сверяй итоги, а не вердикт, при сюрпризе подозревай прибор. Сейчас каждый коммит прогоняется через test.sh: ядро ОС несколько сотен раз грузится в QEMU и проверяет почти пятьсот утверждений.
Что получилось
Talaria — собственное ядро ОС для x86-64 на Rust (no_std, то есть без стандартной библиотеки: под ядром ОС нет другой ОС, которая дала бы файлы и потоки). Работает под QEMU/KVM, как AMI на EC2 и на голом железе (c6i.metal).
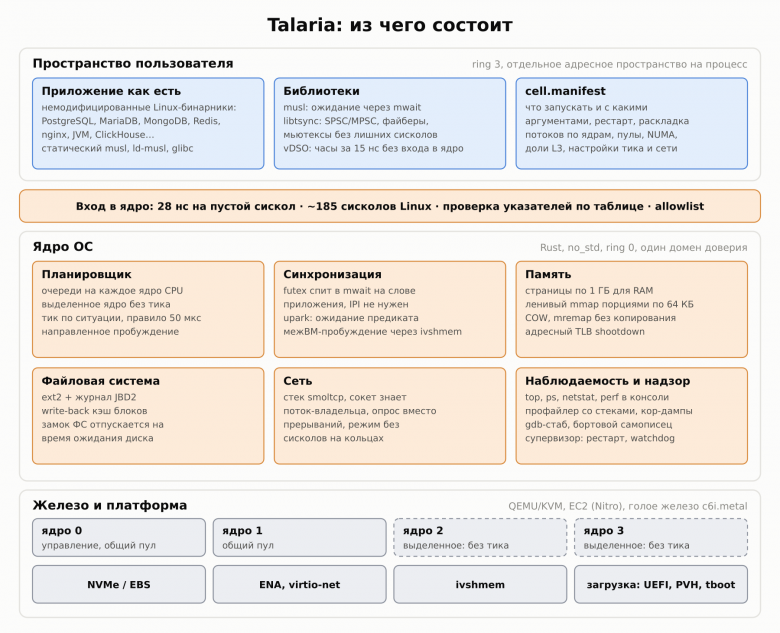
Одного трюка, который делает её быстрой, нет. Обычные издержки ядра ОС общего назначения убирались по одной, и каждая правка оставалась в коде, только если замер это подтверждал. Дальше по пунктам: как это устроено, где теряется время и что сделано у нас.
Системный вызов
Как устроено. Программа кладёт номер вызова и аргументы в регистры и выполняет инструкцию syscall. Процессор переходит в ring 0, ядро ОС по номеру находит обработчик, выполняет работу и возвращается инструкцией sysret. Само переключение режимов стоит несколько десятков наносекунд.
Где теряется время. В 2018 году нашли уязвимости Meltdown и Spectre: через спекулятивное исполнение процессора программа могла подсмотреть память ядра ОС. Заплатки дорогие. KPTI держит для пользовательского кода отдельную таблицу страниц, в которой ядра ОС почти нет, и на каждом входе в ядро и выходе из него таблицы переключаются. Retpoline заменяет косвенные переходы в ядре ОС на более медленную конструкцию, чтобы их нельзя было «натренировать». Сверху ещё seccomp, фильтр, который проверяет каждый вызов программой на BPF, и подсистема аудита. В сумме пустой сискол на Linux обходится в 50–150 нс.
Что сделано. Мы исходим из того, что приложение одно и ему доверяют, значит, прятать ядро ОС от него незачем. Нет KPTI, retpoline, seccomp и audit, диспетчер минимальный. Пустой сискол в Talaria стоит 28 нс против 50–150 нс у Linux с заплатками.
Одну проверку мы при этом оставили. Когда программа передаёт в сискол указатель на буфер, ядро ОС должно убедиться, что буфер действительно принадлежит программе, иначе кривой указатель заставит ядро писать куда попало. Проверка описана декларативной таблицей, «у этого вызова второй аргумент — буфер длиной из третьего», и стоит 7–14 нс только тем вызовам, у которых указатель есть.
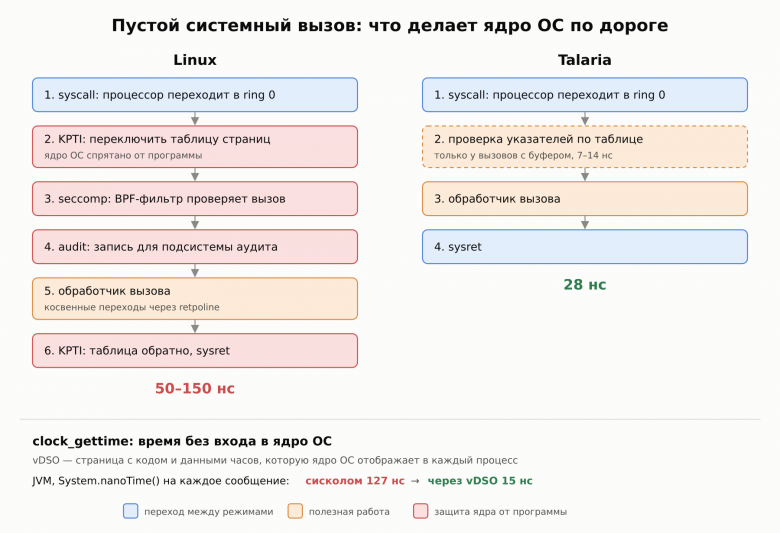
Часы. Узнать текущее время — тоже сискол, если не схитрить. Хитрость называется vDSO: ядро ОС отображает в память каждого процесса маленькую страницу с кодом и данными для часов, и clock_gettime читает время прямо оттуда, вообще не входя в ядро. В Linux vDSO есть давно, а в первых версиях Talaria его не было, и clock_gettime шёл честным сисколом за 127 нс. JVM вызывает System.nanoTime() на каждое сообщение и платила эту цену каждый раз. С vDSO clock_gettime стоит 15 нс, а System.nanoTime() в JVM — 52 нс против 65 у Linux.
Синхронизация потоков
Как устроено. Мьютекс в современных библиотеках построен на futex (fast userspace mutex). Пока за замок никто не борется, всё происходит в пространстве пользователя одной атомарной инструкцией, ядро ОС не участвует. Если замок занят, поток делает сискол FUTEX_WAIT с адресом слова-замка, и ядро ОС его усыпляет. Тот, кто отпускает замок, делает FUTEX_WAKE, и ядро ОС ставит спящего в очередь на исполнение.
Где теряется время. Пусть спящий поток жил на другом ядре CPU, и это ядро, пока было нечего делать, ушло в энергосберегающий сон. Чтобы его разбудить, ядро ОС посылает IPI (inter-processor interrupt) — прерывание с одного ядра CPU на другое. Разбуженное ядро CPU выходит из сна, обрабатывает прерывание, планировщик решает, кого запустить, и только тогда поток продолжает работу. Под гипервизором каждый IPI дополнительно выходит в гипервизор (VM exit), а это ещё микросекунды. В итоге от «отпустил замок» до «сосед проснулся» проходят единицы, а то и десятки микросекунд. Поэтому в трейдинге никто не спит, все крутятся в busy-poll и жгут ядра CPU на 100 %.
Что сделано. У процессоров x86 есть пара инструкций monitor/mwait. monitor говорит процессору «следи за этой строкой кэша», mwait усыпляет ядро CPU до тех пор, пока кто-нибудь не запишет в эту строку. Будит его само железо, без прерываний.
В Talaria ждущий поток засыпает в ядре ОС через mwait прямо на слове futex самого приложения. Когда другой поток отпускает замок, его обычная запись в это слово сама будит спящее ядро CPU, и IPI для этого не нужен. Стоковый musl после записи по привычке всё равно делает сискол FUTEX_WAKE, но к этому моменту спящий уже проснулся, и ядру ОС остаётся только отметить, что поток разбужен. Немодифицированный pthread из musl получает 165 нс на круг futex между ядрами CPU, а пока поток ждёт, загрузка его ядра CPU — 0 %. Мы получаем латентность busy-poll без сжигания ядра.
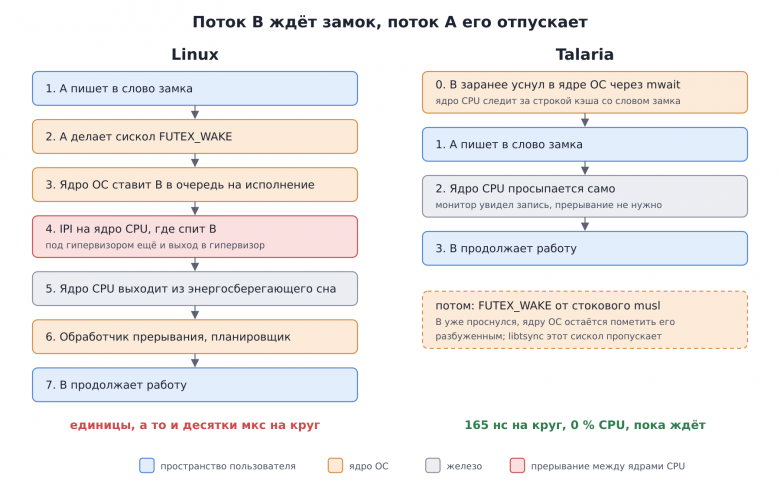
Если идти до конца, можно убрать и этот лишний сискол. Для этого в Talaria есть свой вызов ожидания: ядро ОС записывает в отдельное слово, как именно спит поток. Будящий читает это слово и делает FUTEX_WAKE, только если поток действительно уснул так, что запись в память его не разбудит. Этим пользуется наша библиотека libtsync.
На реальном приложении это выглядит так. Актор-фреймворк SObjectizer со стоковыми мьютексами и condition variable гоняет сообщение между акторами туда и обратно за 2,1 мкс (p50) на Talaria против 13,5 мкс на Linux в такой же виртуалке. Бинарник один и тот же, разница только в том, кто и как его будит.
Планирование и тик таймера
Как устроено. Потоков обычно больше, чем ядер CPU, и кто-то должен решать, кто сейчас работает. Этим занимается планировщик. Чтобы поток, который ушёл в долгие вычисления, не занял ядро CPU навсегда, таймер регулярно прерывает работу, это и есть тик. По тику планировщик решает, оставить текущий поток или переключиться на другой. Переключение контекста — это сохранение регистров одного потока и загрузка регистров другого, но главная его цена косвенная: новый поток приходит с холодными кэшами.
Где теряется время. Тик прерывает ваш запрос посреди обработки, даже если вытеснять некого. Обработка самого тика тоже не бесплатна, особенно под гипервизором, где обращение к контроллеру прерываний может стоить выхода в гипервизор. В Linux есть режим nohz_full, который убирает тик с выделенных ядер CPU, но у него хватает оговорок и настройка требует аккуратности.
Что сделано. Выделенное ядро CPU в Talaria не взводит таймер вовсе: одна задача, работа до конца, ноль вытеснений. На остальных ядрах CPU период тика зависит от того, что на них происходит. Где кто-то ждёт сеть, тик 100 мкс, потому что прерываний от сетевой карты нет и кадр увидит только тот поток, который его ждёт. Где вытеснять некого, 2000 мкс. В первых версиях Talaria обработка одного тика под KVM стоила 35 мкс, сейчас 2,3 мкс: паравиртуальные интерфейсы KVM для подтверждения прерывания, x2APIC, таймер по TSC и консоль, которую больше не опрашивают на каждом тике.
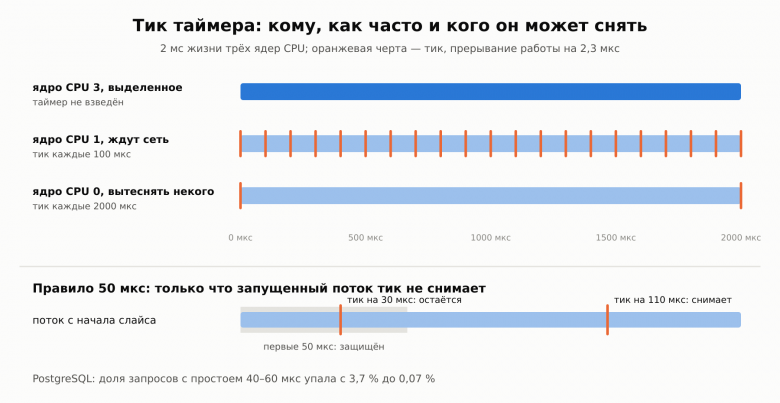
Важно не только как часто тикает, но и кого тик снимает. Если поток проработал меньше 50 мкс, тик не имеет права его вытеснить. Пока этого правила не было, тик снимал на PostgreSQL почти каждый только что разбуженный поток, и 3,7 % запросов простаивали по 40–60 мкс. С правилом таких запросов 0,07 %.
Раскладка по ядрам и общий кэш
Как устроено и где теряется время. Ядра CPU одного процессора делят общий кэш последнего уровня (L3). Если сосед прогоняет через себя гигабайты данных, он вымывает из L3 горячие данные вашего потока, и его промахи вдруг становятся вашей латентностью. Вторая беда — миграции. Балансировщик переносит поток на другое ядро CPU, и поток приходит туда с холодными кэшами. На машине с несколькими NUMA-узлами он вдобавок оказывается далеко от своей памяти.
Что сделано. Раскладка задаётся правилами в манифесте приложения, по именам потоков: этому потоку выделенное ядро CPU, этим — общий пул, потоки одного процесса держатся на одном NUMA-узле, прерывания сетевой карты не попадают на ядро CPU с горячим путём данных. Потоки без правила балансируются по реальной нагрузке и с гистерезисом. Поток, который спит на сокете, ядро не нагружает, поэтому в установившемся режиме миграций ноль.
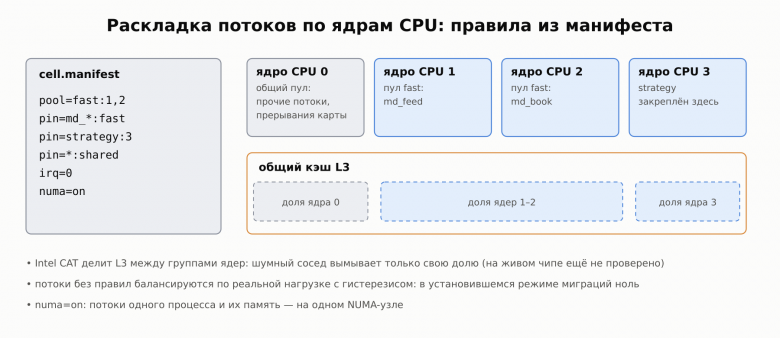
Для L3 в ядре ОС есть Intel CAT: кэш делится на доли между группами ядер CPU, и шумный сосед вымывает только свою долю. Честная оговорка: тесты проверяют логику, от манифеста до масок, но сама запись в регистры процессора на живом чипе ещё не проверена. CAT есть только у серверных Intel, а локальный KVM его гостю не отдаёт. Поэтому замеров с CAT в этой статье нет.
Память и TLB
Как устроено. Каждый процесс видит свои виртуальные адреса, а процессор переводит их в физические по таблице страниц. Таблица многоуровневая, обход дорогой, поэтому у процессора есть TLB — маленький кэш недавних переводов. Память выдаётся лениво: mmap только резервирует диапазон, а физическая страница появляется при первом обращении к ней через page fault. Это исключение, по которому процессор зовёт ядро ОС, и ядро ОС подкладывает страницу.
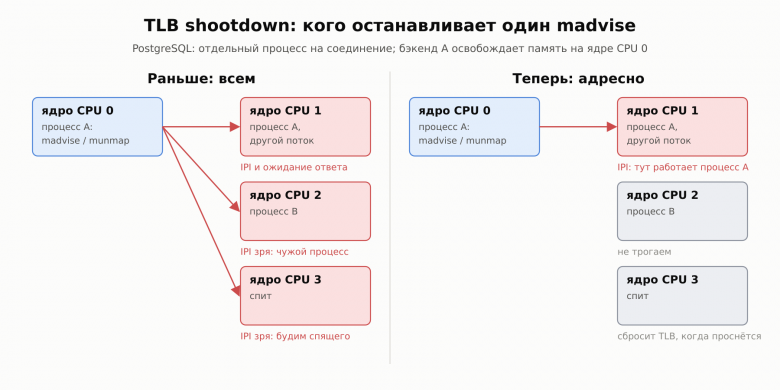
Где теряется время. Первое. Страница по умолчанию — 4 КБ, и программа, которая выделила гигабайт, получает сотни тысяч page fault’ов. Второе, менее очевидное. Когда процесс освобождает память (munmap, madvise), ядро ОС обязано убедиться, что ни одно ядро CPU не держит старый перевод в своём TLB. Для этого оно рассылает IPI всем ядрам CPU, где мог работать процесс, и ждёт подтверждения от каждого. Это называется TLB shootdown. Под гипервизором каждый такой IPI — выход в гипервизор, а промах TLB дороже вдвойне: гипервизор добавляет свой уровень трансляции адресов.
Что сделано. Сама память ядра ОС отображена страницами по 1 ГБ, поэтому TLB почти не тратится. В ранней Talaria mmap сразу выдавал физическую память на весь диапазон, и JVM с -Xmx256m занимала 874 тысячи кадров. Теперь mmap не выдаёт ни одного кадра до первого касания, а при касании материализует сразу 64 КБ. Та же JVM занимает 60 тысяч кадров, а page fault’ов в пятнадцать раз меньше, чем было бы при подкладке по одной странице в 4 КБ. TLB shootdown рассылается только тем ядрам CPU, которые прямо сейчас исполняют этот процесс, а спящее ядро CPU сбросит TLB само, когда проснётся. В ранней Talaria shootdown получали все ядра CPU. PostgreSQL держит отдельный процесс на каждое соединение, и тогда каждый madvise одного бэкенда останавливал три чужих ядра CPU.
Динамическая память: malloc, free, realloc
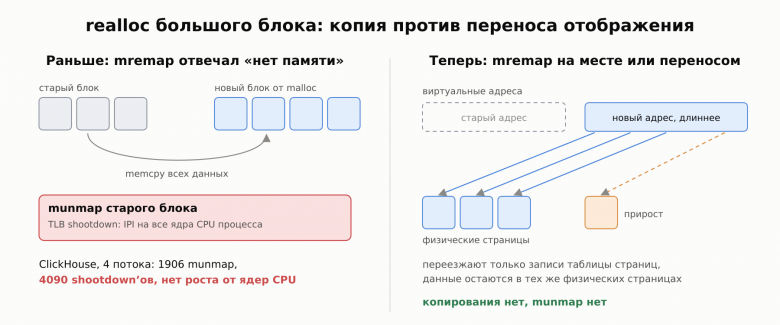
Как устроено. malloc — это не системный вызов, а код библиотеки в пространстве пользователя. Аллокатор держит у себя запас памяти и нарезает его на куски. Когда запас кончается, он просит у ядра ОС ещё: расширяет кучу через brk или берёт крупный кусок через mmap. free обычно оставляет память в запасе, но большие блоки аллокатор возвращает ядру ОС через munmap или madvise. realloc большого блока по возможности просит ядро ОС перенести отображение через mremap, не копируя данные.
Где теряется время. Каждая новая порция памяти — это page fault’ы при первом касании. Каждый возврат памяти ядру ОС — это TLB shootdown на все ядра CPU, где работает процесс. А если какой-то вызов не реализован, аллокатор молча откатывается на медленный путь, и программа работает, но медленнее. В Linux к этому добавляется управление нехваткой памяти: под давлением ядро ищет, что вытеснить, а прозрачные огромные страницы иногда требуют уплотнения памяти прямо посреди вашего malloc.
Что сделано. Своп и overcommit мы выкинули: RAM виртуалки — жёсткий бюджет, так что вытеснения нет вовсе. Свободные физические страницы выдаёт простой аллокатор (новые со «свободной вершины» плюс список возвращённых), и берутся они с того NUMA-узла, где работает поток.
Самый поучительный случай связан с realloc. В ранней Talaria mremap отвечал «нет памяти». Аллокатор не падал, а делал то, что делает в таком случае любая libc: выделял новый блок, копировал данные и освобождал старый. ClickHouse на четырёх потоках сделал 1906 таких munmap и получил 4090 TLB shootdown’ов. Именно там терялось ускорение от добавления ядер CPU. Теперь mremap растит и сжимает отображение на месте, а при переезде переносит записи таблицы страниц: физические страницы остаются где были, копирования нет.
Огромные страницы по 2 МБ включаются порогом: блоки крупнее заданного размера получают одну запись в таблице страниц вместо пятисот двенадцати. На аналитике это заметно: uniqExact в ClickHouse на Talaria без огромных страниц выполняется за 253 мс, с ними за 197. Но это не бесплатно: Redis на Talaria с тем же порогом терял 1,5 мкс медианы на лишних сбросах TLB по сравнению с запуском без огромных страниц. Поэтому по умолчанию порог стоит так высоко, что на практике огромные страницы выключены, и включает их тот, кому это нужно.
Файловая система
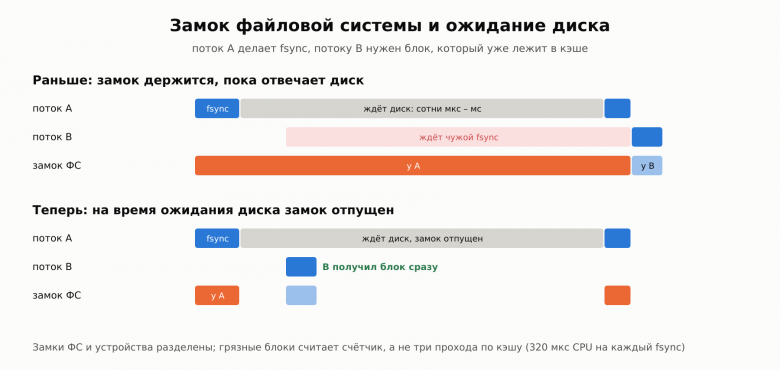
Как устроено и где теряется время. Диск медленный, поэтому запись попадает в кэш блоков в памяти и уходит на диск позже. Когда базе данных нужна гарантия, что данные переживут отключение питания, она вызывает fsync. Журнал защищает файловую систему от сбоя посреди записи: изменения метаданных сначала пишутся в него, потом на место. Время теряется на блокировках. Если замок всей ФС держится, пока диск отвечает, то поток, которому нужен уже закэшированный блок, ждёт чужой fsync, а на EBS это сотни микросекунд, а то и миллисекунды.
Что сделано. Свой ext2 с журналом JBD2 в ordered-режиме (данные пишутся на место раньше, чем фиксируется транзакция метаданных). Замок ФС и замок устройства разделены, и замок ФС отпускается на время ожидания диска. Грязные блоки считаются счётчиком, а не обходом: в ранней версии три полных прохода по кэшу на каждый fsync стоили 320 мкс чистого CPU. Журнал не держится на фазе записи данных. За серию этих правок p99.9 вставки в MongoDB на Talaria опустился с 4,3 мс до 0,44. Корректность проверяли выдёргиванием питания: на месте оказались 210 332 из 210 332 подтверждённых записей.
Сеть
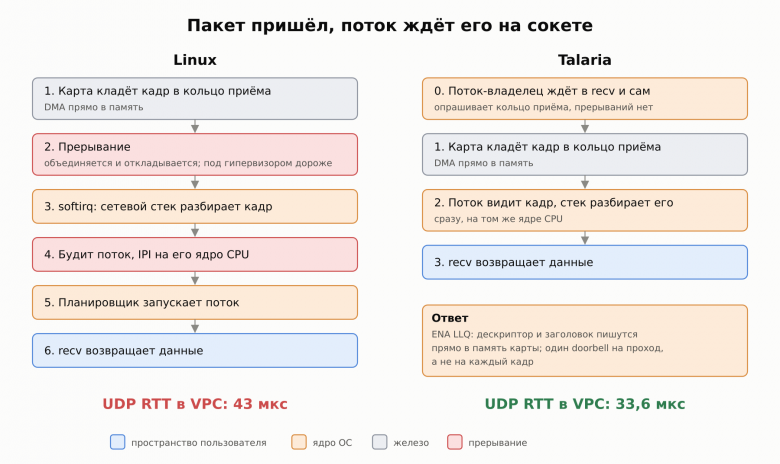
Как устроено и где теряется время. Карта и драйвер общаются через кольца дескрипторов в памяти: карта сама кладёт пришедшие кадры в буферы (DMA) и сообщает об этом прерыванием, а драйвер, отправляя кадр, пишет в регистр карты — «звонит в дверной звонок» (doorbell). Прерывание на каждый пакет дорого, поэтому Linux их объединяет и откладывает обработку, а это задержка. Запись в регистр устройства под гипервизором часто стоит выхода в гипервизор.
Что сделано. По умолчанию прерываний в сетевом пути нет, вместо них опрос: поток, который ждёт данные, сам смотрит в кольцо приёма. Звонки в doorbell пакетируются, один на проход, а не на каждый кадр. У каждого сокета есть владелец-поток, и стек будит именно его, а не всех подряд. На EC2 драйвер ENA работает в режиме LLQ: дескрипторы и заголовок кадра пишутся прямо в память устройства. UDP RTT — 33,6 мкс против 43 у Linux на том же пути VPC. Для совсем жадных есть режим без сисколов: приложение опрашивает кольца в общей памяти и в ядро ОС не входит вообще.
Наблюдаемость
Своя ОС — это ещё и своё отсутствие top, perf и gdb. Пришлось написать. Счётчики висят на событиях, которые происходят и так: переключение, сискол, page fault, и стоят по одному атомарному инкременту. В консоль ядра ОС встроены top, ps, netstat и perf. Есть семплирующий профайлер, который снимает стек на тике, кор-дампы, которые открывает обычный gdb, и gdb-стаб для отладки живой системы. ОС становится частью программы, которую можно отлаживать и профилировать вместе с приложением.
В чём Linux оказался действительно хорош
В планировщике. Сделать быстрым сискол или futex оказалось сравнительно просто: убираешь лишнее, меряешь, радуешься. С планированием так не выходит. Кого снять с ядра CPU, когда, кому отдать освободившееся ядро, когда забрать работу у перегруженного соседа (это называется work stealing) — каждое из этих решений по отдельности тянет на неделю замеров, и правильный ответ для PostgreSQL оказывается неправильным для MariaDB. Пара настроек планировщика, которая на Talaria убрала хвост MongoDB в 20–70 раз, на той же Talaria сделала MariaDB на 16–22 % хуже, чем без неё. Поэтому у нас эти величины живут в манифесте конкретного приложения, а не в глобальных настройках.
Больше всего оставшихся хвостов рождалось именно здесь, а не в «медленном коде». Пример: в одной из версий Talaria work stealing переворачивал перекос нагрузки вместо того, чтобы его сгладить, и сообщение между акторами стало стоить 25 мкс вместо прежних 1,5. С тех пор кража, которая не улучшает баланс, запрещена правилом. Linux шлифует эти эвристики тридцать лет, и это чувствуется.
Против Linux на реальных нагрузках
Стенд: четыре c6i.xlarge в одной зоне AWS. Сервер Talaria и сервер Linux, у каждого свой генератор нагрузки, по два ядра CPU на нагрузку с обеих сторон.
Сравнивать с Linux «из коробки» было бы нечестно: любую победу тогда можно списать на лень оператора. Поэтому Linux (Amazon Linux 2023) настроен на минимальную латентность всем, что есть в арсенале: профиль tuned latency-performance, nohz_full и rcu_nocbs на ядрах нагрузки, без глубоких C-состояний, idle=poll, busy-poll в сокетах, выключенные audit и NMI watchdog. Защита от Spectre и Meltdown тоже выключена (mitigations=off). Для безопасности это дорого, зато это лучшее, что Linux может показать по латентности. Так что разница в табло получена не за счёт KPTI из раздела про сисколы.
Как мерить, тоже важно. Наивный генератор отправляет запрос, ждёт ответ и только потом шлёт следующий (закрытая петля). Если сервер замер на 10 мс, генератор замер вместе с ним, и в статистику попадает один медленный запрос вместо сотни, которые должны были прийти за это время. Эту ловушку называют coordinated omission. Наш генератор работает в открытой петле: расписание запросов задано заранее и не подстраивается под ответы, поэтому медленный сервер не спрячет хвосты за паузами генератора. Темп поднимается лесенкой от потолка, общего для обеих систем. Точка засчитывается, только если нет перегрузки, генератор не отстал от расписания, разница больше собственного шума стенда и перцентиль подкреплён достаточным числом запросов.
Шесть серверов, все запущены без модификаций:
нагрузка |
что нагружает |
|---|---|
Redis |
сеть и epoll, один поток |
nginx |
сеть и epoll, ФС |
mongoose |
то же на другой реализации HTTP |
PostgreSQL 16 |
fork, сигналы, разделяемая память, ФС (процесс на соединение) |
MariaDB 10.11 |
потоки, InnoDB, ФС (поток на соединение) |
MongoDB 4.0 |
динамический ELF, mmap, WiredTiger |
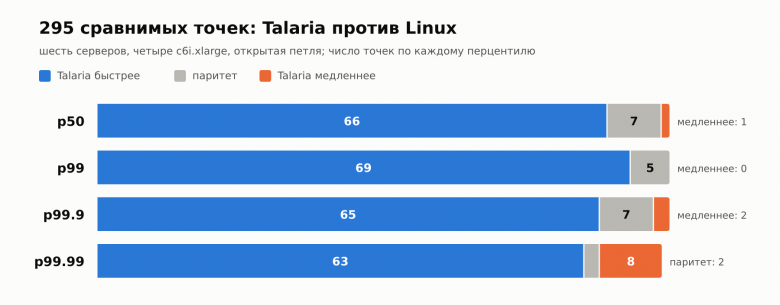
Итог по 295 сравнимым точкам:
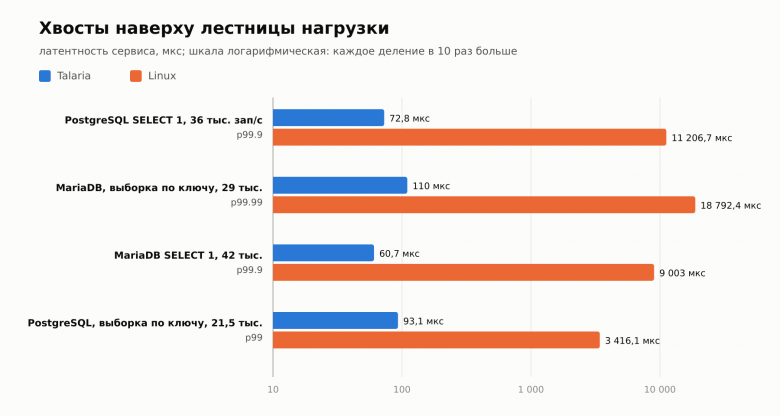
Форма результата везде одна и та же. Наверху лестницы Linux проваливается в миллисекундные хвосты, а Talaria остаётся в десятках микросекунд. PostgreSQL SELECT 1 на 36 тысячах запросов в секунду: p99.9 72,8 мкс против 11 206. MariaDB, выборка по ключу на 29 тысячах: p99.99 110 мкс против 18 792. Ради этого всё и затевалось: не медиана, а то, что происходит с хвостом под нагрузкой.
Проигранные точки разобраны поимённо. Пять точек MariaDB на p99.99 — не наш код. Виртуальное ядро CPU в облаке — это поток на хосте, и гипервизор иногда отбирает у него физическое ядро на несколько миллисекунд (это называется steal time). 97 % дыры оказалось именно таким временем, и в следующем табло этот класс без единой правки кода переехал на другую нагрузку. Две точки вставки в MongoDB объясняются тиком, который снимает поток посреди запроса. Оба очевидных лечения были написаны, замерены и отвергнуты. Остальное — граница точности судейства (1,05 при пороге 5 %) и классы, которые не воспроизвелись на втором подъёме.
Не все нагрузки попали в табло. Остальные мерили отдельно, и там картина пёстрее. OpenJDK 21 без модификаций против Linux на том же железе: пробуждение потока через LockSupport 2,19 мкс против 5,81, опоздание пробуждения после parkNanos(1 мс) на p99 44 мкс против 275, очередь сообщений 5,3 млн сообщений в секунду против 2,8. Но там, где JVM упирается в память (решето, активная аллокация), Talaria отстаёт на 10 и 26 %. ClickHouse в основном вровень с Linux: на четырёх ядрах CPU 7 запросов из 12 в паритете, три проигрывают 7–17 %, а на двух ядрах всё заметно хуже. С огромными страницами GROUP BY по 100 тысячам ключей занимает 197 мс против 236 у Linux, а uniqExact — 197 против 188. Отдельно для трейдинга мерили конвейер tick-to-trade на голом железе с картой Intel 82599: приём кадра, стратегия, шифрование заявки и отправка занимают в среднем 620 нс, из них около 200 нс уходит на AES-GCM. Здесь сравнения с Linux нет: это путь в обход сетевого стека, и честного аналога на той же машине мы не собирали. Вывод: Talaria выигрывает там, где время уходит на ожидание, пробуждения и вход в ядро ОС. Где программа упирается в вычисления и память, ядру ОС выигрывать нечем, и там Talaria в лучшем случае идёт вровень с Linux.
Чем пришлось заплатить: 64 TCP-сокета и 192 задачи на машину, около 185 реализованных сисколов вместо всего Linux ABI и узкий набор драйверов. Сетевой стек один на машину и защищён одним замком: если много потоков одновременно делают сетевые вызовы, они толкаются на этом замке. Это ОС «одна ВМ на сервис», а не «тысяча соединений на узел», и стоит она за внешним периметром безопасности.
В сухом остатке
собственное ядро ОС на Rust, x86-64: QEMU/KVM, EC2 (свой UEFI-стаб, ACPI, PCIe, ENA, NVMe), голое железо;
совместимость с Linux ABI: статический musl, динамические ELF через ld-musl, glibc. Работают PostgreSQL, MariaDB, MongoDB, Redis, nginx, OpenJDK 21, ClickHouse, SQLite, Lua, busybox;
модель процессов: отдельное адресное пространство, fork с copy-on-write, execve, сигналы, пайпы, разделяемая память, vDSO;
синхронизация без busy-spin: futex на
mwait, библиотека libtsync (SPSC/MPSC-очереди, файберы с переключением за 11 нс), пробуждение между ВМ через ivshmem за 496 нс;раскладка по ядрам CPU через манифест: выделенное ядро, пул, NUMA, доли L3 через Intel CAT;
свой ext2 с журналом, NVMe с настоящей глубиной очереди, проверка выдёргиванием питания;
сеть: ENA с LLQ, virtio-net, режим без сисколов;
супервизор с рестартом и watchdog, allowlist сисколов, W^X, guard-страницы;
top/ps/netstat/perfв консоли, профайлер со стеками, кор-дампы, gdb-стаб, бортовой самописец;утилиты
talaria-check(совместим ли ваш бинарник и каких сисколов ему не хватает) иtalaria-pack(собрать загрузочный образ).
Если хочется потрогать, начните с практикума HANDS-ON-GUIDE.md. Там по шагам собирается многопоточное C+±приложение, запускается под Talaria, раскладывается по ядрам CPU, профилируется, отлаживается вживую и разбирается по кор-дампу, а в конце уезжает на EC2. Запуск своих и опенсорсных приложений описан в USER-GUIDE.md.
Тем, кто хочет контрибьютить, — DEVELOPMENT-GUIDE.md: архитектура, карта модулей, рецепты, инварианты ядра ОС.
А самое ценное, на мой взгляд, — ENGINEERING-NOTES.md. Это настольная книга разработчика ОС, выжатая из всех итераций: в какие ловушки мы наступили, какие правила оплачены потерянными днями, как отличить замер от самообмана и как написать тест, который не умеет врать. Она одинаково пригодится и человеку, и агенту, который сядет писать свою ОС.
Что дальше: порт на arm64. Graviton в AWS дешевле и уже повсеместен, и хочется, чтобы те же хвосты держались и там.
Репозиторий: github.com/tishden/talaria-os-dev, лицензия Apache 2.0.
Комментарии (14)


Dhwtj
28.10.2026 12:47Масштабируемся количеством ВМ
На одной железке? Тогда перцентиль 99.99 не получится: супервайзер будет перераспределять ресурсы между ними и создавать микропаузы

DenisT Автор
28.10.2026 12:47да, в статье отмечено, что остаток по хвостам списывается на гипервизор. На голом железе должно быть существенно лучше, но, к сожалению, добить хвосты на metal инстансах в aws уже не хватило ресурсов

mixsture
28.10.2026 12:47А с многопоточностью что? Поток, который ждёт мьютекс, по-хорошему должен проснуться от записи соседа в слово памяти, а не ждать, пока ядро ОС соизволит его разбудить.
Тут маловато описания, но это похоже на возврат назад: из вытесняющей многозадачности в кооперативную. Во времена msdos/win95. Проблемы будут все те же: если программа повисла и добровольно управление не отдаст, то вся система намертво повисла.
DenisT Автор
28.10.2026 12:47тут как раз разработчик в манифесте приложения описывает, чего он хочет от системы: прибить конкретное ядро к конкретному потоку, прибить пул ядер к пулу потоков, или оставить вытесняющую многозадачность. Если хотя бы одно ядро оставить ОС, то система не встанет, останется возможность перезапустить приложение. В https://github.com/tishden/talaria-os-dev/blob/main/docs/HANDS-ON-GUIDE.md как настроить приложение с позиции разработчика, как под капотом работает - это наверное лучше отдельной статьей собрать, но базово описано в "Планирование и тик таймера"

Johnny_Depp
28.10.2026 12:47Это изначально выглядит, как будто человек заплатил куча деняк за токены, чтобы ИИ, на основе исходников ОС, выдало что-то "своё".
И не каких доказательств к анализу производительность, автор хочет чтобы "просто поверили"DenisT Автор
28.10.2026 12:47так я же привожу результаты замеров и методику измерений, вот подробнее https://github.com/tishden/talaria-os-dev/blob/main/docs/MEASUREMENTS.md. Можно руками все воспроизвести локально и на AWS
JBFW
28.10.2026 12:47Что-то напомнило MSDOS, таблицу векторов прерываний...
Вот интересно, если реализовать это сейчас, только 64-битное, без проблем с адресацией, по 1 задаче на 1 ядро...

CitizenOfDreams
28.10.2026 12:47Это примерно как "сделать транспорт как лошадь, только более быстрый". Можно, но лучше сделать автомобиль. То есть Win7, только быстрый и без багов.


Samid777
28.10.2026 12:47Можно. Название статьи, уже полностью готовый промт. Немного времени, и самая быстрая операционная система готова, пока не попросит кто нибудь еще быстрее.
Johnny_Depp
28.10.2026 12:47"
В целом всё в порядке, сказал бы я, пока не начал плотно заниматься проектами в трейдинге.
Когда из железа надо выжать максимум и счёт идёт на микросекунды, тюнинг ОС превращается в попытку обойти все её механизмы, какие только получится. В идеале ОС запускает процесс, сажает его на выделенное ядро процессора и забывает о нём. В этой точке пути ОС и приложения расходятся.
Добиться такого очень трудно. Даже на изолированном ядре приложению всё равно нужны системные вызовы, примитивы синхронизации, часы, память, диск и сеть. За каждую из этих услуг ОС берёт плату, и ниже я разберу, из чего она складывается.
"Ну просто очередной бред. Время выполнения одной инструкции современным процессором при частоте 4 гигагерц - между 0.25 и 250 пикосекунд.
Вы просто пинганите биржу, на которой торгуете, у вас там пинг будет запросто 50. А ещё плюс VPN, ибо многие биржи недоступны из РФ.
Если вы уж так любите всё низкоуровневое, могли бы сразу на ассемблере написать под линукс.
Но и то, современные компиляторы почти всегда эффективнее создают, нежели человек.
Хорошо, вам ОС не подходят, ибо вносят задержки, да, такое возможно.
Но тогда надо рассматривать уже создание устройства, у которого будет прошивка с одной конкретной задачей
InsiderCrush
Клод: Да вообще без б! Тут дел на 10 минут.
Dhwtj