

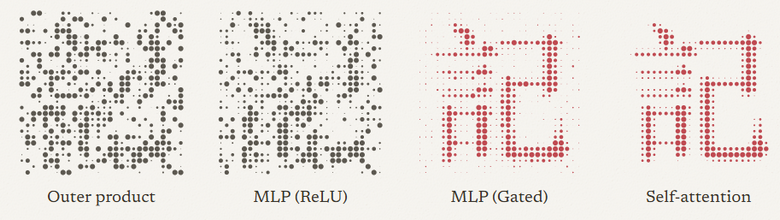
Современные языковые модели могут запоминать нишевые факты из всех уголков мира. Недавно я опаздывал на вечер настолок у друзей, поэтому попросил Astra напомнить мне правила игры Dune: Imperium. Она с готовностью продиктовала мне их, пока я вёл машину, и это помогло мне вспомнить правила настолько, чтобы сыграть снова. Мы так привыкли спрашивать модели обо всём, что воспринимаем их обширные знания как нечто само собой разумеющееся.
Но как же модели запоминают такие объёмы информации? И какой объём они могут хранить?
В этом посте я понятным языком расскажу о линейных отображениях, MLP и самовнимании как о типах хранения памяти. Из этого понимания мы сможем вывести эвристики о том, какой объём памяти может храниться в каждом из слоёв.
Ключевое свойство, характеризующее качество хранилища памяти, — способность извлекать хранимое. В конце концов, даже если мы можем хранить бесконечное число фактов, это будет не особо полезно, если не получится извлекать их при необходимости. Чем больший объём памяти мы храним, тем сильнее он мешает извлечению информации. В этом посте мы рассмотрим одну величину — соотношение помех к сигналу, определяющее, насколько другие воспоминания препятствуют при извлечении информации. Количество воспоминаний, которое может содержаться в хранилище, прежде чем величина помех станет равной величине сигнала, называется ёмкостью.
Мы разовьём эту точку зрения и продемонстрируем, как можно перейти от линейного слоя к чему-то более оптимальному — MLP, улучшающему и ёмкость, и полноту извлечения информации, а затем дойдём до самовнимания, которое имеет очень хорошую полноту извлечения информации и может хранить потенциально неограниченное количество воспоминаний. При 64-размерных ключах порядок перехода будет таким: от примерно 64 воспоминаний до примерно 2700, а затем до более чем миллиона.
В статье мы будем использовать следующую терминологию: хранилище памяти — это функция ?, содержащая ? воспоминаний, где ? =1,…,?. Воспоминание — это одна пара «ключ-значение»: ключ ?? ∈ℝ?? используется для поиска на основании схожести, а значение ?? ∈ℝ?? — это то, что мы хотим извлечь. Чтобы использовать ?, мы выполняем запрос к ней с входящими данными ?, а она извлекает вывод ?(?). Хорошее хранилище памяти извлекает ??, когда мы выполняем запрос ?? или с другим вектором, схожим с ??. В литературе хранилище памяти, возвращающее информацию по схожести, называется ассоциативной памятью.
Хранилище внешних произведений
Самое простое хранилище памяти — линейное: оно просто накапливает воспоминания при помощи внешних произведений,
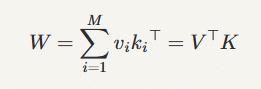
где строки ? ∈ℝ?×?? и ? ∈ℝ?×?? — это ключи ??⊤ и значения ??⊤1.
1 Иногда это накопление ключей и значений называется «хеббовским обучением», потому что сила синапсов (веса) увеличивается входящими (ключами) и выходными данными (значениями), которые срабатывают одновременно (коррелируют).
Для сохранения нового воспоминания (?,?) мы просто прибавляем ??⊤ к уже существующим весам2.
2 Такое хранилище памяти внешних произведений используется для состояния линейного внимания, также называемого быстрыми весами (fast weights): каждый токен сохраняет воспоминание (?,?), добавляя ??⊤ к матрице, к которой выполняют запросы последующие токены (Katharopoulos et al.; Schlag, Irie & Schmidhuber).
Отступление: запись воспоминания шагом градиентного спуска
Возьмём линейный слой ? =??, находящийся внутри сети со скалярным значением функции потерь ?; пусть ¯? =∇?(?) — градиент функции потерь относительно выходных данных слоя. Градиент относительно ? равен ¯??⊤, поэтому шаг со скоростью обучения ? имеет вид
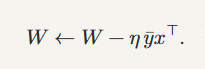
Это повторение — обновление воспоминаний: оно обновляет веса новым воспоминанием с ключом ? и значением −?¯?. Подробнее об этой точке зрения можно прочитать у Irie, Csordás & Schmidhuber, которые выразили линейный слой, обучаемый градиентным спуском, в виде внимания всех входных данных обучения.
Для выполнения запроса к хранилищу памяти входящими данными ? мы умножаем входящие данные на матрицу:
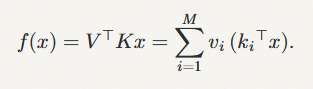
То есть процесс извлечения информации — это операция поиска по схожести с хранимыми ключами: мы сравниваем запрос с каждым ключом и возвращаем сумму значений, взвешенную на эту схожесть.
Помехи при извлечении информации
Итак, сохранять воспоминания легко: достаточно просто добавлять внешние произведения к весам. Но что происходит, когда мы пытаемся извлечь информацию?
Для упрощения допустим, что каждый ключ нормализован, чтобы иметь длину 1, то есть ??⊤?? =1. Тогда
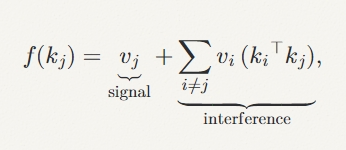
То есть мы получаем значение целевого воспоминания (того, по ключу которого мы выполняли поиск) плюс помехи от всех остальных воспоминаний, ключи которых похожи на поисковый запрос
Если бы все ключи были ортонормированными, помехи (interference) были равны нулю, а воспоминание оказалось бы точным. Однако ℝ?? имеет только ?? ортогональных направлений, поэтому мы не можем извлекать информацию идеально после того, как сохраним больше воспоминаний, чем размерность ключей: ? >??.
Какова ёмкость хранилища внешних произведений? Можно определить это, исходя из логики. Существует ? −1 элементов помех. Если ключи представляют собой случайные единичные векторы, то каждая схожесть ??⊤?? примерно равна ±1/√??. Если значения тоже случайны и имеют схожие длины, то ? −1 элементов помех будут суммироваться подобно случайному блужданию, поэтому квадрат длины помех примерно в (? −1)/?? раз больше квадрата длины сигнала, а
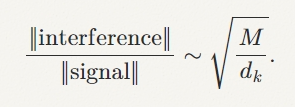
Присвоив этому соотношению значение 1, мы получим ёмкость ?≈??. После того, как мы сохраним такое количество воспоминаний в качестве размерности ключей, величина помех будет равна величине сигнала, подавив его.
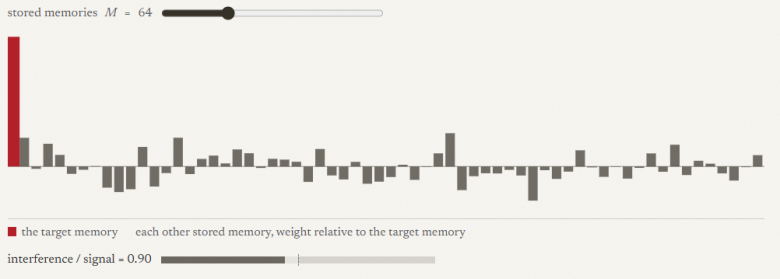
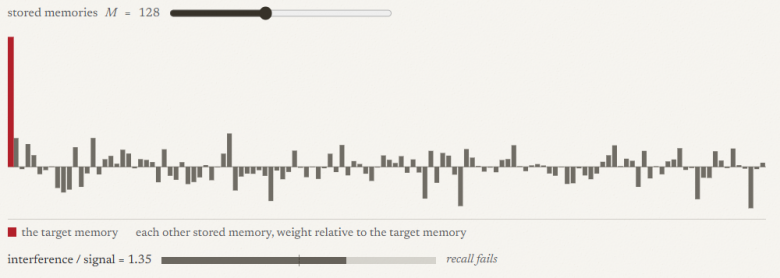
Каждый из показанных ниже столбцов — это один вес сохранённого воспоминания в одной операции извлечения информации относительно веса целевой памяти (красный). Каждый столбец прибавляет часть своего значения к процессу извлечения памяти.
Как снизить помехи
Даже ниже своей ёмкости примерно в ?? воспоминаний хранилище внешних произведений при извлечении информации создаёт существенные помехи3.
3 Это актуально для извлечения чистого вектора значения. Если каждое значение должно лишь указывать на правильный ответ в фиксированном множестве, например, выбирать наиболее вероятный токен, то процессу извлечения информации достаточно оказаться ближе к правильному ответу, чем к неправильным, а матрица ? ×? может хранить примерно ?2 фактов (Nichani, Lee & Bietti).
Для повышения ёмкости или для более точного извлечения информации нам нужно снизить помехи.
Можно решить проблему «грубой силой», увеличив размерность ключей ??, поскольку ёмкость линейного хранилища растёт в соответствии с ??. Максимальная величина ?? определяется ограничениями оборудования.
Или же мы можем внести алгоритмические улучшения. Можно хранить воспоминания более продуманно: хранилище внешних произведений добавляет каждое воспоминание без учёта других, поэтому никак не способствует снижению помех от них. Или же мы можем более выборочно производить извлечение информации: каждое воспоминание в линейном хранилище вносит свой вклад в величину помех, даже если его ключ имеет низкую схожесть с запросом, поэтому мы можем улучшить процесс извлечения информации, подавляя менее схожие ключи.
Ниже мы увидим, что более аккуратное хранение воспоминаний внешних произведений даст нам оптимальное линейное хранилище, имеющее примерно вдвое большую ёмкость. Выборочное извлечение информации при помощи нелинейности даст нам MLP и самовнимание.
Оптимальное линейное хранилище воспоминаний
Хранилище внешних произведений записывает каждое воспоминание без учёта остальных. Вместо этого мы можем выбрать такие веса ? , чтобы при извлечении информации одновременно корректно восстанавливались все сохранённые воспоминания. Это задача линейной регрессии4:
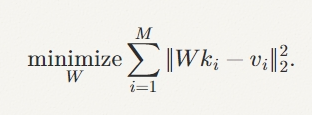
4 Мы также можем использовать эту целевую функцию регрессии для разработки кратковременной памяти, которую последовательная модель формирует во время прямого прохода, как это происходит в линейном внимании и самовнимании. См. мою работу про регрессию на этапе тестирования.
Когда мы храним больше воспоминаний, чем размерность ключей (? >??), решение методом наименьших квадратов имеет вид
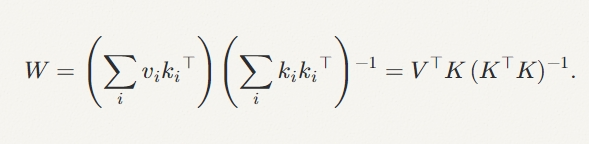
Это хранилище внешних произведений ?⊤? с одним изменением: прежде, чем мы сравниваем запрос с ключами, мы умножаем его на (?⊤?)−1, что устраняет влияние ковариации ключей ?⊤?. Это «отбеливает» ключи, чтобы хранилище больше не отдавало больший вес направлениям, общим для множества ключей.
Когда ? ≤??, регрессия корректно восстанавливает все воспоминания при условии, что ключи линейно независимы. То есть оптимальное хранилище извлекает информацию вообще без помех, даже если ключи не ортогональны.
При ? >?? у нас начинают возникать помехи, потому что у хранилища есть только ?? для работы. Для случайных ключей и значений наше соотношение помех к шуму принимает вид
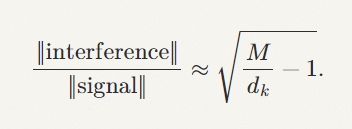
Это соотношение равно 1 при ?=2??, то есть ёмкость оптимального хранилища выросла вдвое!
Отступление: вывод оптимального линейного хранилища памяти
При ? ≤??. Если ключи линейно независимы, то матрица ? ×? внутренних произведений между ключами ??⊤ обратима, а
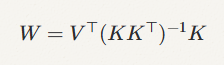
точно воспроизводит все воспоминания. При ? <?? у задачи недостаточно ограничений и она имеет бесконечно много решений, а данное представляет собой решение с минимальной нормой. Строки  из (??⊤)−1? называются двойственным базисом строк ?: по построению, (??⊤)−1??⊤ =?, поэтому
 . Тогда
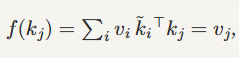
а значит, помех нет и мы получили идеальное извлечение информации.
При ? >??. Приравняв градиент целевой функции к нулю, получаем ??⊤? =?⊤?, то есть ? =?⊤? (?⊤?)−1. Оба решения ? =?⊤(?⊤)†, где ?† обозначает матрицу, псевдообратную ?: (?⊤)† =(??⊤)−1?, когда ключи линейно независимы, и (?⊤)† =?(?⊤?)−1, когда они порождают пространство ℝ??.
Теперь мы можем проанализировать помехи ?(??) =?⊤? (?⊤?)−1??. Для сохранённого ключа ?? вес каждого значения ?? равен ??⊤(?⊤?)−1??, что в точности соответствует элементу (?,?) матрицы ? ×? ? =?(?⊤?)−1?⊤:
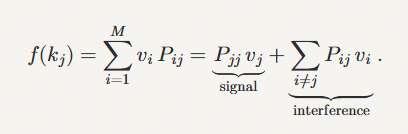
? — это матрица проекции на пространство столбцов матрицы ?, которое является ??-мерным подпространством ℝ?. Проанализировать отношение помех к сигналу нам помогут два факта:
-
Сигнальная составляющая: В силу циклического свойства следа матрицы,
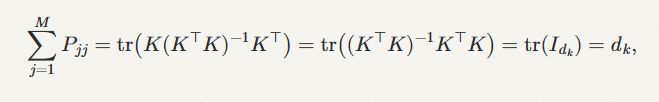
поэтому веса сигналов ? в сумме дают ??. Если ключи случайны, то ни один ключ не является особенным, поэтому ??? ≈??/?.
-
Составляющая помех: ? — это симметричная матрица проекции, поэтому ?⊤? =?2 =?. Тогда
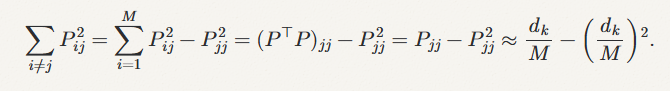
Если значения случайны со схожими длинами, то
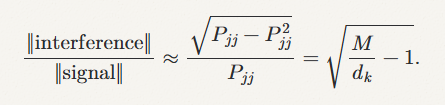
По сравнению с √?/?? хранилища внешних произведений, слагаемое -1 соответствует помехам от воспоминаний ??, которую оптимальное хранилище устраняет. .
Мы можем проверить наши прогнозы численно: случайным образом сэмплируем ? воспоминаний с ключами единичной длины в ?? =64 размерностях, выполним запрос к хранилищу памяти с одним из хранимых ключей, а затем замерим соотношение помех к сигналу:
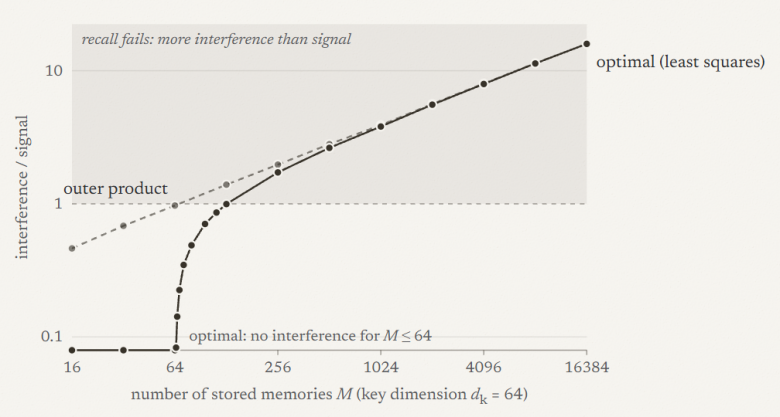
Хранилище внешних произведений достигает своей ёмкости при ? ≈?? =64. Оптимальное хранилище точно извлекает информацию до ? =??. Выше этого значения помехи начинают расти от нуля как √?/??−1, а хранилище достигает своей ёмкости приблизительно при ? =2?? =128, как и прогнозировалось. Поскольку оно устраняет помехи, эквивалентные фиксированному числу воспоминаний, разрыв между двумя хранилищами сокращается по мере роста ?.
Тем не менее, это оптимальное хранилище всё равно линейно относительно схожестей. Оно вынуждено масштабировать малые и больше схожести на один множитель. Чтобы улучшить ситуацию, нам нужно изменить способ извлечения информации из хранилища.
MLP — нелинейное хранилище памяти
Линейное хранилище памяти извлекает информацию так:
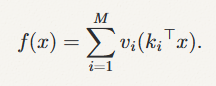
Если бы мы могли найти способ подавления веса при малом ??⊤?, то можно было бы снизить величину помех со стороны ключей с низкой схожестью.
Давайте перед вычислением взвешенной суммы значений пропустим каждую схожесть через нелинейную функцию ?:
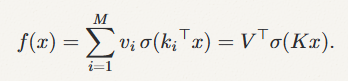
Так мы самостоятельно открыли для себя двухслойный перцептрон (MLP — многоуровневый перцептрон)! Строки первой матрицы весов — это ключи, а столбцы второй матрицы весов — значения. Sukhbaatar et al. указали на это сходство между полносвязными слоями и хранилищами воспоминаний, а Geva et al. обнаружили, что полносвязные слои обученных трансформеров часто работают именно таким образом: ключи активируются в ответ на распознаваемые закономерности во входных данных.
В идеале, функция-привратник ? выбирается так, чтобы при низкой схожести (??⊤? ∼0 или даже при ??⊤? <0) его соответствующая составляющая в сумме подавлялась для снижения помех. Функция активации ReLU обнуляет значения ключей, имеющих отрицательное сходство с входными данными, а добавление смещения позволяет сдвигать этот порог5.
5 Для случайных ключей ReLU снижает помехи в √2 раза. Схожесть случайного ключа равновероятно может быть положительной и отрицательной, поэтому ReLU обнуляет примерно половину весов, а другую половину оставляет неизменной. Это вдвое уменьшает дисперсию помех, равную сумме квадратов весов, поэтому сами помехи уменьшаются в √2 раза. Полный вывод см. в Zhong et al.
Квадрат функции активации ReLU ещё сильнее подавляет ключи, сходство которых близко к нулю. Например, сходство 0,1 превращается в 0,01, тогда как сходство 1 остаётся равным 1. В действительности ReLU в квадрате — одно из менее известных, но уже проверенных на практике и широко применяемых улучшений функций активации MLP. (So et al.).
MLP с квадратичной ReLU — это MLP с GLU, в котором вентильная проекция и проекция входных данных используют одни и те же веса, поскольку ReLU(??)2 =ReLU(??) ⊙??. В MLP с SwiGLU, используемых в современных языковых моделях, для вентиля предусмотрены собственные веса, а вместо ReLU используется функция активации Swish.
На практике MLP хранят факты в суперпозиции: множество фактов используют одни и те же веса, а выход представляет собой смесь множества воспоминаний. Garcia et al. строят такую модель явно: скрытые нейроны MLP с GLU вычисляют случайные признаки ?(?) входных данных, вторая матрица весов представляет собой хранилище внешних произведений ∑????(??)⊤, построенное на этих признаках, а MLP хранит гораздо больше фактов, чем в нём есть скрытых блоков. Тем не менее, в обученных трансформерах ReLU-MLP для заданного входа могут активировать всего 1% скрытых блоков, поэтому при каждом извлечении используется лишь небольшая часть воспоминаний (Li et al.).
Авторы трансформеров уже это знали
В оригинальной статье о трансформерах эта связь тоже проводилась, но только в версиях v2 и v3, опубликованных на arXiv. В них описывают полносвязный слой как «разновидность механизма внимания», в котором строки двух матриц весов выступают в роли ключей и значений, а вместо softmax используется ReLU. Они даже попробовали заменить полносвязные слои механизмом внимания, работающим с обучаемыми параметрами ключей и значений, и получили примерно такое же качество перевода: в одном варианте оно оказалось немного хуже, в другом — немного лучше. Правда, первый вариант обучался примерно на 30% медленнее. Этот фрагмент исчез из всех последующих версий статьи. Ниже мы ещё вернёмся к тому, как механизм самовнимания связан со всем этим.
Снижение помех при помощи более высоких степеней
Возведение сходств в квадрат работает, потому что оно гораздо сильнее уменьшает веса, соответствующие низким значениям сходства, чем веса, соответствующие высоким. Мы можем усилить этот эффект, задав функцию активации ?(?) =ReLU(?)?. Сигнал остаётся тем же, поскольку 1? =1, а составляющая помех со схожестью 1/√?? снижается до ??−?/2. Составляющие помех ? складываются подобно случайному блужданию, поэтому отношение помех к сигналу равно
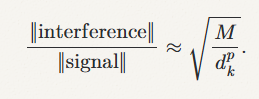
Поэтому ёмкость:
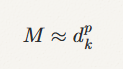
что геометрически больше, чем ранее!
Чтобы убедиться в этом, можно провести тот же эксперимент для пяти выбранных ?:
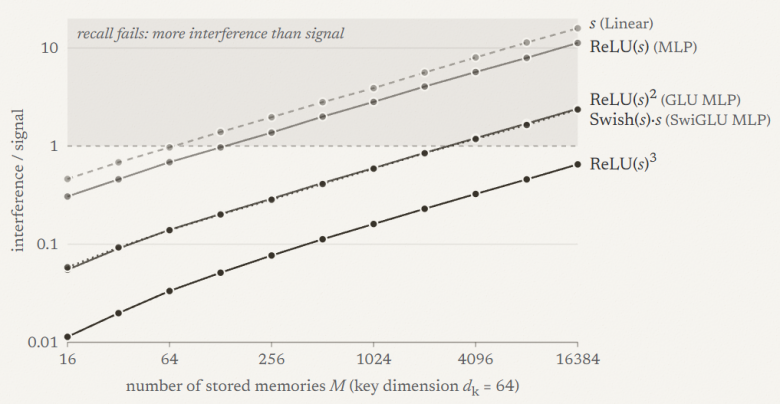
Поскольку помехи увеличиваются как √?, на графике в логарифмическом масштабе по обеим осям линии почти параллельны. Меняется только их высота, а вместе с ней и ёмкость, при которой каждая из линий пересекает 1:
Линейная: ёмкость ? ≈?? =64.
ReLU: обнуление отрицательных схожестей уменьшает помехи в √2 раза, поэтому ёмкость увеличивается до ? ≈2?? =128.
Квадратичная ReLU: каждая составляющая помех снижается с 1/√?? до 1/??, поэтому ёмкость увеличивается до ? ≈2??2/3 ≈2700, то есть почти в 40 раз больше, чем у линейного хранилища.
MLP с SwiGLU, в котором вентиль использует те же веса, что и входная проекция, как и в случае с квадратичной ReLU, ?(?) =Swish(?) ⋅? =?2/(1 +?−?): его ёмкость приблизительно совпадает с ёмкостью квадратичной ReLU.
Кубическая ReLU: каждая составляющая помех уменьшается примерно до ??−3/2, поэтому ёмкость увеличивается до ? ≈2??3/15 ≈35000.
Самовнимание как непараметрическое хранилище памяти
Возведение весов в степени увеличивает ёмкость примерно до ???. Но что, если мы хотим использовать это свойство по максимуму? Вместо выбора одной степени можно применить бесконечное их количество. Экспонента представляет собой взвешенную сумму всех степеней,
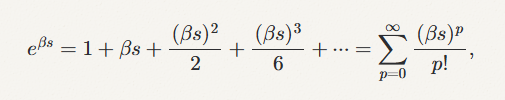
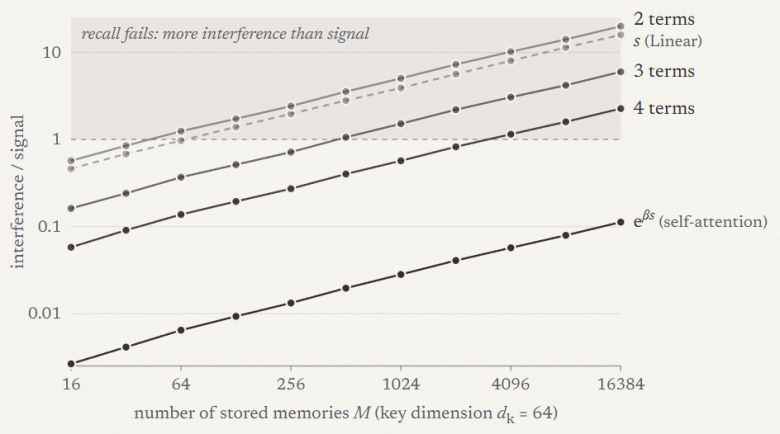
где параметр резкости ? определяет вес старших степеней. Вот тот же эксперимент при ? =√?? (значении, используемом в механизме самовнимания6) для экспоненты и её ряда, усечённого после 2, 3 и 4 членов.
6 Трансформеры не умножают, а делят схожести на √??. Однако их запросы и ключи имеют длину примерно √??, поэтому соответствующей парой будет ?⊤? ≈??. Наши ключи и запрос имеют единичную длину, поэтому соответствующая пара имеет схожесть 1. Поэтому мы выполняем масштабирование на ? =√??.
При двух членах ряда ёмкость составляет около 40 — меньше, чем у линейного хранилища, поскольку постоянный член придаёт каждому ключу вес примерно 1. При трёх членах она составляет около 450, а при четырёх — около 3100, что близко к показателю для квадратичной ReLU. Полная экспонента остаётся значительно ниже пунктирной линии, поэтому её ёмкость выходит за пределы графика.
Чтобы определить ёмкость экспоненты, в качестве запроса используем сохранённый ключ ??. Тогда целевое воспоминание имеет сходство 1 и вес ?? =??. Все остальные воспоминания имеют вес ?? =????, где для случайных единичных ключей схожесть ?? приблизительно подчиняется нормальному распределению с математическим ожиданием 0 и дисперсией 1/??.
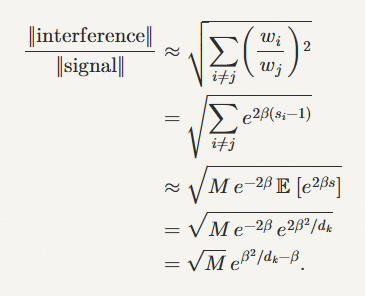
Если векторы значений случайны и имеют примерно одинаковую длину, составляющие помех от остальных ? воспоминаний суммируются подобно случайному блужданию.
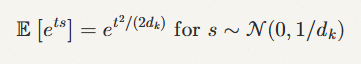
Приравняв это отношение к 1, получаем ёмкость, равную
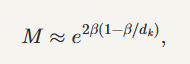
экспоненциально растущую с ? при ? сильно меньше ??, а не полиномиально от ??, как ранее! При ? =√?? =8 ёмкость примерно равна ?14 ≈1,2 миллиона воспоминаний, что примерно 20 000 раз больше, чем у линейного хранилища. Если проводить тот же эксперимент дольше, то ёмкость тоже окажется примерно равной 1,2 миллиона.
На практике при реализации мы, возможно, не захотим наивно возводить числа в экспоненту: слишком маленькие числа могут вызвать потерю значимости, а слишком большие — переполнение. К счастью, как показывает приведённая выше цепочка рассуждений, помехи зависят только от отношений между весами. Поэтому можно разделить каждый вес на сумму всех весов, не меняя отношения помех к сигналу и обеспечивая при этом численную устойчивость:
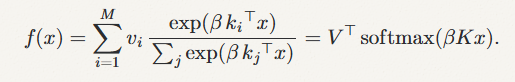
Это самовнимание7.
7 В терминологии трансформеров, схожесть равна ??⊤?, где ? =???, умноженное на 1/√??. Я перенёс ?? в ключи. Ключи и запросы в трансформере имеют длину примерно √??, поэтому для ключей единичной длины, как в нашем случае, такой масштаб соответствует ? =√??.
В отличие от MLP, у которого ключи и значения представляют собой обучаемые веса, механизм самовнимания вычисляет ключи и значения на основе токенов в контексте. Каждый токен хранит одно воспоминание, поэтому число воспоминаний ? равно длине контекста. Именно из-за этого механизм самовнимания является непараметрическим: его воспоминания не являются параметрами, а хранилище растёт вместе с контекстом.
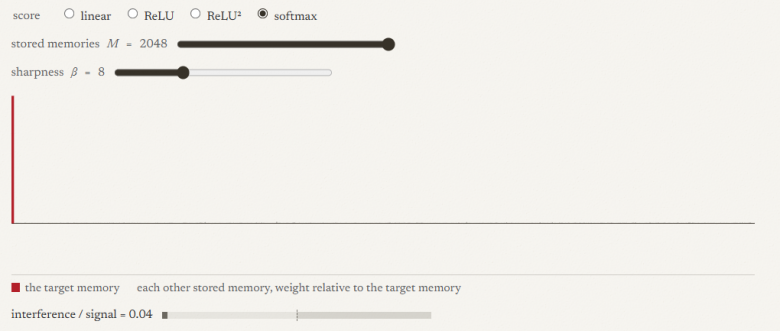
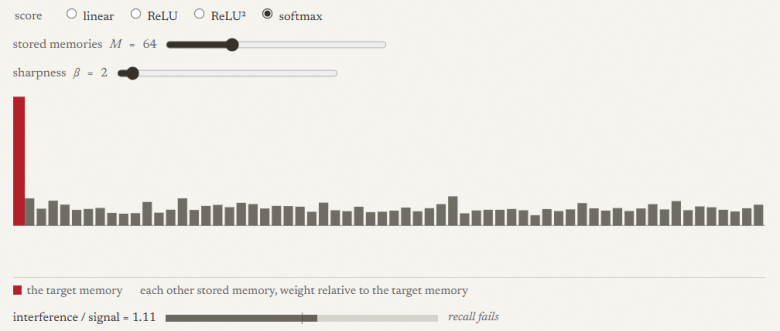
Вот ещё одна столбчатая диаграмма, на этот раз мы начинаем с softmax. При ? =8 извлечение воспоминаний не даёт сбоев во всём диапазоне значений, а при снижении ? до 2 и повышении ? извлечение информации даёт сбой спустя всего несколько десятков воспоминаний. При каждом удвоении ? нужно немного увеличивать ?, чтобы извлечение продолжало работать. Именно эта идея лежит в основе следующего раздела.
Обработка множества пар «ключ-значение» в длинном контексте
Так как ? определяет силу подавления менее схожих ключей, мы можем увеличивать ? с увеличением количества пар «ключ-значение». А почему бы просто не сделать ? огромным? При ? →∞, функция softmax превращается в жёсткую операцию argmax, которая выбирает только ключ с наибольшим сходством. Такая операция недифференцируема. При очень больших ? обучение уже работает плохо, поскольку softmax насыщается, а градиенты для всех остальных ключей обращаются в ноль. Поэтому мы можем увеличивать ? только в той степени, которая требуется ?. При работе с длинными контекстами добиться этого позволяет масштабирование логитов внимания с помощью log?. Есть несколько версий этого приёма; каждый из них задаёт ? относительно фиксированной эталонной длины ? (обычно длины обучающей последовательности). Благодаря этому при ? =? значение ? остаётся таким же, каким оно было при обучении:
Su (2021) выводит масштабный коэффициент log?, исходя из требования сохранять постоянную энтропию механизма внимания по мере роста ?. Коэффициент нормируется так, чтобы при ? =? он совпадал с коэффициентом в стандартном механизме внимания. При любой длине последовательности логиты умножаются на log?/log?. В методе Scalable-Softmax используется аналогичная формула: логиты умножаются на ?log?, где ? — обучаемый параметр.
В исходных моделях Qwen используется LogN-Scaling: тот же коэффициент применяется только тогда, когда длина контекста превышает ?.
В Qwen2.5-1M используется масштабирование внимания из YaRN: логиты умножаются на (0.1log(?/?)+1)2, поэтому коэффициент растёт пропорционально (log?)2.
Вот как каждое из правил проявляет себя в нашем эксперименте, при ? =√?? =8 и ? =1024 воспоминаниях:
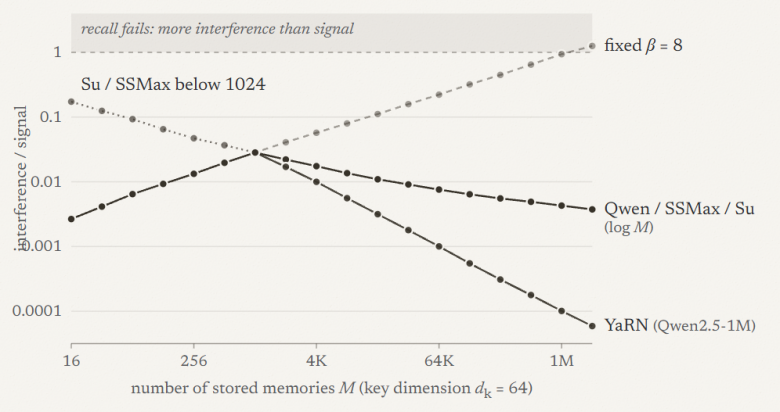
Правила Qwen и Su совпадают при длине контекста, превышающей эталонную длину ?. В этом диапазоне отношение помех и сигнала снижается по мере роста хранилища и достигает примерно 0,004 при двух миллионах воспоминаний. Более быстро растущий масштабный коэффициент YaRN снижает это отношение примерно до 10−4. Во всех трёх случаях масштабирование ? пропорционально log? позволяет хранить практически неограниченное число воспоминаний с различными ключами.
Мысли в заключение
Ниже представлены рассмотренные нами хранилища памяти, а также их ёмкости при выполнении запроса с хранимым ключом и случайными ключами и значениями:
Хранилище памяти |
?(?) |
Ёмкость |
Ёмкость при ?? =64 |
|---|---|---|---|
Внешние произведения |
?⊤?? |
?? |
64 |
Оптимальное линейное |
?⊤?(?⊤?)−1? |
2?? |
128 |
ReLU MLP |
?⊤ReLU(??) |
2?? |
128 |
Квадратичная ReLU (GLU MLP) |
?⊤ReLU(??)2 |
2??2/3 |
примерно 2700 |
SwiGLU MLP |
?⊤(Swish(??)⊙??) |
примерно 2??2/3 |
примерно 2900 |
Кубическая ReLU |
?⊤ReLU(??)3 |
2??3/15 |
примерно 35000 |
Самовнимание, ? =√?? |
?⊤softmax(???) |
?2√??−2 |
примерно 1,2 миллиона |
Самовнимание, ? ∝log? |
?⊤softmax(???) |
в наших экспериментах не достигнута |
больше 2 миллионов |
Мы начали с простого эвристического хранилища воспоминаний (хранилища внешних произведений) и постепенно пришли к рассмотрению всех стандартных слоёв, которые используются сегодня в современных трансформерах. Такой подход также позволил нам оценить различия между ними с точки зрения ёмкости, то есть способности хранить векторы в качестве ключей и значений.
Следует отметить, что оценка ёмкости — лишь один из способов взглянуть на архитектуру современных нейросетей. При её расчёте мы учитываем только то, сколько случайных векторов может извлечь один слой, прежде чем помехи начнут преобладать над сигналом. На самом деле мы вообще не рассматривали обучающие данные, которые влияют на то, что именно представлено в ключах и значениях! Существуют и другие исследования, в которых учитывается, что слои уже обучены, а объём хранимой информации измеряется в битах. По оценкам Morris et al., модели типа GPT запоминают около 3,6 бита на параметр. Они также обнаружили, что, когда модель достигает предела своей ёмкости, она начинает обобщать и запоминает меньше информации из каждого обучающего примера. Allen-Zhu & Li установили, что языковые модели хранят около 2 бит фактических знаний на параметр, даже если параметры квантованы до формата int8.
Отсюда можно перейти ко множеству других не менее увлекательных направлений исследований:
Какой объём информации может храниться в слое: Nichani, Lee & Bietti, Barnfield et al. о линейных хранилищах, Dugan et al., Garcia et al. о MLP с явно выделенными блоками для хранения фактов и статья Zhong et al., послужившая отправной точкой для приведённых здесь оценок отношения помех к сигналу.
Сети Хопфилда и хранилища воспоминаний с экспоненциальной ёмкостью: Krotov & Hopfield о плотной ассоциативной памяти, Demircigil et al., Ramsauer et al. связали её со вниманием; обзорная статья Krotov et al..
Кратковременные воспоминания, обновляемые во время инференса: fast weights, Mamba, Mamba-2, DeltaNet, Gated DeltaNet, TTT layers, Titans, MesaNet и test-time regression.
Огромные, но разреженные параметрические хранилища памяти, дополняющие MLP или заменяющие их: product-key memories, Memory Layers at Scale, UltraMem, Mixture of A Million Experts и Engram.
Непараметрические хранилища воспоминаний, которые расширяются за счёт добавления новых воспоминаний вне весов модели: kNN-LM, RETRO, Memorizing Transformers и growing nonparametric networks.
Нахождение и редактирование воспоминаний внутри обученных моделей: Geva et al., Bietti et al., ROME и MEMIT.
Сжатие кратковременной памяти или превращение её в долговременную: KVzip, gist tokens, Cartridges и attention matching
Методы непрерывного обучения, такие как sparse memory finetuning
Меня всегда притягивала тема памяти; наверно, потому, что я на собственном опыте остро ощущаю, насколько ограничена моя собственная память. Возможно, какая-то часть меня надеется, что, поняв, как машины запоминают информацию, я смогу лучше понять и самого себя.
LimTroev
(n^2-1)/2