

Есть у меня отдельная машина: материнка под Xeon E5-2696 v4 (22 ядра, 44 потока), 128 ГБ DDR3-1600 и видеокарта GTX 1070 на 8 ГБ. Плата с процессором и памятью обошлась примерно в 35 тысяч рублей, карта — ещё 8 тысяч с рук. Итого — тысяч 43 за всё, железо уровня “давно списано из майнинг-фермы и дата-центра”.
На этой штуке я запустил Qwen3.8-Flash-Next — MoE-модель на 125 миллиардов параметров (~6 млрд активных на токен) — и она реально работает. Не “теоретически запускается с квантованием до состояния овоща”, а выдаёт 14-15 токенов в секунду генерации на контексте 24,5К. Честно, не ожидал.
Под катом — как это возможно, какие движки я сравнивал, и что из тюнинга реально дало прирост.
Почему 125B параметров — это не то же самое, что 125B параметров
Если бы это была плотная (dense) модель на 125 миллиардов параметров, разговор был бы коротким: даже в 4-битном кванте это ~65 ГБ только под веса, и при каждом токене нужно пройти через все эти веса. На GTX 1070 с её 8 ГБ VRAM и ~180 ГБ/с пропускной способности это были бы единицы токенов в минуту, не в секунду.
Qwen3.8-Flash-Next — Mixture-of-Experts: 48 слоёв, 512 маршрутизируемых экспертов на слой, но на каждый токен реально активируется лишь малая часть — порядка 6 млрд параметров-эквивалент вычислений. Это меняет всё: основную массу весов (экспертов, которые сейчас не нужны) можно держать в обычной оперативной памяти или вовсе на диске, и подгружать/считать на CPU только то, что реально потребовалось. GPU в этой схеме обслуживает “горячую” часть — attention, несколько всегда-активных слоёв, и кэш самых часто используемых экспертов.
Поэтому ключевой ресурс здесь — не VRAM, а суммарная память (VRAM + RAM) и количество ядер CPU, которые считают офлоаженных экспертов. 128 ГБ DDR3 — медленной, 1600 МГц, без изысков — но её много, и 22 физических ядра есть кому эту арифметику считать параллельно.
Железо и файлы модели
GPU: NVIDIA GeForce GTX 1070, 8 ГБ VRAM — ~8 000 ₽
CPU: Intel Xeon E5-2696 v4, 22 ядра / 44 потока, 2.2 ГГц
RAM: 128 ГБ DDR3-1600 (материнка + CPU + память — ~35 000 ₽ одним комплектом)
Накопители: модель переехала с 4ТБ HDD на системный NVMe — об этом ниже, разница ощутимая
Квантованные файлы модели — порядка 95-98 ГБ на диске (три шарда GGUF в IQ4_XS/UD-IQ4_XS). В 8 ГБ VRAM из этого влезает меньше десятой части — всё остальное читается с диска при старте и живёт в RAM.
Два движка: llama.cpp и Strata
Гонял одну и ту же задачу (MoE-офлоад экспертов на CPU) на двух инференс-движках.
llama.cpp — классика, --n-cpu-moe держит часть слоёв экспертов на CPU, --override-tensor позволяет точечно докинуть на GPU конкретные тензоры сверх этого.
Strata — движок с явным упором на MoE: адаптивный кэш экспертов в VRAM (--expert-cache auto, сам решает, какие эксперты держать на карте по частоте обращения), и спекулятивное декодирование через MTP-драфтер (Multi-Token Prediction) — лёгкий слой предсказывает несколько токенов вперёд, основная модель их пачкой проверяет, из-за чего при удачном совпадении генерация идёт быстрее, чем токен-за-токеном.
Методика
Для каждого размера запроса (1К / 4К / 16К / 24,5К токенов “уже в контексте”) — 3 прогона со случайным текстом-заполнителем и случайным ID в начале (чтобы не словить кэш промпта), генерация 128 токенов, температура 0. Результат — медиана трёх повторов. Контекст — 32768 токенов (упирается в VRAM на этой карте даже с квантованным int8 KV-кэшем). Скрипты и сырые данные — в репозитории, см. ссылку в конце.
Результаты: llama.cpp, подбор офлоада
Сначала — что получилось выжать из llama.cpp. Три шага: все эксперты на CPU → добавить один слой экспертов целиком на GPU (-ncmoe) → докинуть ещё одну матрицу тензора точечно (-ot).
Генерация, ток/с (медиана):
Запрос |
все эксперты на CPU |
+1 слой на GPU |
+ точечный тензор |
|---|---|---|---|
1K |
5,1 |
5,6 |
6,2 |
4K |
5,4 |
6,1 |
6,1 |
16K |
4,6 |
5,1 |
5,5 |
24,5K |
4,3 |
5,0 |
5,4 |
Итог — +20-26% к генерации от простейшей раскладки до финальной, бесплатно, просто перераспределением слоёв между GPU и CPU. VRAM в финале — 7666 из 8192 МиБ, то есть упёрлись в карту почти впритык: следующая матрица экспертов (ещё ~425-450 МиБ) уже не влезает без урезания контекста.
Любопытная деталь: лог llama.cpp сам советовал добавить --load-mode none при использовании --override-tensor (типа “так быстрее”). Проверил — это оказалось явной регрессией: prefill упал с 82-99 до 10-29 ток/с. Без mmap операционная система не держит страницы CPU-резидентных весов в файловом кэше, и они перечитываются с диска на каждый токен. Совет из лога, судя по всему, относится к другому сценарию — не доверяйте слепо.
Результаты: Strata — и тут начинается интересное
Та же модель (вариант unsloth UD-IQ4_XS), движок Strata с адаптивным кэшем экспертов и MTP-спекуляцией:
Запрос |
llama.cpp, ген. ток/с |
Strata, ген. ток/с |
Strata, prefill ток/с |
|---|---|---|---|
1K |
6,2 |
15,3 |
237,6 |
4K |
6,1 |
15,3 |
224,9 |
16K |
5,5 |
15,2 |
236,5 |
24,5K |
5,4 |
15,1 |
237,6 |
Эта первая таблица сравнивает разные файлы модели (Uncensored-вариант на llama.cpp, официальный unsloth-квант на Strata) — честно предупреждаю сразу, чтобы не выглядело как жульничество. Дальше разобрался, насколько чистая эта разница на самом деле.
Пересобрал llama.cpp и прогнал на том же файле — и тут выяснилось интересное
Чтобы сравнить движки по-честному, нужен был llama-server, который грузит ровно тот же GGUF, что и Strata. Апстрим llama.cpp эту архитектуру (Qwen3.8 Flash Next) не понимает — но в исходниках Strata есть собственный патченный форк llama.cpp именно под такие модели. Собрал из него llama-server под CUDA 12.6 (ушло на пересборку минут 15; по пути всплыла мелочь — в этом чекауте не хватало каталога веб-морды чата, слепил пустую заглушку, раз нужен был только API) и прогнал на тех же файлах, что грузила Strata.
Тактика с Uncensored-кванта не перенеслась. На нём точечный перенос матрицы blk.46.ffn_down_exps весил ~450 МБ и укладывался в свободные 424-613 МиБ VRAM. На официальном unsloth UD-IQ4_XS та же матрица весит 891 МБ — почти вдвое больше: Unsloth Dynamic Quant держит часть тензоров в повышенной точности ради качества, жертвуя компактностью. Свободных 348 МиБ на такое уже не хватает.
Хуже: даже без точечного переноса, один -ncmoe 47 на этом файле оказался на самой грани VRAM и деградировал с ростом запроса — без перегрева (53°C), без видимого троттлинга, но стабильно медленнее на каждом следующем прогоне:
Запрос |
prefill, ток/с |
генерация, ток/с |
|---|---|---|
1K |
64,0 |
4,9 |
4K |
79,1 |
4,6 |
16K |
18,1 |
1,6 |
24,5K |
13,0 |
1,5 |
На 24,5К один повтор занимал около 33 минут (на Uncensored-кванте такой же запрос обрабатывался за секунды) — бенчмарк на этом размере пришлось остановить после 2 повторов вместо 3, дальше деградация уже ничего нового не показывала.
Вот теперь сравнение действительно чистое — один и тот же файл модели на обоих движках:
Запрос |
llama.cpp ген., ток/с |
Strata ген., ток/с |
ускорение |
llama.cpp prefill |
Strata prefill |
ускорение |
|---|---|---|---|---|---|---|
1K |
4,9 |
15,3 |
×3,1 |
64,0 |
237,6 |
×3,7 |
4K |
4,6 |
15,3 |
×3,3 |
79,1 |
224,9 |
×2,8 |
16K |
1,6 |
15,2 |
×9,5 |
18,1 |
236,5 |
×13,1 |
24,5K |
1,5 |
15,1 |
×10,1 |
13,0 |
237,6 |
×18,3 |
Разрыв оказался даже больше, чем в первой таблице — но смысл у него другой. Это не “Strata как движок в 3-18 раз быстрее llama.cpp”. Это конкретная находка: выбор кванта решает, останется ли у 8-гигабайтной карты запас VRAM для ручной подгонки llama.cpp вообще. На Uncensored-кванте запас был, и тюнинг дал честные 5,4-6,2 ток/с стабильно на всех размерах. На официальном unsloth-кванте запаса не осталось — и без переподбора конфигурации под конкретный файл llama.cpp на этой карте просто расползается на длинном контексте.
Strata в этом смысле выигрывает не только спекулятивным декодированием (о нём — ниже), а тем, что --expert-cache auto сам считает, сколько экспертов влезет в оставшуюся VRAM, под любой файл, без пересчёта тензоров руками под каждый новый квант. Для человека, который не хочет гонять gguf.GGUFReader каждый раз, когда меняет модель, — это не просто цифры в таблице, а реальная экономия вечера.
Часть разрыва по генерации всё ещё приходится на спекулятивное декодирование: accept rate у MTP-драфтера Strata гулял от 0% до 100% по разным прогонам (медиана 50-65%), llama.cpp в этом тесте спекуляцию не использовал вообще. На малопредсказуемом тексте разрыв по генерации будет меньше, чем в таблице.
Тюнинг на бесплатных флагах
Полез в strata --help в поисках того, что можно включить без риска регрессии — и нашёл два флага чисто про расстановку потоков и памяти, не трогающих арифметику:
--host-core sibling— по умолчанию поток, спинящийся в ожидании GPU-прерываний, занимает отдельное физическое ядро. На HT-процессоре его можно пересадить на второй логический поток той же пары — и отдать освободившееся физическое ядро CPU-пулу экспертов. На 22-ядерном Xeon это 22 воркера вместо 21.--expert-cache-per-layer— по умолчанию слоты VRAM-кэша экспертов раздаются из общего счётчика в порядке появления, из-за чего часть слоёв получает все слоты, часть — почти ничего. Флаг даёт каждому слою свой персональный бюджет.
Результат — стабильный прирост без каких-либо компромиссов:
Запрос |
генерация: база → тюнинг |
prefill: база → тюнинг |
|---|---|---|
1K |
14,0 → 15,3 (+9%) |
151,4 → 237,6 (+57%) |
4K |
14,1 → 15,3 (+9%) |
214,2 → 224,9 (+5%) |
16K |
14,3 → 15,2 (+6%) |
225,8 → 236,5 (+5%) |
24,5K |
13,9 → 15,1 (+9%) |
228,0 → 237,6 (+4%) |
На коротких запросах эффект на prefill особенно заметный (+57% на 1К) — похоже, там выше доля времени, которое съедает “холодный” проход через CPU-пул, и лишнее ядро там решает больше.
NVMe вместо HDD — не опция, а необходимость
Отдельно стоит сказать про хранение файлов модели. Изначально 95 ГБ лежали на старом 4ТБ HDD — холодная загрузка модели зависла больше чем на 10 минут, пришлось перезагружать машину, не дождавшись. Перенос тех же файлов на системный NVMe — и загрузка укладывается в ~150 секунд (из которых 55 ГБ весов экспертов читаются в RAM со скоростью ~1,2 ГБ/с). Для MoE-моделей с офлоадом в 90+ ГБ это не “было бы неплохо”, а разница между “работает” и “не дождался”.
Что в итоге
Бюджетная связка видеокарта-за-8к + списанный серверный Xeon с кучей медленной DDR3 — рабочий вариант для MoE-моделей таких размеров, если понимать принцип: платите не за то, чтобы весь 125-миллиардный монстр влез в VRAM, а за то, чтобы было, где держать офлоаженных экспертов (много RAM) и кому их считать (много ядер). GPU в этой схеме — ускоритель горячей части, а не обязательное условие “влезет/не влезет”.
Понятно, что 14-15 ток/с — это не скорость топового железа, но для локальной модели на 125B параметров на столе за 43 тысячи рублей — более чем рабочий результат.
Полные данные, сырые JSON/CSV замеров и скрипты, которыми всё это измерялось — в репозитории: github.com/DmNep/llm-bench-1070
Комментарии (126)

vtal007
09.11.2026 12:15" и тут начинается интересное"
"тюнинг дал честные 5,4-6,2 ток/с "
Никто никогда не интересовался, почему нейронки (в данном случае узнается чат-гпт) так любят "начинается интересное" и "честность"? У них (нейронок) было сложно детство, их часто обманывали?
Пойду думать, как получить нечестные 5,4-6,2 ток/с (украсть что ли?)

gotch
09.11.2026 12:15Под катом — как это возможно, какие движки я сравнивал, и что из тюнинга реально дало прирост.
Это ж ChatGPT.

mixsture
09.11.2026 12:15подозреваю, что это артефакты обучения с подкреплением. Кмк, там куча негенеренных данных и у них уклон в такие фразы.

Kirthgreat4
09.11.2026 12:15Видать маркеры из датасетов англоязычных техноблогеров переведенные в лоб

bogolt
09.11.2026 12:15Никто никогда не интересовался, почему нейронки (в данном случае узнается чат-гпт) так любят "начинается интересное" и "честность"?
Потому что "NVMe вместо HDD — не опция, а необходимость"
Интересно, а если я подключил hdd через nvme это будет еще опция или уже необходимость?

DMGarikk
09.11.2026 12:15очевидно что речь про ssd, а не про тип интерфейса
bogolt
09.11.2026 12:15Кому очевидно? Нейросети которая писала этот текст? Может у нее просто эти токены рядом стоят и она привыкла что они взаимозаменяемы. Но мне лично режет глаз подобная небрежность. От статей я ожидаю что авторы понимают что они пишут и зачем используют те или иные термины.
DMGarikk
09.11.2026 12:15Кому очевидно? Нейросети которая писала этот текст?
Это мне очевидно, человеку который когдато был админом и сталкивался с железом
Когда мне говорят "я поставлю hdd и nvme" у меня возникает однозначное понимание что под названием интерфейса имеется в виду ssd, а человек просто не вникает в технические подробности. это всё оттудаже что "процессор это такой ящик куда втыкается монитор" просто более низкого уровня
а про небрежность, тут не нужная такая детализация
вы например стали бы поправлять человека который сказал бы что CD-ROM подключается также как hdd через IDE или SATA ....а надо обязательно сказать что НЕТ, он подключается по протоколу ATAPI который передается через физический интерфейс PATA или SATA и это не тоже самое как c hdd
это блин духота какаято
вы много знаете HDD которые через nvme подключаются? одним лишь мысленным движением варианты ответов сокращаются до hdd/ssd
bogolt
09.11.2026 12:15Ок, вы меня передушнили, признаю поражение =)
Хочу сказать, что я лишь против шаблонных нейросетевых клише, на что и указал в своем ироничном комментарии. Если что я там жирным выделил нейроборот, который и привлек мое внимание, и лишь на его фоне я заметил что сравниваются не сравнимые вещи.
DMGarikk
09.11.2026 12:15просто для меня такое выражение очень типично от людей далеких от техники ;) я бы никогда на ИИ не подумал бы потому что часто слышал такое в реальности
bogolt
09.11.2026 12:15выражение очень типично от людей далеких от техники ;
эээ вы точно про выражение "не опция, а необходимость" говорите ? Я такой словесной каши от людей не слышал.
Если вы про NMVe и HDD то разумеется люди так говорят, но опять же, имхо в технической статье такому не место.


N1tr0xx
09.11.2026 12:15Я планирую покупать сервер на 2 или 3 2080 Ti 22GB и 64/128GB DDR4 ECC REG 2400 МГц.
Есть кому-то что-то сказать по этой сборке для Qwen 125B-A6B MTP?

DmNep Автор
09.11.2026 12:15По моему лучше на теслах строить систему + ддр3, она стоит копейки. Даже одна v100 16гб с 128 гб озу даст полноценное рабочее место. Плюс апдейтиться можно, ставить платы nvlink на 2 или 4 чипа, и оперативку до 256 догнать. Там уже модельки 200+ млрд параметров будт доступны на более менее приличных скоростях

here-we-go-again
09.11.2026 12:15У меня есть сказать, реально что-то делать от 100+ токенов/сек, меньше ад.

AquariusStar
09.11.2026 12:15Насколько комфортно и точно будет работать? Просто у меня есть сервер на базе Epyc 7B12 и памятью 256 ГБ. Просто всё думаю, ставить или не ставить V100 16ГБ. А то на 32-гигабайтную модель жаба душит. Но использование оперативной памяти, как мне сказали, режет скорость ощутимо.
P.S. Используется TrueNAS в качестве ОС. Наверное, там какие-то тонкости настройки в докере будут.
DmNep Автор
09.11.2026 12:15Если задачи однородные, например кодинг, без перепрыгивания на написание стихов и обратно, то qwen flash 3.8 со страта войдёт целиком в видеочип + озу и может выдавать 500-1000 на чтение и +-50 на генерацию. В любом случае даже с v100 16гб будет что то около dgs spark
DmNep Автор
09.11.2026 12:15Если из моего конфига выкинуть 1070 и вкинуть v100 на 16, там уже х3 по скоростям будет от того, что в статье, а по деньгам до 50тр

Sad_Bro
09.11.2026 12:15сейчас делаю на 2х cmp50hx по 20gb. + 128gb ddr3. Мучают сомнения по поводу сборки (насколько комфортно будет), нужно именно для агентской разработки.

Samcov
09.11.2026 12:15Я жду оборудование, сборка будет такая: X99 F8D Plus, 2680v4 x2, ddr4 rdimm 2400 32gb x 8, cmp50hx 20gb 16xpci x2 и отдельно v100 32gb x2 nvlink. Планировал тестить Qwen3.8-Flash-Next, GLM-5.3-Flash, DeepSeek-V4.1-Flash-1071. Недели через 3 только будет возможность попробовать
DmNep Автор
09.11.2026 12:15Я бы махнул мать с памятью на мать под ddr3 и 512. А мейби чудь добавить и натянуть на 1024 озу. На этом можно реально в высшую лигу пролезть. ddr4 3200 от ddr3 1600 на локальных модельках почти ничем не отличается, там pci душит скорость.

StalkerSVR
09.11.2026 12:15А смысл в 1024 ? Да и в 512 тоже... Какие модели из доступных требуют такого объема обычной памяти? Qwen3.8-Flash-Next и DeepSeek-V4.1-Flash вмещаются в 256Гб (насколько я понимаю, на практике не проверял). После 128Гб уже от видеопамяти будет больше пользы.

MxMaks
09.11.2026 12:15Про нейронку не скажу но вместо 2 2080ti - 1 3090 сильно лучше

starfair
09.11.2026 12:15Весьма сомнительное утвреждение. Смотря о чем речь.. На страта - никакого особого выигрыша вы не увидите. Да и под vLLM - тоже. Единственный реальный плюс - за счет более нового ядра, там более обширный круг моделей (в смысле квантования) можно под vLLM запускать. Но и тут не всегда это такой уж и выигрышь, после появления STRATA. Единственное о чем пишут пробовавшие и то и то, это что 3090 реально быстрее на не ИИ-шных задачах, типа видеомонтажа, в плане более универсального использования. Ну и игры тоже... Но мы жы вроде не про эти задачи тут говорим.

Agubigubaga
09.11.2026 12:15Память озу медленная. По моему опыту мегагерцы памяти очень сильно влияют на производительность страты. У меня как то упала скорость генерации с 50 до 37 токенов в сек и я долго не понимал в чем дело, а это оказывается у меня Биос баловался и зачем то сбросил частоты памяти с 3200 до 2133. Вернул частоты взад и снова стало быстро. Думаю на ddr5 с хотя бы 5000мгц там бы вообще 70 токенов в сек было, но сейчас 64гб такой памяти недостижимая мечта.
MxMaks
09.11.2026 12:15Именно так, сначала экономил 128гб за 130 не купил, потом чудом успел за 150 урвать) сейчас уже 200+. Работать то надо в любом случае.
starfair
09.11.2026 12:15У меня немного иная конфигурация по сервак: X99, DDR3 128Gb1333Mz. Вместо страты стоит отечественный форк DACAN, специально написаный под одну или две (как раз мой вариант) 2080Ti(22Gb) или майнинговые карты CTX.
Так вот, на его последней сборке, под моделью IQ3S, работает на средней скорости генерации поряка 60т/с. Префил от 1000т/с, но правда потом падает где то до 300. При том, что стартует модель с обычной SSD (старт гед то 3 минуты), но буду переводить на М2.
Проц у меня так же довольно слабый - Xeon 2666v3 (тоже наверное буду переводить, хотя и не уверен, что надо).
При этом, под vLLM на Qwen 3.8 27B (IQ4), даже в конфигурации работы GPU под NVLink, скорость генерации нижу втрое а то и больше (проседает на контексте в 100тыс под 6-7т/с)! . Правда, префил по сравнению с vLLM, чуть упал.
И это не говоря о том, что в раразботке Next Flash ну прямо реально умнее. Да и контекст в 262тыс, под NVLink - это прямо ну очень надо исхитриться, а в DACAN - можно и побольше выжать под моей конфигурацией, но для агентских задач и не крупных проектов - вполне и этого пока хватает.
В общем - я весьма доволен, и не ожидал, что все так успешно выйдет!

ponikrf
09.11.2026 12:15Вы соберите статистику по отвалам 2080 Ti 22GB в инференсе. 2080 Ti 22GB это только перепаянная память, других быть не может. А нагрузка идет по большей степени именно на память.
Да 2080 Ti 22GB кажется самым доступным вариантом GB VRAM на производительность. Но помните - что за все нужно платить, и дурачкой в это сфере (кто продает) попросту нет.

kenomimi
09.11.2026 12:15Xeon E5-2696 v4 (22 ядра, 44 потока), 128 ГБ DDR3-1600
Точно v4, а не v2? На 3-4 поколении вроде только DDR4 поддерживается. Отсутствие avx2 не проблема? У меня стоит без дела похожий конфиг, только памяти 256 и видяха instinct mi50 16гб - надо будет попробовать.
DmNep Автор
09.11.2026 12:15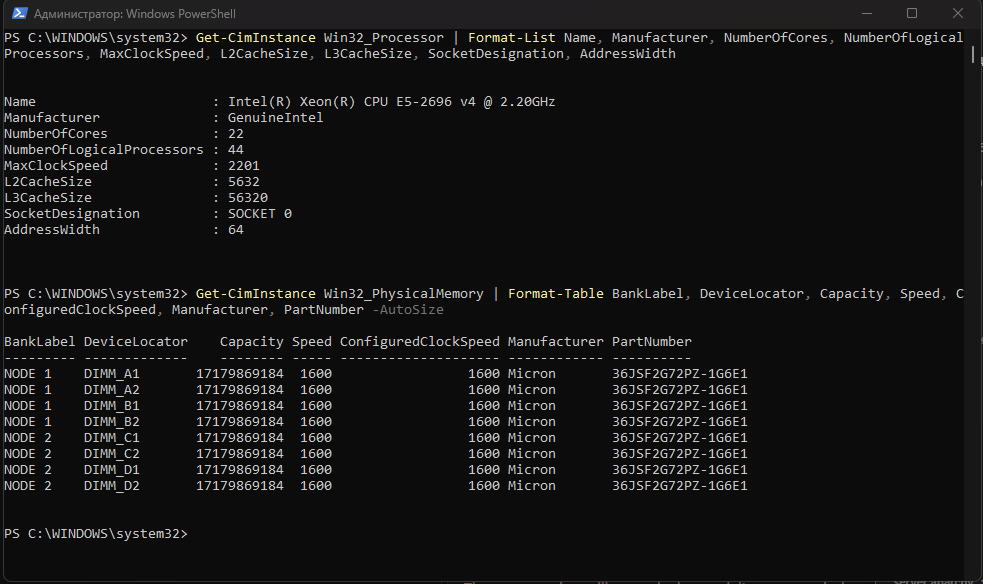
Объём памяти роляет, я прям так понимаю Сэма Альтмана) Под локальные модели смысла нет в ddr4, лучше на все деньги взять 256 озу и видеочипов, чем сидеть с 64 гб ddr4 и не иметь возможность вообще запустить модельки с 200+ млрд параметрами. И, главное, скорость ОЗУ вообще не роляет, что 3200, что 1600, всё упирается в бутылочное горлышко pci/ Agubigubaga
09.11.2026 12:15Скорость ОЗУ роляет ещё как, 64гб + 16врам полностью хватает для q3_s GSQ RCO кванта с контекстом 200к, который ну прям очень умный, по отзывам от q4_xl отличий не найдено. Скорость генерации на 2133 и 3200 частотах сильно разной была. "Мусорную" ddr4 память медленнее 3000мгц лучше не использовать.

LuciusWill
09.11.2026 12:15И, главное, скорость ОЗУ вообще не роляет, что 3200, что 1600, всё упирается в бутылочное горлышко pci
Странные слова. Скорость pci не бутылочное горлышко. Ограничение именно в скорости озу. DDR4 выдаёт в разы больше токенов. DDR3 имеет смысл брать лишь когда не хватает денег взять достаточный объём DDR4. Если есть возможность взять 128 ГБ DDR4, то лучше брать её.

Aquahawk
09.11.2026 12:15я взял двухсокетную мать на ddr3 и получил почти 100gb в секунду на 8 каналах. Прикол в том что много китайских материнок на ddr4 поднимают только 2 канала на проц(итого 4 ) и проигрывают 8 каналам ddr3. А цена на 32 гб модуль ddr4 уже в 3 и более раз больше.
DmNep Автор
09.11.2026 12:15Тут оба крайних варианта неточны. У Strata архитектура - большинство весов/экспертов лежит в ОЗУ, а в VRAM на GPU - кэш "горячих" экспертов с динамической выгрузкой/подгрузкой по мере роутинга (это уже объяснили выше в треде). Из этого следует:
Если промпт стабильно бьёт по уже закешированным в VRAM экспертам (например, однотипные задачи вроде кода) - ни скорость RAM, ни PCIe почти не чувствуются, вы упираетесь в compute GPU. Отсюда и наблюдение "у меня RAM простаивает".
Если промпт разнообразный и постоянно промахивается по кэшу - тогда в цепочке два последовательных узких места: сначала CPU должен прочитать вес эксперта из RAM, потом он едет по PCIe в VRAM. Медленнее то звено, которое реально медленнее в вашей системе.
По пропускной способности: DDR3-1600 на 4 канала (как у многих Xeon v3/v4 плат) — это ~51 ГБ/с теоретических, PCIe 3.0 x16 ~16 ГБ/с. То есть даже "медленная" квадро-канальная DDR3 обычно не является узким местом относительно шины - PCIe часто уже сам по себе медленнее. На одно-/двухканальных конфигурациях картина другая, там RAM действительно может быть куда более узким местом, чем на серверных платах с 4 каналами.
Так что “DDR4 обязательно” - упрощение не в вашу пользу: для MoE-архитектур с активным кэшированием решает не тип памяти, а (а) частота попаданий в GPU-кэш под вашу реальную нагрузку и (б) число каналов памяти, а не DDR3/DDR4 как таковой. У меня в статье тюнинг (
host-core sibling+expert-cache-per-layer) дал прирост без смены памяти вообще - то есть узкое место было не в пропускной способности ОЗУ, а в NUMA-локальности и организации кэша.
KYuri
09.11.2026 12:15сначала CPU должен прочитать вес эксперта из RAM, потом он едет по PCIe в VRAM
Это не совсем так. Strata построена на идее, что отсутствующих в VRAM экспертов не всегда оптимально туда тащить через узкое горлышко PCIe, а иногда их выгоднее отработать силами процессора.
Можно управлять тем, какая часть отсутствующих в VRAM экспертов будет гоняться через PCIe, через параметр “–pcie-frac”.
На моей нынешней системе автоподбор этого значения (через “–calibrate”) на тех моделях, что я использую, выбирает значения от 0.31 до 0.35. Т.е. 65-69% отсутствующих в VRAM экспертов у меня не гоняется через PCIe, а обсчитывается чисто процессором.
А ещё я буквально в прошедшую выходную среду проверял, достаточно ли для инференса на Strata собрать машину на слабом процессоре, или всё же и процессор/память тоже вклад дают.
Общая часть - 64ГБ DDR4-2400 в двухканале, RTX 3070M с 16ГБ VRAM, PCIe 3.0 x16.
Цифры для QFN 3.8 (iq3_s) по генерации получились такие (префилл на 80К контекста во всех случаях получился одинаковый ~1350 ток/сек):
Xeon E3-1260Lv5 (этот не умеет в память быстрее 2133, поэтому на этой частоте память и работала): 41-43 ток/сек
Xeon E-2136: 45-48 ток/сек
Ryzen 7 5750g: 50-52 ток/сек
К сожалению, не проверил на системе с райзеном, что бы поменяла установка DDR4-3200, но и так видно, что увеличение мощности процессора вполне себе трансформируется в увеличение скорости генерации. То есть лимитирует как минимум не только “узкое горлышко PCIe”.
starfair
09.11.2026 12:15Есть платы X99 которые под 2011-v3 и при этом вполне себе на DDR3, которая на самом деле, для STRATA не настолько уж и медленее. Я выше указал свой конфиг и не то чтобы очень быстрая генерация, но 60т/с при контексте в 200тыс токенов - вполне норм, как по мне. С учетом того, что мне 128Gb обошлись в 14 тыс р, менее месяца назад.

Ka463
Видео нужно было брать tesla P100, теже деньги, но памяти больше в два раза и шустрее
DmNep Автор
Вообще не планировал поднимать локальные модельки на этом железе. Всё это было взято на сдачу после покупки ibm ac922, на средства с распродажи "старого" компа с ddr4 и v100. Железо из статьи выбиралось по принципу 1 cpu с максимальной частотой (для 1с), большой объём копеечной ddr3, для постгрю, докера, виртуалок и т.д. А 1070 была взята, чтобы подключить все три монитора.
Внезапно понадобилась анцензорная моделька по-быстрому порешать вопросики, а 922 ещё не поднят.
StasTukalo
чем обоснован выбор этого железа? nvlink-ом? если не секрет- под какие задачи?
DmNep Автор
AC922 идеален, и я не понимаю, почему он стоит копейки. Ключевое - то, что у двух островов с видеочипами есть прямой доступ к ОЗУ, минуя процессор, на очень большой скорости. Это не общая память, как в DGX Spark, но по смыслу очень близко. Такого нет ни у кого из серверного железа, даже за несколько миллионов рублей. Например, покупая сервер с 8×V100 на 32 ГБ за неадекватные деньги, получаешь ту же самую шляпу с узким горлышком PCIe и тем же колхозом с прибиванием моделек гвоздями разными способами, какими пользуемся мы здесь. По факту AC922 спокойно будет возить на себе модели терабайтного класса, или полутерабайтного, но в несколько потоков.
Брал исходя из того, что:
Практически общая с GPU память закроет потребности, по ощущениям, на 4-5 лет.
Два острова с чипами позволят обучать свои модельки на очень высоких скоростях.
Многопоточность: одновременно будет тянуть всё, что нужно для прода домашних проектов, помогать мне кодить, и где-нибудь в уголке - когда не полностью загружен или когда задач вообще нет на всю катушку обучать свою модельку. Это серверное железо и оно сделано прямо на совесть, как раз стоять на балконе и маслать 24/7
StasTukalo
Да, звучит очень хорошо. Можете сказать какая конфигурация железа (память, гпу, видеопамять) и во сколько обошлось? Моя жабка начинает квакать потихоньку- я себе запилил на супермикровской матери под xeon 8370 с 512 ддр4 3200 - чисто тушка без гпу обошлась в 450тр - правда это новая комплектуха и год назад было до подорожания памяти, ну и 8 А5000 были с прошлых времен. А у вас наверное и железо получше и денег поменьше.. И самое главное у такого класса есть нвлинк промышленного исполнения, а не та бесполезная ерунда, которая сверху на pcie карточках (по крайней мере на амперах)..
DmNep Автор
Купил у Александра из Краснодара (Саша, привет! Думаю, ты читаешь этот пост). Обошлось в 165 без памяти, но с процессорами и шестью чипами по 16 ГБ. Сейчас в процессе постройки двухконтурной СОЖ - одноконтурная не пойдёт, т.к. радиатор будет примотан к кондиционеру на улице, и сервер весь покроется конденсатом, если не отделить контуры через теплообменник.
Память, по словам многих, кто этим пользовался, дешманская не встаёт, нужно плюс-минус Samsung брать. Но, по опыту с другими серверами, дешманская не встаёт, если забивать ею слоты частично, а не все сразу. Поэтому договорился с продавцом памяти, как только буду готов, он приедет с комплектом из 16 планок по 16 ГБ на 2133 МГц, и мы прогоним всё на сервере. Если всё ок - память будет по 5 тр за планку, если нет - покупка растянется минимум на несколько месяцев.
И тут снова выбор в пользу меньшей скорости ОЗУ: на AC922 она напрямую влияет на скорость, так как нет бутылочного горлышка в виде PCIe. За те же деньги я теряю 15-20% скорости генерации, но приобретаю ×2 по объёму памяти. Вместо 128/256/512 ГБ быстрой памяти получаю небольшую просадку в скорости, зато 256, 512 или 1024 ГБ на медленной ОЗУ.
StasTukalo
Спасибо.Успехов вам!