

Обычный рабочий день. Я занимаюсь плановой миграцией InfluxDB у очередного заказчика. И тут приходит тикет с пометкой «Срочно» и приглашение на ВКС. Подключаюсь, на экране – PostgreSQL-кластер.
Все серверы живы, но почему-то находятся в статусе Replica. В кластере нет ни одного Leader. Коллеги на той стороне объясняют: «Мы тут виртуализацию перезагрузили. После этого кластер как-то… в тыкву превратился». Высокая доступность внезапно стала очень недоступной.
Для бизнеса в этот момент не так важно, что именно произошло с Patroni, etcd или PostgreSQL. Важно другое: приложение не может подключиться к базе, пользователи не работают, а простой продолжается.
Я ведущий системный инженер, занимаюсь эксплуатацией ИТ-инфраструктуры и баз данных в компании «Онланта». За время работы успел увидеть сотни аварий. Некоторые из них действительно лечатся очень быстро. Другие заставляют восстанавливать события буквально по минутам и проверять гипотезы, которые сначала кажутся совершенно нелепыми. В этой статье я расскажу о нескольких таких историях из своей практики. Возможно, что-то из моего опыта поможет вам однажды потратить на инцидент меньше времени.
Я заметил закономерность, что аварии можно условно разделить на два типа. Первые – быстрые и болезненные. Их причина проста, исправление занимает минуты, которые все же кажутся вечностью, пока лежит продакшн. Вторые – те самые аварии, причины которых упорно скрываются. При этом мониторинг почти ничего не показывает, сервисы вроде бы живы, логи выглядят нормально, но система не работает так, как должна. Давайте поговорим об этих историях подробнее.
Быстро, больно и очень банально
Есть одна плохая привычка, которая регулярно появляется во время аварии. Когда что-то серьезно ломается, очень хочется сразу искать главную причину и проверять все сразу. Особенно, если перед глазами кластер высокой доступности, несколько серверов, репликация, балансировщик, виртуализация и еще десяток связанных компонентов. А потом выясняется, что PostgreSQL просто не слушает нужный адрес. Или место на диске закончилось еще час назад. Или конфигурацию поменяли в /etc/postgresql/.../postgresql.conf, а конкретный экземпляр читает файл из другого каталога.
В одной аварии мы подозревали проблемы с кластером, пока кто-то не проверил очевидное:
ss -lntp | grep 5432 – пусто;systemctl status postgresql – сервис запущен.
SHOW listen_addresses – и здесь все становится интереснее:
listen_addresses
------------------
127.0.0.1
База полностью исправна, но приложение находится на другом сервере и физически не может до нее достучаться.
Другой любимый мной классический сценарий, когда инженер абсолютно уверен, что изменил параметр, но PostgreSQL с ним почему-то не согласен. В этом случае особенно полезна команда SHOW config_file. Она иногда экономит гораздо больше времени, чем очередной просмотр grep -R по /etc. И, конечно, классика жанра - df -h, которая внезапно сообщает, что самый важный filesystem в системе заполнен на 100%.
Еще один сюрприз – это память. PostgreSQL может не успеть ничего полезного написать в собственный лог, потому что процесс просто станет жертвой OOM killer на уровне Linux. Проверка dmesg -T | grep -i "out of memory\|killed process" и вместо загадочного «PostgreSQL сам упал» внезапно появляется вполне конкретная причина Out of memory: Killed process 18421 (postgres)
total-vm:...
anon-rss:...
Пожалуй, это и есть главное правило быстрых аварий – не начинать расследование с самой сложной гипотезы. Сначала – сеть, процесс, конфигурация, права, место на диске, память. И довольно часто «серьезная авария» оказывается одной из этих банальностей. Но что делать, если все очевидное уже проверено, а база по-прежнему работает неправильно?
Когда стандартные чек-листы не работают
Самые запоминающиеся аварии – те, где стандартный алгоритм заканчивается, а ответа все еще нет. Происходит примерно следующее: systemctl говорит, что сервис работает, df показывает свободное место, мониторинг отображается зеленым, CPU не зашкаливает, памяти хватает, логи не содержат ничего похожего на катастрофу. И все равно что-то сломано. Возникает вопрос: «Какая последовательность событий привела систему в это состояние?» Здесь начинают проясняться действительно интересные вещи.
Кейс №1. Место встречи изменить нельзя. Или все-таки можно?
Утром мониторинг показывает проблемы. На одном из серверов базы заканчивается место. Первое предположение очевидное, что кто-то записал слишком много данных. Смотрим df -h /db/PGDATA.
На реплике:
Filesystem Size Used Avail Use% Mounted on
/dev/sdb1 980G 972G 8G 99% /db/PGDATA
Дальше смотрим каталог PostgreSQL. Оказывается, основная проблема – совсем не таблицы. Быстро растет каталог с WAL. Проверяем состояние репликации:
SELECT
     application_name,
     client_addr,
     state,
     sent_lsn,
     write_lsn,
     flush_lsn,
     replay_lsn
FROM pg_stat_replication;
На primary видно, что одна реплика сильно отстала. На первый взгляд все логично: реплика не успевает получать изменения, поэтому WAL на primary растет. Но есть одна странность, которая заставляет задуматься, почему это произошло именно сегодня.
Начинаем восстанавливать события по времени. Около 00:00 стартовал резервный бекап. Почти одновременно аналитическая команда запустила большую выгрузку данных. И вот тут начинается цепочка.
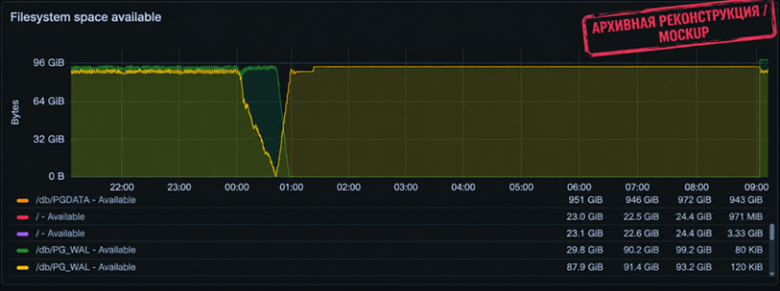
00:00 – начало выполнения бекапа с активной реплики,
00:07 – старт аналитического запроса на мастер-ноде,
00:15 – резкий рост нагрузки на мастере,
00:20 – активная реплика начинает отставать,
00:30 – журналы на активной реплике начинают быстро накапливаться,
00:35 – на активной реплике заканчивается место,
00:40 – репликация прерывается,
00:45 – WAL начинает быстро расти уже на мастер-ноде,
00:50 – процесс бекапа прерывается с ошибкой, временный слот под бекап удаляется, место на реплике высвобождается. Но процесса репликации уже нет, мастер и реплика в рассинхроне.
Самое неприятное в подобных авариях то, что каждый компонент по отдельности делает ровно то, что должен: backup, выгрузка данных, PostgreSQL работают. Репликация тоже работает до тех пор, пока реплика не упирается в filesystem. Никакого сломанного сервиса нет. Есть только комбинация совершенно штатных процессов.
На реплике заканчивается место, PostgreSQL больше не может нормально принимать WAL, репликация останавливается. После этого primary продолжает принимать изменения. Поскольку механизм хранения WAL-файлов (retention) рассчитан на то, что реплика регулярно их забирает и применяет, при остановке репликации WAL начинают накапливаться на мастере сверх обычного объема и в итоге могут переполнить диск уже на основном сервере.
Мы дополнительно обнаруживаем еще один интересный момент: сам бекап тоже завершился с ошибкой. Эта ошибка сначала уводит расследование в сторону резервного копирования. В логах:
pg_dump: error: server closed the connection unexpectedly
На первый взгляд виноват бекап. Но на деле он стал уже следствием общей проблемы.
После восстановления системы мы построили графики по времени: свободное место, lag-реплики, объем WAL и запуск бекапа. Картина оказалась очень показательной. Затем мы изменили расписание нескольких тяжелых операций, добавили отдельные алерты на скорость роста WAL и перестали смотреть только на абсолютный объем занятого диска. Потому что «свободно 20%» и «было свободно 20%, но за последние 30 минут исчезло 15%» – это две совершенно разные ситуации.
Что здесь оказалось важным. До аварии каждый компонент мониторился отдельно. После аварии мы начали смотреть на связи между ними. Это, пожалуй, один из самых полезных уроков. В сложной инфраструктуре авария часто возникает из-за того, что несколько совершенно исправных механизмов встретились в неудачный момент.
Кейс №2. Мы искали проблему в PostgreSQL. Она оказалась в etcd
Этот случай был еще интереснее. Пользователи жалуются на деградацию работы базы. Запросы стали работать заметно медленнее. При этом PostgreSQL на первый взгляд здоров:
CPU – 38%
RAM – 61%
Disk – 52%
Connections – в норме,
Replication – в норме.
На графиках все выглядит прилично, но одновременно инженер пытается изменить параметр кластера и получает ошибку. То есть база вроде бы работает, но управление кластером уже ведет себя странно. Проверяем Patroni:
patronictl list
Получаем что-то в этом духе:
+ Cluster: prod-postgres -----------+
| Member | Host | Role |
+--------+-------------+------------+
| pg01 | 10.10.1.11 | Leader |
| pg02 | 10.10.1.12 | Replica |
| pg03 | 10.10.1.13 | Replica |
+--------+-------------+------------+
Выглядит прекрасно. Проверяем PostgreSQL. Вроде тоже все хорошо. Пробуем снова изменить параметр через Patroni и получаем:
ERROR: failed to update dynamic configuration
Вот здесь появляется первая подсказка: dynamic configuration.
Patroni хранит состояние кластера не в PostgreSQL. У нас используется etcd. Проверяем его состояние:
etcdctl endpoint health
И получаем:
127.0.0.1:2379 is unhealthy:
failed to commit proposal: raft proposal dropped
Смотрим размер базы etcd:
etcdctl endpoint status --write-out=table
Мы видим, что бэкенд уже разросся значительно сильнее ожидаемого. После анализа выясняется, что механизм автоматического обслуживания не отрабатывал так, как предполагалось. etcd продолжал накапливать историю, база росла, а нормальная работа с ней становилась все тяжелее. Причина деградации PostgreSQL находилась вообще не в PostgreSQL.
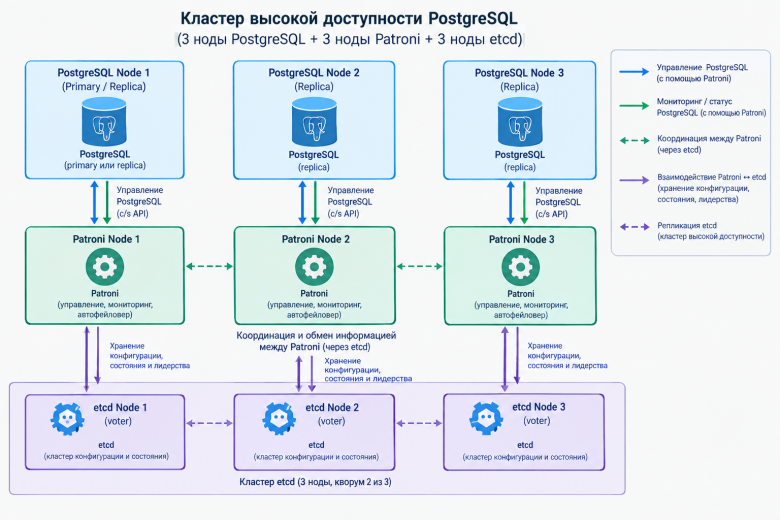
Это хороший пример того, почему мониторинг одного сервиса редко бывает достаточным. Можно иметь идеальный мониторинг PostgreSQL и при этом совершенно не видеть, что компонент, который управляет кластером, постепенно подходит к критическому состоянию. После этого случая в мониторинг добавились проверки состояния etcd, размера backend, проблем с quorum и нескольких внутренних метрик Patroni. А главное – появилась привычка задавать вопрос, от чего зависит этот компонент. Потому что система редко ломается изолированно.
Кейс №3. Логи были. Только не те
Третий случай был особенно неприятным. После аварийного перезапуска несколько серверов PostgreSQL поднялись, но кластер оказался в неправильном состоянии. Проверяем systemctl status patroni. Сервисы работают. Проверяем patronictl list и видим странную картину: узлы доступны, но ожидаемого Leader нет.
Первый вопрос – «Что пишет Patroni?» Открываем лог. Пусто – там нет ничего, что объясняло бы проблему. После очередного запуска и проверки становится понятно, что проблема в том, что мы читаем не те логи.
Оказалось, что после изменения конфигурации логирование PostgreSQL и Patroni было перенастроено, а часть старых файлов осталась в привычном каталоге. Инженер открывал файл с актуальным именем, но фактически смотрел старую ротацию. После поиска реального файла картина резко меняется. В журнале появляется:
FATAL: no pg_hba.conf entry for host "10.10.12.45",
user "app_user", database "production_db", SSL off
Проверяем pg_hba.conf.
Файл синтаксически корректный. PostgreSQL его принимает. Но логика правил не соответствует тому, что ожидалось. Более того, конфигурация генерировалась автоматически после изменения состояния кластера.
Получается неприятная ситуация: сгенерированный файл валиден, PostgreSQL его принимает, но результат работы приложения становится полностью неправильным. Синтаксическую ошибку компьютер найдет сам. Логическую – далеко не всегда.
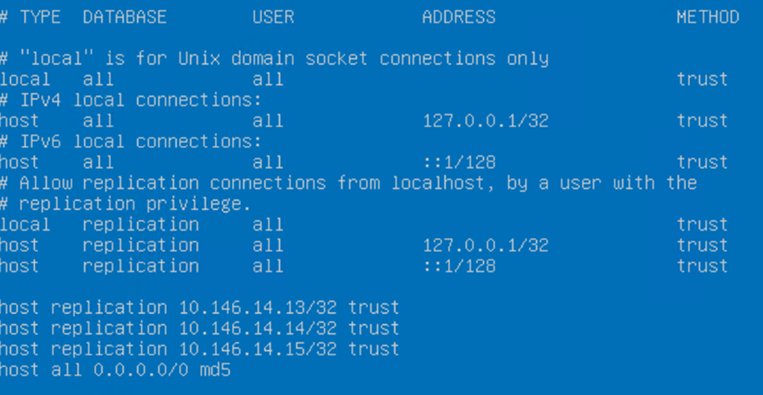
В итоге кроме наличия конфигурационного файла мы начали проверять его актуальность, источник генерации и фактическое содержимое после перезапуска. Для таких вещей очень важно проверять то, что реально задействовано в процессе. Например:
SHOW hba_file;
SHOW config_file;
Затем уже смотреть stat /var/lib/postgresql/.../pg_hba.conf и сравнивать время изменения с моментом аварии.
После этого мы добавили автоматическую проверку актуальности конфигурации и отдельно контролируем несколько критичных правил доступа. Потому что конфиг может существовать, читаться, успешно загружаться, быть синтаксически корректным, но при этом полностью ломать работу системы.
Что общего у этих трех аварий
Здесь есть одна общая черта – проблема не находилась там, где ее искали в начале. Это, пожалуй, самая сложная часть работы с большими системами. Когда PostgreSQL не принимает подключения, хочется смотреть PostgreSQL. Когда кластер работает нестабильно, хочется смотреть Patroni. Но иногда ответ находится на один уровень выше или на два уровня глубже. Поэтому хорошее расследование инцидента для меня начинается с вопроса, что происходило перед тем, как это сломалось.
Лучший инцидент – тот, которого не произошло
Разобраться с аварией – важная часть работы. Но гораздо интереснее сделать так, чтобы следующую аналогичную аварию удалось обнаружить еще до того, как она проявится. После таких историй обычно появляются не новые героические инструкции для дежурного инженера, а довольно скучные вещи:
мониторинг заполнения диска;
контроль роста WAL;
репликационный lag;
состояние etcd;
проверка резервного копирования;
контроль конфигураций;
централизованный сбор логов;
алерты на необычные изменения поведения системы.
Они же оказываются самыми полезными. Потому что график, который за сутки до аварии показал аномальный рост WAL, гораздо ценнее красивого отчета о том, как мы потом три часа героически восстанавливали PostgreSQL.
Мониторинг — это не просто зеленые графики
Очень легко построить систему, которая показывает поломку. Гораздо сложнее сделать так, чтобы она показала, что через несколько часов здесь будет проблема. Поэтому кроме текущих значений важна динамика. Например, не просто: Disk usage = 82%, а Disk usage = 82%. Рост: +7% за последние 40 минут.
Хороший мониторинг постепенно превращается в систему раннего обнаружения проблем. Человек физически не может постоянно сидеть и проверять десятки баз, десятки реплик, бекап, диски, логи, кластеры и все зависимые сервисы. Зато автоматизированная система вполне может сообщить: «Здесь пока все работает, но что-то пошло не так». И это гораздо более полезное сообщение, чем «все уже сломалось».
Вместо заключения
Сложные аварии мне нравятся, потому что они показывают, как на самом деле устроена инфраструктура. На схеме все выглядит аккуратно:
Application → PostgreSQL → Patroni → etcd
Но в реальности поверх этой схемы еще существуют бекап, мониторинг, виртуализация, сеть, файловые системы, cron, Ansible и десятки других вещей. И настоящая авария очень редко уважает границы между этими компонентами. Сегодня проблема начинается с диска на реплике, завтра – с etcd. А послезавтра все работает, просто приложение не может подключиться к базе из-за одной строки в pg_hba.conf.
Поэтому после каждого серьезного инцидента я стараюсь оставить после себя не только восстановленную систему, но и ответ на три вопроса.
1. Почему это произошло?
2. Почему мы не заметили это раньше?
3. Что теперь не даст этому повториться?
Пожалуй, именно в этом и заключается разница между задачей починить базу и действительно заниматься ее эксплуатацией.
А какие самые странные причины аварий встречались у вас? Бывало ли, что PostgreSQL выглядел полностью исправным, а проблема в итоге находилась где-нибудь совсем рядом – в сети, виртуализации, мониторинге или вообще в другом сервисе?
Поделитесь историями в комментариях. Уверен, среди них найдется немало случаев, после которых команда тоже стала смотреть на свою инфраструктуру немного иначе.