

Я делаю свою линейку маленьких языковых моделей dpp-gpt. Не файнтюн чужой модели, а всё с нуля: токенизатор, претрейн, SFT, RL, бенчмарки. Всё это на одной домашней видеокарте RTX 4060 с 8 ГБ памяти. Недавно вышла версия 2.2 Pro на 260 миллионов параметров. В статье расскажу, как она устроена, что получилось, что нет, и какие неожиданные вещи всплыли по дороге.
Сразу честно: это не конкурент моделям, обученным большими командами на триллионах токенов. На общепринятых английских бенчмарках она отстаёт даже от самых маленьких из них (бенчмарки ниже). Интересна она другим: тем, сколько можно выжать из одной видеокарты, и тем, что видно изнутри.
Что это за модель
Параметры |
259M (242M уникальных: эмбеддинги входа и выхода общие) |
Архитектура |
как у Llama: RMSNorm, RoPE, SwiGLU, GQA |
Слои / ширина / головы / KV-головы |
20 / 1024 / 16 / 4 |
Контекст |
8192 токена |
Словарь |
16 384, свой BPE, цифры отдельными токенами |
Языки |
русский, английский, французский |
Претрейн: 31 миллиард токенов
2.2 продолжает претрейн базовой версии 2.1: к её 11.8 млрд токенов я долил ещё около 19 млрд, всего примерно 31 млрд. Смесь:
Википедия на трёх языках: 23%;
CulturaX (веб) на трёх языках: 13%;
код на Python: 16%, веб-код: 5%;
Cosmopedia и Zyda-2: по 5%;
стихи 4%, факты 5%, переводы 5%;
синтетика по работе с текстом (написание по буквам, анализ слов, капс): 4%;
синтетический код, написанный deepseek 4 flash: 1%;
математика: 14%.
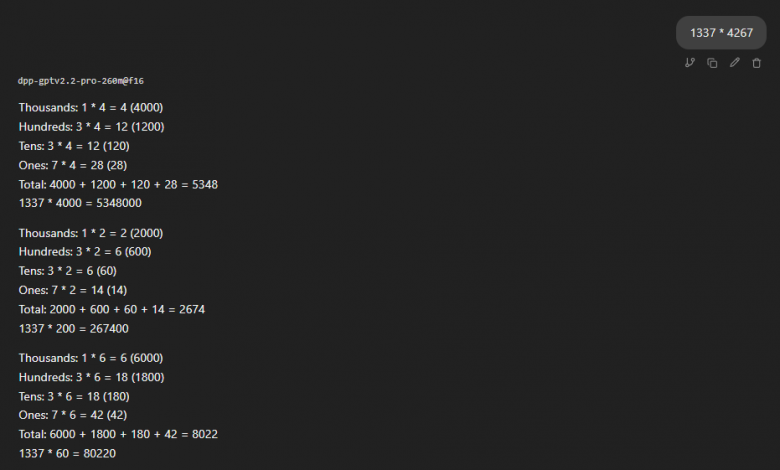
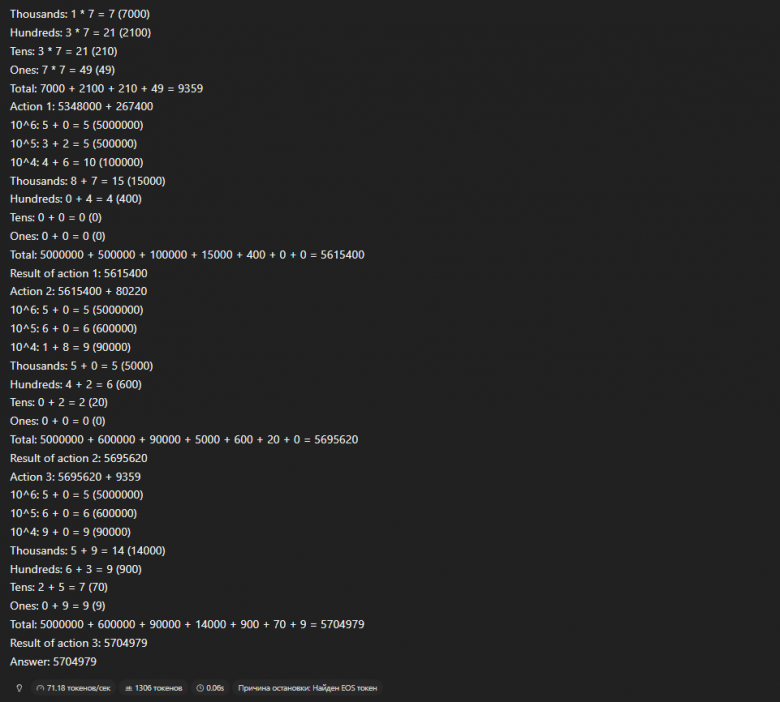
Математика сгенерирована скриптом, с поразрядным счетом. Благодаря этому модель может считать большие числа. Пример формата:
Действие 1: 290 * 3
Сотни: 2 * 3 = 6 (600)
Десятки: 9 * 3 = 27 (270)
Единицы: 0 * 3 = 0 (0)
Итого: 600 + 270 + 0 = 870
Ответ: 870
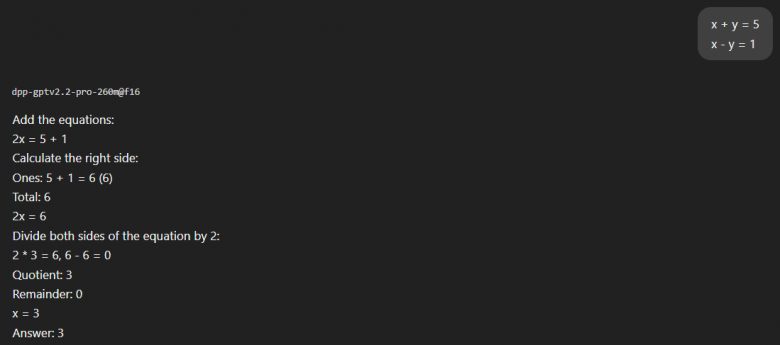
В предыдущей версии модели тоже был пошаговый поразрядный счет, однако в новой версии стало больше более сложных и разнообразных примеров. Генераторы покрывают сложение и вычитание чисел до 40 знаков, умножение, деление с остатком, скобки, уравнения, дроби, системы. Каждый ответ считается Python, так что ошибок в данных нет.
SFT: 60 миллионов токенов
SFT-датасет вырос с 16.5 млн токенов у 2.1 до 60 млн, это около 122 тысяч диалогов. При обучении 68% примеров брались из них, остальные 32% были повтором претрейна, чтобы модель не забывала базу.
общий чат на трёх языках (86 тем, 431 подтема, многоходовые разговоры): 27.7 тыс. диалогов, 15.4 млн токенов;
следование инструкциям (системные промпты, роли, форматы, списки): 35.7 тыс., 9.8 млн;
математика с решениями: 13.8 тыс., 7.7 млн;
код на Python: 11.5 тыс., 5.4 млн;
сочинения: 2.0 тыс., 4.5 млн; стихи: 2.2 тыс., 1.7 млн;
работа с текстом: 4.4 тыс., 3.7 млн;
иголка в стоге сена (найти факт в тексте до 6000 токенов): 1.4 тыс., 3.0 млн;
вызов инструментов: 3.1 тыс., 1.5 млн;
JSON по описанию: 2.4 тыс., 1.1 млн;
переводы: 6.1 тыс., 1.0 млн;
факты: 9.0 тыс., 0.7 млн;
Почти всё сгенерировано DeepSeek через OpenRouter. Каждый ответ с числами пересчитан и проверен кодом. На данные для 2.2 ушло около 3000 рублей.
Результат SFT я выложил как 2.2 Pro preview. Неприятный момент: SFT просадил математику. У базовой модели было 47.6% на моём математическом бенчмарке, у первого SFT 26%, после подбора смеси 36.8%. Вернуть её стало одной из целей следующего этапа.
RL (GRPO) на 8 ГБ видеопамяти
Финальная 2.2 Pro получена обучением с подкреплением (GRPO) поверх preview. Суть GRPO: на каждый запрос модель пишет несколько ответов (у меня 8), каждый получает награду, и модель учится на разнице между ответами внутри группы. Награда за ответы выдается либо кодом, либо моделью-судьей, в зависимости от типа задачи.
Код проверял:
арифметику и уравнения;
школьные текстовые задачи;
Python: код запускается на тестах;
JSON по описанию;
поиск числа в тексте;
инструкции к форме ответа;
вызов инструментов в разных форматах и ответ по результату инструмента;
перевод (по сходству с эталоном).
Сочинения, стихи и ответы о фактах оценивал локальный судья Gemma 4 E4B.
Ещё одна полезная вещь: подбор сложности. Если модель какой-то тип задач решает всегда или не решает никогда, все 8 ответов получают одинаковую награду, и учиться нечему. Такие типы задач выбираются реже, а те, где модель решает примерно половину, чаще.
Всего было 9 прогонов GRPO. Я улучшал оценку, чтобы она проверяла больше разных проблем, и следил, чтобы не было перекоса под бенчмарк или какую-то узкую тему. Например, в первых прогонах награду за текст считал код по косвенным признакам, и модель научилась обманывать её короткими ответами: сочинения и общие вопросы сломались. Пришлось добавить судью и перебалансировать обучение. Но потом очевидные проблемы вроде бы закончились, и дальнейшего роста не было: каждый следующий чекпоинт где-то выигрывал, а где-то терял, и среднее упёрлось примерно в одно значение. Помогло неожиданно простое: усреднение весов нескольких чекпоинтов. Финальная модель — это 0.4 · GRPO8 + 0.3 · GRPO9 + 0.3 · GRPO5. Такой суп оказался лучше каждого отдельного чекпоинта.
Бенчмарки
Свой набор
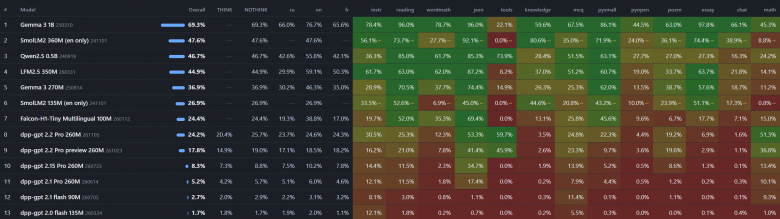
Я сделал свой набор под эту линейку: 12 областей, 2450 вопросов на трёх языках, каждый задаётся дважды (с мыслями и без). Всё, что можно, проверяет код; стихи, сочинения, чат и знания оценивает Gemma 4 26B. Плюс отдельный математический бенчмарк на 2200 задач.
Важная оговорка: набор сделан под мои форматы, поэтому подыгрывает dpp-gpt. А часть задач RL сделана теми же генераторами, что и часть бенчмарков (с другими числами и формулировками).
Модель |
Среднее |
instr |
json |
tools |
pysmall |
math |
|---|---|---|---|---|---|---|
2.2 Pro |
24.2 |
30.5 |
53.3 |
59.7 |
22.3 |
51.3 |
2.2 Pro preview |
17.8 |
16.2 |
41.4 |
45.9 |
9.7 |
36.8 |
2.15 Pro |
8.3 |
14.4 |
34.7 |
0.0 |
5.2 |
13.4 |
2.1 Pro |
5.2 |
12.1 |
17.4 |
0.0 |
4.4 |
10.1 |
2.0 Pro |
1.1 |
8.2 |
1.6 |
0.0 |
0.0 |
0.3 |
Gemma 3 270M |
36.9 |
28.9 |
74.4 |
14.9 |
62.0 |
11.2 |
SmolLM2 135M |
26.9 |
33.5 |
45.0 |
0.0 |
43.2 |
0.8 |
Falcon-H1-Tiny 100M |
24.4 |
19.7 |
69.4 |
0.0 |
45.6 |
15.0 |
За одно поколение среднее выросло с 8.3 до 24.2. 2.2 Pro впереди всех в арифметике и вызове инструментов, но в среднем примерно на уровне Falcon-H1-Tiny и позади Gemma 3 270M. Полная таблица по всем 13 колонкам — в карточке модели.
Общепринятые бенчмарки
Чтобы цифры можно было честно сравнить с чем угодно, я прогнал lm-evaluation-harness с одинаковыми настройками для всех моделей. Это только английский.
Модель |
HellaSwag |
ARC-Easy |
PIQA |
GSM8K |
IFEval (строго) |
|---|---|---|---|---|---|
dpp-gpt 2.2 Pro |
28.9 |
39.2 |
57.7 |
1.8 |
14.1 |
Gemma 3 270M |
39.3 |
55.3 |
65.6 |
8.6 |
25.5 |
SmolLM2 135M |
42.9 |
54.0 |
66.7 |
1.7 |
22.7 |
SmolLM2 360M |
56.7 |
56.6 |
71.6 |
8.9 |
32.4 |
случайный выбор |
25 |
25 |
50 |
0 |
Здесь картина без прикрас: 2.2 Pro выше случайного угадывания, но заметно позади всех. Базовая модель без SFT набирает на HellaSwag столько же (28.8), так что дело не в файнтюне, а в претрейне: 31 млрд токенов против триллионов, причём на трёх языках и с большой долей синтетики. RL эти бенчмарки не сдвинул: preview и финал здесь в пределах погрешности. Его выигрыш в другом: в арифметике, инструментах, JSON и инструкциях.
Что умеет и что нет
Умеет:
считать длинные числа по разрядам и решать простые уравнения по шагам;
вызывать инструменты (и не вызывать, когда не нужно), отвечать по результату;
писать JSON по описанию, выполнять простые инструкции к форме ответа;
брать имя и роль из системного промпта;
разговаривать, писать стихи и простой код на трёх языках.
Не умеет или умеет плохо:
умножение 5–6-значных чисел (верно примерно в 30% случаев);
держать счёт через несколько сообщений («было 5 яблок, съел 3, потом купил ещё 3»);
следовать инструкциям вроде «ответь одним словом» или «ответь по-английски»;
сочинения, факты, сложный код;
мысли в среднем пока не помогают: без них ответы немного лучше.
Вызов инструментов работает только в том формате, на котором модель училась (пример в карточке модели).
Что дальше
2.2 flash (около 140M) сейчас дообучается на немного улучшенных данных: Python код (из-за ошибки в Python-датасете 260M-версии Python составлял лишь 14%, а всё остальное было другими языками; теперь это исправлено), более очищенная Википедия, FineWeb-Edu и FineWeb2.
2.3: увеличу словарь до 32k и слои до 28, часть слоев сделаю с локальным вниманием: это ускорит обучение и инференс примерно на 20-30% (не проверял точно), а перплексия без дообучения вырастает всего на 2%. Плюс новые данные, включая много рассуждений.
Если интересно следить или есть вопросы, пишите в комментариях. Модель: huggingface.co/dikiyplayerpig/dpp-gpt-V2.2-Pro-260m
Комментарии (10)

lieff
09.11.2026 17:53Хотелось бы раскрытия как имено работает GRPO, это ваш код, или питон фреймворк? Что именно он делает с весами на каждой итерации итд.

dikiyplayerpig Автор
09.11.2026 17:53Код свой, на чистом PyTorch, без TRL и других фреймворков. Архитектура модели обычная (как у Llama), но обучение, генерация и формат чекпоинтов у меня свои. Проще было дописать GRPO к ним, чем переводить всё под готовые библиотеки, тем более что на 8 ГБ пришлось экономить память своими способами.
Одна итерация (шаг) устроена так:
1) Генерация. Беру задачу и генерирую на неё группу из 8 ответов с ненулевой температурой, плюс пару ответов с повышенной, чтобы ответы различались. Генерирует отдельная копия модели в bf16, так быстрее.
2) Оценка. Почти всё проверяет программа:
- математика: сверяется ответ;
- код: запускаются тесты, награда тем больше, чем больше тестов прошло;
- инструкции: проверяется выполнение условий (длина, формат, нужные слова и т.д.);
- вызовы инструментов: формат, имя и аргументы;
- переводы: близость к эталону и язык ответа;
- тесты с выбором ответа.
Модель-судья Gemma 4 E4B оценивает только то, что программой не проверишь: сочинения, стихи, факты. Её оценка складывается с оценкой программы. Если ответ зациклился, оборвался или написан не на том языке, до судьи он не доходит. Судья работает параллельно с обучением, и такие группы учатся на следующих шагах, когда оценки готовы.Преимущество. Внутри группы считаю, насколько каждый ответ лучше или хуже среднего: (награда − среднее) / разброс. Если все ответы получили одинаковую награду, группа пропускается: учиться не на чем. Что происходит с весами. Логарифм вероятности токенов каждого ответа умножается на его преимущество. Градиент делает вероятнее ответы лучше среднего и менее вероятными ответы хуже. К этому добавляется штраф за отклонение от исходной модели (KL, коэффициент 0.05), чтобы модель не ломала язык ради награды.
Повтор SFT. В каждый шаг подмешиваю 12 примеров из обычного SFT с небольшим весом, чтобы модель не забывала остальное.
Шаг оптимизатора. Один шаг AdamW (8-бит) с LR 0.000003 и ограничением нормы градиента 1. Потом веса копируются в генератор, и всё повторяется. Ещё пара деталей: задачи подбираются по сложности: слишком лёгкие и слишком сложные дают одинаковые награды во всей группе и ничего не дают обучению; температура генерации подстраивается сама, чтобы ответы в группе оставались разными.

olku
09.11.2026 17:53Любопытно. Если ли обучалки для сборки своей модели, которую можно обучить, скажем, программировать на языке, у которого есть спека но нет открытого кода?
dikiyplayerpig Автор
09.11.2026 17:53С нуля, как я, не получится: модели нужны миллиарды токенов кода, а по такому языку их нет. Реальный путь — взять готовую модель (например, Qwen3 8B) и дообучить её. Для этого есть готовые обучалки: Unsloth, LLaMA-Factory, Axolotl, TRL. С LoRA/QLoRA модель на 1.5–8B помещается на одну игровую видеокарту (для 8B понадобится 10-16 гб).
Главное — данные, и их можно сгенерировать. Даёте большой модели спецификацию в контекст и просите писать программы с объяснениями. Если есть компилятор или интерпретатор, пусть даже закрытый, прогоняйте на нём примеры и оставляйте только рабочие: это сильно поднимает качество. Без возможности запуска проверять примеры трудно.
Иногда можно обойтись вообще без обучения: положить спецификацию в контекст сильной модели. Обучать имеет смысл, если язык большой и не влезает в контекст или нужна маленькая локальная модель.

Kiryoka
09.11.2026 17:53Советую скормить модели на SFT датасет OpenThoughts3-1.2M и потом начать интерактивное обучение на (типо RL) игре где нужно рассуждать чтобы выигрывать
dikiyplayerpig Автор
09.11.2026 17:53Спасибо! Смотрел на такие наборы, но есть сложности:
рассуждения там длиной в тысячи токенов, а весь набор — порядка 6-7 млрд токенов. Это в 100 раз больше всего моего SFT (~60 млн), и даже один проход по нему занял бы около недели;
он почти целиком на английском, а у меня ещё русский и французский;
моей модели длинные мысли пока скорее мешают: в 2.2 даже короткие чаще ухудшают ответ. Есть работы о том, что маленькие модели плохо учатся на длинных рассуждениях больших и им лучше подходят короткие. К тому же, задачи в этом датасете олимпиадные. А моя модель очень маленькая. Она с трудом решает задачи первого класса, так что вряд ли она сможет так рассуждать.
Возможно, возьму из него часть с короткими ответами.
Идея с игрой хорошая. На последнем этапе я как раз делал RL (GRPO), но на задачах, где ответ можно проверить программой: математика, код, инструкции. Головоломки и игры, где ход проверяется кодом, туда хорошо ложатся. Подумаю над этим для следующей версии.
Dark_lion
Крутая история, однако нет времени.
Сколько по времени занял каждый этап?
Какой результат по отношению к начальной цели?
Где датасет для подражателей? Сколько он весит?
Почему такой выбор слоев?
Хотелось бы побольше подробностей о подготовке.
И конечной стоимость каждого этапа в часах людей, электричества и часов работы?
И чего не хватило догнать рынок пр качеству обучения?
dikiyplayerpig Автор
Спасибо! По порядку: Время. Чистое время видеокарты: претрейн базы 2.1 (11.8 млрд токенов) около двух недель, дообучение базы до 2.2 (ещё 19 млрд токенов, ~10 тыс. токенов/с) около трёх недель. Сам SFT короткий: финальный прогон ~11 часов, но вместе с подбором смеси и генерацией данных ушло около трёх недель. (Данные генерировались параллельно с претрейном, а на само обучение на которое ушло несколько попыток потратилось около недели). GRPO: около 4-5 суток работы видеокарты, календарно около двух недель вместе с бенчмарками.
Результат против цели. Цель 2.2: заметно поднять качество после 2.1, сделать так, чтобы мышление помогало, а не ухудшало ответ и сохранить сильную арифметику. Мысли все еще вредят в большинстве случаев. Почему именно, наверняка не знаю, вероятно, данных мало, и сами мысли далеко не идеальные в датасете. + претрейн маленький, возможно это тоже имеет вес. Вообще мало моделей подобного размера у которых есть мышление, но например qwen 3 0.6B думает, и ему мысли помогают. (Он в ~2.5 раза больше, но чать разницы (около 155м параметров) из за большого токенизатора, который на способность мыслить почти не влияет, так что он близок по размеру).
Датасет. Претрейн собран из открытых наборов (Википедия, CulturaX, Cosmopedia, Zyda-2, код) плюс своя сгенерированная математика, на диске это около 155 ГБ текста. SFT-диалоги весят около 200 МБ (~60 млн токенов). SFT-датасеты выложу позже, когда будет готова вся линейка 2.2.
Почему такие слои. 20 слоёв × 1024 достались от 2.1. 20 x 1024 мне казалось наиболее сбалансированным, так как нет перекоса в глубину или ширину и влезает мне в память. Словарь 16k выбран, чтобы не тратить параметры на эмбеддинги. Для эксперимента я обучал модели на 90м параметров, у одной 3 слоя, и широкий эмбеддинг, у другой 48 слоев и узкий эмбеддинг. Эксперименты показали, что при том же числе параметров глубина важнее ширины, в целом многослойная версия была во всем лучше 3 слойной. Так же была 11-слойная - она тоже уступала 48 слойной, но не так сильно. поэтому в 2.3 будет 28 слоёв. Из минусов - это увеличит размер модели, примерно до 350м параметров, и чем больше слоев тем дольше учится модель - 48 слойная 90м училась вдвое медленнее чем 3 слойная. Но 20 слоев x 1024 я ставил давно, и с того момента немного оптимизировал код, так что увеличенный конфиг должен влезть в память.
Стоимость. API для генерации данных: около 3000 ₽ на 2.2 (6000 ₽ на все версии). Электричество: видеокарта RTX 4060, потребляет 115 ватт, сколько времени работала сказано выше. Сколько часов моей работы было потрачено трудно сказать наверняка, я не считал и не документировал это.
Чего не хватило до рынка. В первую очередь масштаба данных: 31 млрд токенов против 2–6 трлн у SmolLM2 и Gemma. Во вторую очередь (хотя, может, это даже важнее) - качества данных. Я не знаю какой SFT датасет у google и других, но скорее всего он больше и качественнее. Претрейн тоже у меня неидеален, буду искать более качественные данные в будущем. GRPO - то же самое, он неидеален. Так же другие модели дистиллировали из более больших, я нет. Не знаю сколько это даёт прироста, сколько это занимает времени и как реализовать, этим не занимался так что больше не скажу.
Dark_lion
Большое спасибо за подробный ответ.
Еще вопросики возникли:
1. Почему не взяли для обучения датасет DeepSeek R1 distrill? Именно эта модель на 1.5b всех рвет по математике, а вы как я понял начали тренировку именно ради математики. И дипсик вроде бы поделились датасетом на эту модель.
2. У них еще есть очень занятный алгоритм обучения для 1.5B модельки. Даже сейчас их модель и алгоритм обучения считается лучшим. Но глядя на новые нейронки они скорее всего шагнули еще дальше, более чем за год после публикации алгоритма.
Алгоритм политики группового обучения https://github.com/vivekvar-dl/GSPO-DeepSeek-R1-Distill-Qwen-1.5B
3. Зачем грузить модель расчетами, если можно загрузить модель алгоритмами расчетов и дать ей встроенный калькулятор?
Т.е. модель делает по алгоритму программу для расчета и все это заливает в питон, скрипт и получает ответ через инструмент? (потери в данном случае меньше 5 секунд)
P.S. Жду новые публикации по обучению нейронки.
У меня есть 4090 24гб. Можем попробовать на выходных ее загрузить обучением (на неделе работает над другими проектами) . Планирую на 48гб сделать апгрейд.
Далее сможем создать MOE модель маленькую, но которая порвет весь мир по качеству прохождения тестов. С алгоритмом обучения дипсик это вполне достижимо.
Недавно прочитал статью, которая пишет, что нейронка при размышлении на русском языке имеет выше % эффективности, потому есть желание создать нейронку полностью на русском языке с кучкой экспертов и зажать ее по максималке, чтобы на 8гб памяти входило.
Другими словами даже создав маленькую нейронку на руском языке, можно позднее докрутить экспертов и сделать лучшую в мире небольшую нейронку.
Пока гиганты соревнуются в продаже крупных серверов мы сможем повторить успех дипсик и создать, что-то по настоящему стоящее, но здесь в России.
На маленькие нейронки с большим качеством всегда будет спрос из-за распределения ресурсов в мире и экономии электричества.
dikiyplayerpig Автор
1) Насколько мне известно, датасет на котором учился DeepSeek R1 distill не выкладывали.
2) GSPO. Этот алгоритм придумала команда Qwen (Alibaba), у DeepSeek был GRPO. Репозиторий по ссылке применяет GSPO к их дистиллированной модели. На последнем этапе 2.2 Pro я использовал GRPO (своя реализация на PyTorch). GSPO исправляет то, как модель учится на ответах, сгенерированных её более старой версией. Это важно на больших моделях и MoE, иначе обучение может разойтись. У меня после каждой генерации делается ровно один шаг обучения, такой поправки нет, и GSPO почти совпал бы с тем, что уже есть.
3) Потому что нельзя дать ей "встроенный калькулятор". Чтобы работал калькулятор, нужно чтобы модель вызвала тул, и внешняя программа посчитала ответ за нее. Модель должна уметь считать самостоятельно, и без запуска с внешними инструментами. Хотя если инструменты есть, то она может их вызывать, но конкретно сейчас это работает плохо, в будущем постараюсь сделать лучше.
Насчет статьи, где сказано что рассуждения на русском языке более эффективны - вы можете дать ссылку на статью или рассказать более подробно? По информации которую я нашел, рассуждения на русском могут выходить короче, приходя к тому же результату, хотя это еще зависит от токенизатора.
Насчёт MoE-модели на 4090: делать её только русскоязычной вряд ли хорошая идея, на английском данные качественнее. Оптимально, думаю, русский + английский, так будет полезнее. Можно попробовать 1B общих и 200-300M активных, но на 4090 это примерно 35-45 тысяч ток/с (предположительно), и даже 20B токенов — это около недели чистой работы GPU, без учёта возможных проблем. И что это будет лучшая модель в мире, тоже не факт: нужно больше токенов. GSPO для MoE полезен, но в моей схеме обучения он почти не отличается от GRPO, который я уже делал. И MoE я пока что не обучал, какие проблемы есть у них не знаю.