

Недавно мне довелось дважды выступить с докладом об агентном искусственном интеллекте: сначала на междисциплинарном научном семинаре СМУ РАН «Выбор в науке», а затем в рамках «Научного кафе» Тульского государственного университета.
Несмотря на разную аудиторию, оба выступления показали, что интерес к агентным системам сегодня выходит далеко за пределы узкого круга специалистов по машинному обучению. На семинаре СМУ РАН мы обсуждали архитектуру автономных агентов, способы их координации, применение в научных исследованиях и вопросы доверия к результатам. В ТулГУ разговор продолжился уже со студентами технических и ИТ-направлений, интересных вопросов тут было много.
По итогам этих встреч решил собрать основные тезисы выступлений в статью. Попробуем разобраться, что сегодня называют агентным искусственным интеллектом, как устроены такие системы, чем они отличаются от привычных языковых моделей и какие задачи они могут решать.
Откуда берется "правдоподобный" текст
Пять лет назад "поговорить с нейросетью" означало написать запрос и получить правдоподобный ответ. Сегодня система сама ищет источники, запускает код, сверяет результат и продолжает работу, пока не достигнет цели. Это уже не чат-бот, а агент. Разберем, почему этот переход неизбежен, как он устроен внутри и что он меняет для науки и практики.
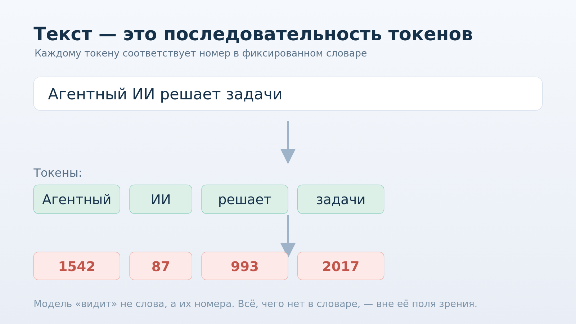
Любая современная модель работает не с буквами и словами, а с токенами — короткими последовательностями символов, которым присвоен номер в фиксированном словаре. Текст для модели — это просто список чисел. Отсюда первое ограничение: все, чего нет в словаре, модель не обрабатывает. Решают это токенизаторы вроде BPE и Unigram, покрывающие почти любые тексты, включая код и редкие языки.
Формально языковая модель — это функция, которая по началу фразы предсказывает для каждого токена словаря вероятность оказаться следующим в этой последовательности:
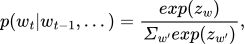
где  — "оценка" токена
 , вычисленная моделью. Звучит как автодополнение в смартфоне — но с на порядок более богатым контекстом. И это ключевой момент: модель генерирует правдоподобное продолжение, а не проверенное знание. Именно здесь корень галлюцинаций — ошибок, при которых ответ не соответствует действительности или запросу. Это системное свойство вероятностного моделирования, а не "баг" отдельного сервиса.
Как рождается следующий токен
Вероятность токена это хорошо, но как имея вероятность получить этот следующий токен? Взять наиболее вероятный? Не все так просто! Ниже приведен пример Ннаиболее популярных методов выбора следующего токена:
Жадный выбор. На каждом шаге берется токен с максимальной вероятностью. Результат детерминирован, но часто слишком предсказуем.
Beam search. Держится несколько вариантов продолжения, лучший выбирается по заданному критерию. Качество выше, но вычисления дороже.
Сэмплирование. Токен выбирается случайно с вероятностями модели. Дает вариативность, но допускает маловероятные продолжения. Именно сэмплирование — основа современных сервисов.
Отсечение. Отбрасывание маловероятных токенов (top-p, top-k) повышает качество при сохранении вариативности.
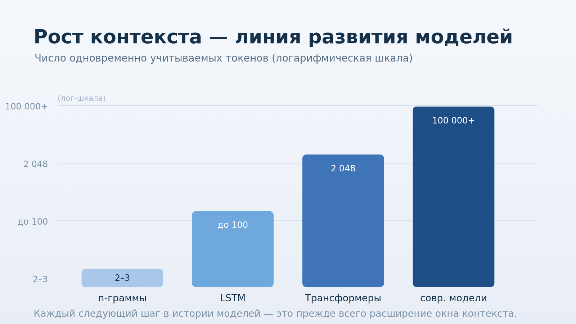
Одной из ключевых точек роста современных моделей это увеличение контекста. Т9 в телефоне прекрасно дополнял слова используя контекст 2-3 символа, но этого мало для настоящей генерации. Контекст, в свою очередь, это число одновременно учитываемых токенов. Рост размера контекста стал одной из ключевых линий развития современных моделей (рис.2): у n-грамм это единицы, у LSTM — до сотни, у первых трансформеров — до 2048, а у современных больших языковых моделей — сотни тысяч и больше. Причем некоторые современные модели могут обрабатывать контекст вплоть до 2млн. токенов (это можно поместить в контекст 3 раза по 4 тома "Войны и мир"!).
Краткая история: от Маркова до трансформеров
Путь к современным моделям это история того, как рос этот контекст и как модели научились избирательно его учитывать.
N-граммы (1913–1948). Цепь Маркова и n-граммная модель Шеннона считали частоты совместной встречаемости последовательностей в корпусе. Простые и прозрачные, но без обобщения: новую последовательность, не встречавшуюся в данных, они не генерировали.
Рекуррентные сети и LSTM (1997–2014). RNN учитывали всю поданную последовательность, но "память" была короткой. LSTM научилась хранить информацию о дальних токенах, вместе с этим контекст вырос до десятков токенов. Однако слова учитывались одинаково, порядок слов учитывался лишь частично.
Внимание и Transformer (2014–2017). Механизм внимания, который кратко можно описать простой формулой
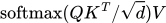 , где
 — запросы, ключи и значения дал возможность "выбирать" наиболее важные токены из всего контекста для генерации следующего токена. Это свойства локальности, позволило архитектуре трансформера стать базовой для всех современных моделей.
Масштабирование (2018–2020). GPT (117 млн), GPT-2 (1,5 млрд), GPT-3 (175 млрд параметров) показали: качество растет вместе с числом параметров и объемом данных. GPT-3 впервые уверенно генерировала код и решала новые задачи по примерам. Но появился и предел масштабирования, так как с одной стороны начались проблемы с данными, а с другой с ресурсами. Начали проявляется эффекты, что не всегда больше параметров это хорошо, появились первые работы по законам масштабирования больших языковых моделей.
Качество определяется не только размером
После GPT-3 стало ясно: "просто больше данных" уже не работает. Решающий сдвиг произошел, когда стадию предобучения (предсказание следующего токена на сыром тексте без разметки) дополнили дообучением на инструкциях — сначала на примерах желаемых ответов, потом на обратной связи пользователей (RLHF, 2022). Небольшой объем качественных данных дал огромный прирост: модель научилась следовать указаниям. С 2023 года подготовка и валидация данных признаны одним из важнейших факторов развития моделей.
Мультимодальность и открытые модели
Фактически, в 2023 году языковые модели перестали быть чисто текстовыми. GPT-4 стал работать не только с текстом, но и с изображениями и объектами документов, а контекстное окно выросло с 32 до 128 тысяч токенов в Turbo-версии. Практический вывод: современная модель — это продукт, где больше, чем собственно языковая модель. В него входят постобработка, фильтры и инструменты.
Обратная сторона первого такого продукта от OpenAI — закрытость. Конкретные архитектурные решения GPT-4 уже не раскрывались, что ограничивало независимую верификацию его свойств. И именно здесь в игру вступают открытые модели: семейства LLaMA, Alpaca, LLaMA 2 и Mistral которые стали первыми доступными для исследований и дообучения, их размеры были от 7 до 70 млрд параметров. Открытость позволяет воспроизводить эксперименты, изучать свойства и готовить адаптивные версии моделей.
MoE и спекулятивное декодирование. История моделей на этом не закончилась — после активного развития мультимодальности появились еще две вехи, напрямую повлиявшие на скорость генерации. Ключевой 2025 год связан с архитектурой Mixture of Experts (MoE): модели DeepSeek показали, как разреженная архитектура, когда при обработке задействуется лишь часть экспертных блоков, позволяет эффективнее расходовать вычислительные ресурсы и ускорять работу модели.
Следующий шаг пришелся на 2026 год — широкое распространение спекулятивного декодирования (Speculative Decoding). Здесь модель готовит и проверяет несколько токенов параллельно, что дополнительно ускоряет генерацию. Оба примера показывают, как быстро развивается область и насколько архитектурные решения определяют практические возможности систем ИИ — и именно они делают агентов, о которых пойдет речь дальше, не просто правдоподобными, а по-настоящему применимыми.
Где галюцинации там и детекторы
Как только машинная генерация обрела массовость в ноябре 2022го года, так сразу появилась задача эффективной детекции сгенерированных текстов. Отдельно хочу отметить, что у нашей команды первые наработки по детекции машинной генерации были еще в далеком 2018м году. Причем, первый качественный детектор мы получили летом 2022го года, за несколько месяцев до релиза ChatGPT и массовости машинной генерации! В целом наша команда продолжает заниматься этим в рамках системы обнаружения заимствований и детекции ИИ Думейт.
Методы детекции ИИ используются самые разные, от классических методов анализа стилистических особенностей текста на основе перплексии, до транспортерных моделей классификации (пишите в комментариях если хотите отдельный рассказ о том, как работают современные методы детекции машинной генерации, какие у этих систем есть плюсы и недостатки и как с этим жить). Развитие агентного подхода позволяет развивать продукты и с точки зрения пользовательского пути. В Думейт это помогло перейти от проверки к интерпретации результатов. Эту задачу решает ИИ-помощник в отчете: он анализирует документ, помогает разобраться в обнаруженных заимствованиях и признаках ИИ-генерации, выделяет слабые места и предлагает варианты доработки.
От чат-бота к агенту
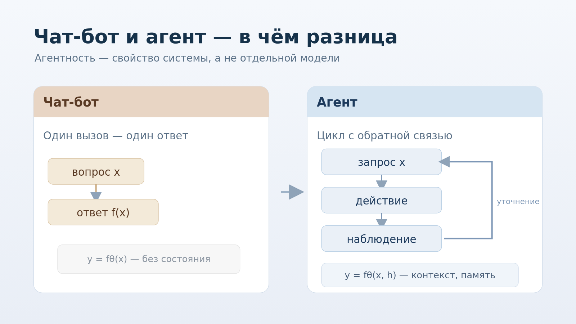
Чат-бот отвечает один раз:  . Агент действует иначе:
 , где
 — состояние, включающее контекст, память и наблюдения (рис.3). Агент может уточнить запрос, выполнить действие, прочитать результат и продолжить. Поэтому агентность — свойство системы, а не отдельной модели.
Рабочее определение: агент — это система, где языковая модель выступает центром принятия решений и итеративно анализирует задачу, выбирает действие, получает результат и оценивает достижение цели. Формально:
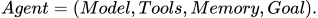
Цикл прост: рассуждение — действие — наблюдение — уточнение (шаблон ReAct). Критерий успеха — достигнут ли результат задачи, а не "похоже ли на текст".
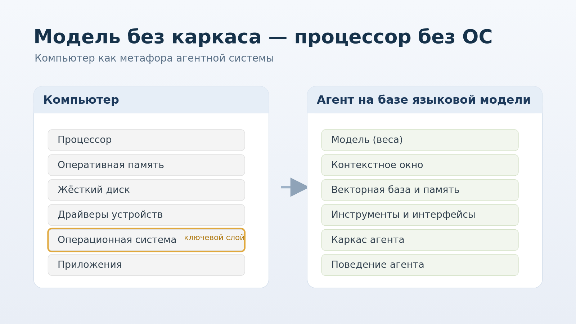
Удобной аналогией является компьютер (рис.4): большая языковая модель — процессор, контекстное окно — оперативная память, внешняя память — диск, инструменты — драйверы, каркас агента — операционная система, а поведение — приложения. Модель без каркаса — процессор без ОС: мощность есть, пользы нет.
Что дают агенту инструменты, память и автономия
Возможности агента определяются инструментами и средой: поиск и базы знаний, выполнение кода, работа с документами, вызовы API, браузер и виртуальные окружения. Чем шире среда, тем выше требования к контролю.
Память делится на краткосрочную (текущий диалог, ограничен окном модели) и долгосрочную (векторные базы, RAG-извлечение по релевантности, файлы, выводы прошлых сессий). Память превращает агента из одноразового генератора в систему, способную накапливать и переиспользовать результаты.
Уровни автономии растут от чата и агента-исполнителя до автономного агента и мультиагентной системы. Выбор уровня является инженерным решением, зависящий от рисков и стоимости ошибки. Оптимальная архитектура это не всегда максимальная автономия, а управляемая автономия с контролем на критических шагах.
Как сравнивают языковые модели
Понять, кто «сильнее», сложнее, чем кажется. Метрики делятся на несколько типов.
Перплексия. Мера точности предсказания следующего токена на тестовом корпусе. Проста в расчете, но не отвечает на вопрос, полезен ли ответ. Обычно используется при обучении и редко при сравнении конкретных моделей.
Бенчмарки. Наборы заданий с известными ответами. Модели сравнивают по доле правильных решений тех либо иных задач. Вот один из примеров таких лидербордов.
Насыщение. Задания бенчмарков со временем попадают в обучающие корпуса, и рост результатов перестает отражать реальный прогресс.
Человеческая оценка. Сравнение ответов людьми с учетом инструкций. Дороже и менее воспроизводимо, но ближе к практике.
Оценка качества моделей на самом деле это одна из самостоятельных исследовательских задача. Метрики часто не полностью отражают полезность и надежность, а «сильнейшая» модель по одному бенчмарку не обязана быть лучшей в реальной работе.
Мультиагентные системы и координация
Разделение ролей (исследователь, исполнитель, планировщик, критик, интегратор) позволяет специализировать агентов и реализовать внутренний контроль качества на уровне системы. Координация также является отдельной инженерной задачей: оркестрация, общая память, "доска" результатов, взаимная критика и голосование. Появляются стандарты — протокол доступа к инструментам (MCP) и взаимодействия агентов (A2A).
Параллелизм дает эффект: вероятность найти решение растет с числом независимых попыток, то есть даже при 10% успеха на попытку 100 агентов почти гарантируют результат. В сентябре 2026 года OpenAI заявила о решении задачи Навье-Стокса, где параллельно работали около 10 000 агентов. Независимого подтверждения пока нет, математическое сообщество ответило петицией и мне кажется что это важно: масштаб не заменяет верификацию научного сообщества!
Наука на практике
Агенты уже работают в исследовательской практике. По опросу 46 исследователей, Deep Research — основной инструмент обзоров литературы у 67% участников, а полностью автономных агентов не использует никто. Есть и амбициозные системы: AI Scientist (полный цикл "идея — код — эксперимент — отчет — ревью", по данным разработчиков около 15 долларов за статью), самодвижущиеся лаборатории с байесовской оптимизацией и обучением с подкреплением, платформа "научный синапс" на национальной сети суперкомпьютеров. Заявленные результаты требуют академической верификации.
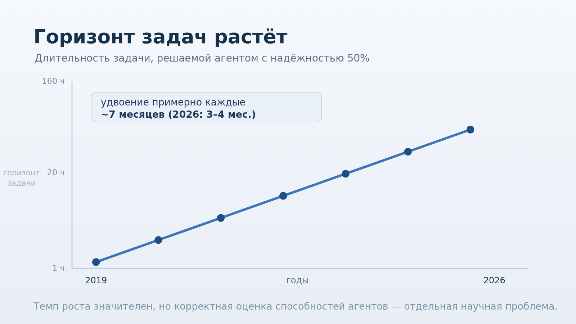
Горизонт задачи (длительность, которую агент решает с надежностью 50%) удваивался каждые 7 месяцев с 2019года, а по оценкам 2026 года начала удваиваться каждые 3–4 месяца (рис.5). OpenAI оценивает 50% успешности на задачах до 20 часов и 25% до 40. Дальше простая математика, если при 95% успеха на один шаг требуется выполнить 100 шагов, то итоговая вероятность будет составлять лишь ~0.6%, так как в целом ошибки накапливаются.
Последнее время, я и наша команда активно разрабатываем отечественный аналоги агентных систем. В частности одним из таких результатов является агентное приложение Дуэйд (doaid) для решения широкого круга инженерных, исследовательских, аналитических задач. Исполнение может быть полностью отдано агенту, человек остается в контуре, но его роль смещается, он фактически выступает инициатором и архитектором задачи.
Саморефлексия и человек в контуре
Одиночный агент может и должен проверять сам себя. Саморефлексия — это когда агент оценивает собственный промежуточный результат и формирует уточненный план: 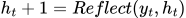 . Практически это запуск тестов, сверка с источниками и верификация формальных свойств. При неудаче это возврат к предыдущим шагам и смена стратегии. Но у саморефлексии есть предел: в длинных цепочках ошибки накапливаются, а уверенность в собственном результате может быть ложной. Поэтому саморефлексия не заменяет внешнюю верификацию.
В этой точке ключевым становится человек. Его роль смещается от исполнителя к постановщику задачи: он определяет цель, критерии успеха и допустимые действия, подтверждает критические шаги и ограничивает права агента. Прозрачность — журналы решений и объяснения — основа аудита и доверия. Самое важное: за результат отвечает человек, и эту ответственность нельзя переложить на агента.
Условия массового применения
Массовое применение агентов определит не скорость генерации, а надежность и доверенность систем. Ключевые условия:
Надежность. Воспроизводимость результатов, устойчивость к смене контекста, ясные границы применимости.
Верификация и аудит. Проверка выходов тестами, формальные свойства, независимые источники и журналы решений.
Доверенность. Права и доступ, безопасность среды выполнения, устойчивость к инъекциям.
Экономика и право. Стоимость вычислений и коммуникаций, ответственность, декларирование использования ИИ, стандарты практики.
Кадры. Постановка задач агентам, интерпретация и верификация результатов.
Метрики и верификация результатов
Чтобы прогресс был измеримым, нужны формальные модели агентных систем, метрики способностей и надежности с учетом длины задачи. Важны воспроизводимость и доказательность — пакеты из данных, моделей, метрик, а также версионирование и независимое воспроизведение. Отдельная роль у отраслевых бенчмарков с едиными процедурами сравнения. Прогресс агентного ИИ определяется не только моделями, но и развитием метрик, верификации и воспроизводимости.
Перспективы
Следующий этап — не замена человека, а существенное расширение его пропускной способности. К примеру, если взять научного исследователя, то адаптация исследовательского процесса состоит из построения мультимодальных агентов, построения встроенных агентов в физические среды, обучение на собственном опыте и тому подобное. В свою очередь, OpenAI называет создание автоматизированного ИИ-исследователя к марту 2028 года одним из ключевых стратегических ориентиров своего развития.
Важная оговорка: скорость не равна достоверности. Массовое применение агентов определят не скорость генерации, а надежность, верифицируемость и доверенность систем. Экспертиза и проверка остаются за человеком — и это, пожалуй, главный вывод.