

Что меня подвигло к этой теме
Этим летом я наконец‑то решила освоить ИИ‑чат‑боты, и причина этого была вполне серьезной. Дело в том, что я уже полгода не могу найти себе работу в качестве райтера академических текстов, что раньше не вызывало проблем, достаточно было обратиться на сайты по поиску работы. К настоящему времени благодаря активному освоению человеком чат‑ботов с генеративным ИИ работа «писателя текстов» уже почти полностью замещена ИИ, и, что уж совсем огорчительно, кардинально обесценена.
Познакомившись с Дипсиком, Гигачатом и Клодом, я быстро стала горячей поклонницей ИИ чат‑ботов, лично убедившись в их мощных функционалах аналитика, математика, писателя и переводчика. Вместе с тем, как автор множества научных и аналитических текстов, могу с уверенностью утверждать, что использование генеративного интеллекта в сферах деятельности, подразумевающих защиту авторских прав, создает серьезную проблему. К этим сферам относятся в первую очередь наука, образование, искусство, дизайн, архитектура и др.
Вузовское образование одним из первых столкнулось с проблемой активного применения студентами ИИ при написании собственных текстов, подлежащих аттестации (диплом) или оценке (курсовые, отчеты по практике и пр.). Проблема быстро усугубляется — по данным системы Антиплагиат если в 2023 г. признаки ИИ‑текста обнаруживались у 5,3% студенческих работ, то в 2026 г. эта доля составила уже 36%. Возможные методы контроля активно обсуждаются в вузовском сообществе, на практике в настоящее время многими вузами реализован входной контроль за долей ИИ‑текста в студенческих работах, определяемой ИИ‑детекторами. Этот метод, однако, предполагает достаточно надежную работу детекторов, относительно чего у практиков консенсуса еще нет. Споры по поводу повышения точности оценок детекторов продолжаются, в то время как на рынке уже появилось множество «гуманизаторов» для очеловечивания сгенерированных текстов, что еще осложняет проблему.
Я решила внести «свой посильный» вклад в тему, протестировав три популярных «вузовских» ИИ‑детектора и разобравшись в том, какие реальные выводы можно сделать на основе их оценок. В качестве этих трех испытуемых выбрала два детектора российской разработки Антиплагиат (antiplagiat.ru) и Думейт (domate.ru) и один западный сервис — GPTZero (gptzero.me). Антиплагиат указывает на своем сайте, что «85% (российских) студентов учатся в ВУЗах, использующих систему „Антиплагиат“, а Думейт только в 2026 году отработал первую сессию, но на него уже подписаны МГИМО и Синергия. GPTZeroочень популярен в западных вузах, по утверждениям владельцев этот детектор используется в более чем 3500 колледжах, и, в отличие от лидера международного рынка сервиса Turnitin, доступен для частных пользователей. »
Теперь о самом исследовании и его результатах.
Цель и объекты:
Первый этап исследования был нацелен на проверку двух базовых функциональных возможностей этих сервисов: 1) повторяемость оценок: являются ли параметры текстов, выдаваемые детекторами, достаточно устойчивыми и повторяемыми, чтобы им доверять, и 2) соответствие результатов реальному авторству: соответствуют ли выводы детектора известному (в данном случае, мне) происхождению текста, и насколько точно. Период тестирования составлял 2 месяца — с конца августа по конец октября 2026 г. Второй этап будет посвящен исследованию возможностей ИИ чат‑ботов для генерации, редактирования, «гуманизации» и перевода академических текстов и одновременно изучению нюансов взаимодействия человека с машиной [ результаты опубликую в ноябре‑декабре].
Надеюсь, что результаты позволят предложить более эффективную и простую технологию вузовского контроля за студенческими работами.
В качестве проверяемых тестов я использовала три группы русскоязычных академических текстов [поведение детекторов на переводных и англоязычных текстах — предмет отдельной проверки, о которой расскажу позднее], имеющихся в моем личном распоряжении или в открытом доступе, отличающихся по назначению, времени написания, научным направлениям и авторству. Происхождение текстов было следующим:
Группа А — тексты, заведомо написанные человеком: сюда входили мои личные тексты из написанных до 2022 г. материалов к заявкам на гранты, а также несколько дипломных работ из открытого доступа репозиториев разных вузов, также написанные до 2022 г. (ТГУ, УрФУ, ТюмГУ);
Группа В — тексты, являющиеся «близнецами» моих текстов из группы А, сгенерированными с помощью Гигачата Сбербанка. В промте (ТЗ) я указывала назначение текста, цель работы, ожидаемый результат, ключевые слова и объем, полностью соответствующие моим оригинальным фрагментам;
Группа С — тексты с заранее неизвестным происхождением — несколько студенческих работ, размещенных авторами в открытом доступе в августе 2026 г. [цель размещения авторами текстов заключалась в поиске исполнителя, способного сократить доли ИИ‑текста, обнаруженные в этих работах вузовскими ИИ‑детекторами], а также несколько академических текстов, выложенных в открытый доступ одной консалтинговой компанией в качестве примеров аннотаций ВКР, которые специалисты компании могут написать по заявкам студентов. На сайте утверждалось, что при написании работ ИИ не используется.
Для иллюстрации представляю сводные таблицы результатов тестирования и мои личные «впечатления» по каждому детектору:
Результаты для краткости представлены в сокращенном виде (по 1–2 текстам из каждой группы). Разными детекторами проверялись одни и те же тексты. Мои комментарии читайте в последнем столбце.
Антиплагиат
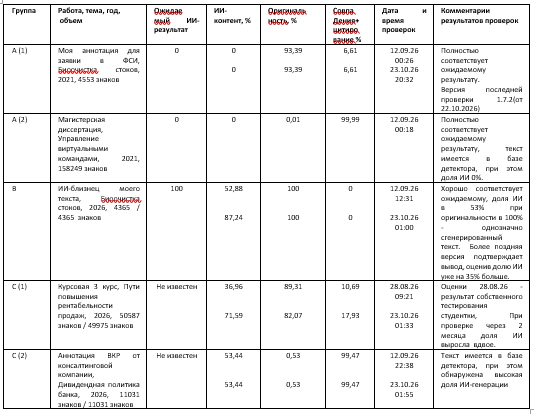
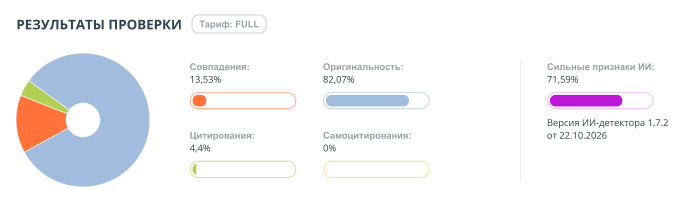
В отчете Антиплагиата (АП) предлагается оценка трех параметров текста, составляющих в сумме 100% и характеризующих его оригинальность (оригинальность, совпадения и цитирование), а также суммарной доли фрагментов с ИИ‑текстом. При этом АП исключает из проверяемого объема таблицы и библиографию. Фрагменты, написанные с применением ИИ, помечены цветом. Эта информация позволяет лучше понимать масштаб проблемы: какие именно разделы работы написаны с помощью ИИ‑ введение или обзор, где применение ИИ может быть оправдано, или основная часть, которая должна содержать исключительно результаты личной работы студента. Высокая стоимость частных проверок АП не позволяет тестировать большое количество текстов (как в случае этой работы) — минимальная стоимость за 1 проверку текста объемом не более 50 тыс. знаков составляет в настоящее время 483 ₽ и кратно растет с ростом проверяемого объема.
Версии модели Антиплагиата, применяемые летом и в начале осени этого года, явно «работали» в пользу студента: даже для полностью сгенерированного текста группы В оценка доли ИИ‑текста составляла всего 53%. Для «смешанных» текстов группы С этот параметр был занижен по сравнению с оценками Думейта на 20–25%. В это время сервис не указывал номер актуальной версии своей модели и дату ее принятия. Вместе с тем, с октября наблюдается существенное повышение чувствительности АП к сгенерированному тексту, при этом в отчетах отмечается номер и дата версии. Увеличение оценки доли ИИ в исследуемых здесь текстах составило в октябре по сравнению с сентябрем до 30–35%. Таким образом, тексты, которые могли быть приняты к аттестации в ходе защит 2026 г., в 2027 г. уже явно не прошли бы барьер АП.
Думейт
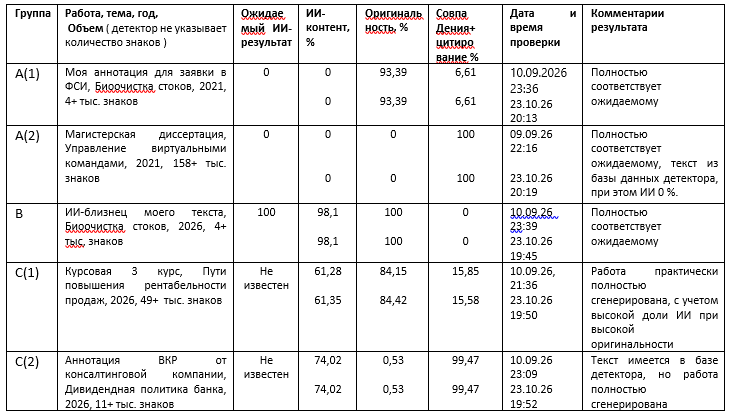
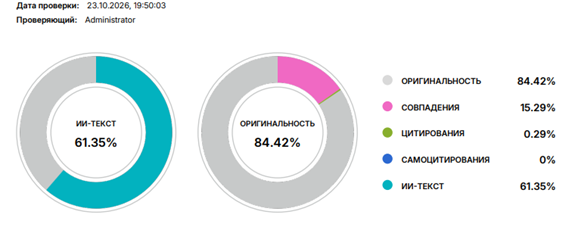
Сервис Думейт (ДМ) оценивает те же параметры, что и АП, так же помечает страницы, написанные с помощью ИИ. Однако, его модель значительно чувствительнее к признакам ИИ‑генерации, а оценки доли ИИ‑текста оказались наиболее близкими к ожидаемым результатам. Отмечу также, что этот детектор не «работает» на студента, не ограничивая свои оценки ИИ‑присутствия сверху, что подтверждается долей в 98%+ ИИ‑текста для сгенерированного близнеца моего текста из группы В. Сервис не указывает актуальную версию своей модели, хотя она также регулярно обновляется. При этом, если отличия результатов в июле и августе этого года составляли до 43% [этот факт подтвердился в ходе исследования на одном из текстов группы C с помощью Думейта: в конце июля 2026 г. университетская проверка показала долю ИИ‑текста 32,34%, а в конце августа 2026 г. в ходе моей проверки того же текста детектор оценил эту долю уже в 76,15%. Я обратилась к разработчикам сервиса с вопросом, не обновлялась ли модель в августе, и получила ответ о загрузке новой версии детектора 16–17 августа], то за последние 2 месяца оценки расчетных параметров практически не изменились, что свидетельствует о достигнутой зрелости модели. Более демократичный подход к оплате (до 3 проверок в день бесплатно даже для больших текстов, полный отчет от 249 ₽ за проверку) делает Думейт наиболее доступным при высокой надежности.
GPTZero
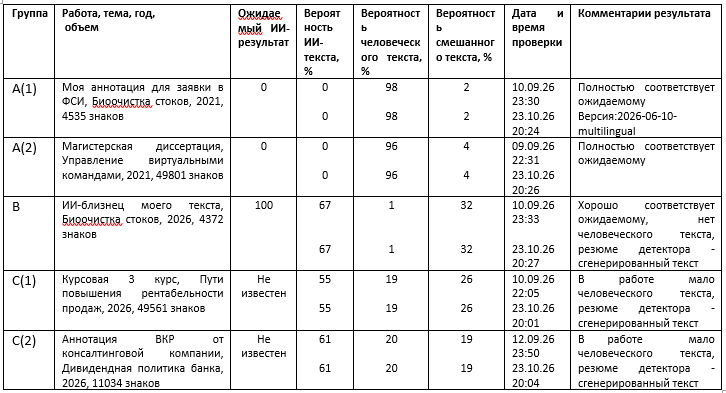
Детектор GPTZero (GZ) проверяет только первые 50 тысяч знаков текста, что заставляет в случае больших текстов проверять их по частям. По результатам моего тестирования GZ кажется наиболее адекватным ИИ‑ детектором из трех названных для определения студенческого авторства. Во‑первых, судя по абсолютной повторяемости его результатов при проведении повторных проверок на текстах из разных групп в течение двух последних месяцев, применяемая модель является полностью зрелой и скорее всего уже не обновляется существенно. Во‑вторых, в отличие от АП и ДМ, GZ оценивает не долю фрагментов текста с признаками ИИ, а так называемый «вероятность того, что работа написана в основном c применением ИИ». Формулы для оценки этого параметра авторы сервиса не сообщают, однако, она очевидно привязана к доле ИИ‑текста, о чем свидетельствуют близкие оценки «вероятности» и «доли» для детекторов ДМ и GZ на всех проверенных мною русскоязычных текстах. При этом, помимо вероятности ИИ‑генерации, детектор оценивает также вероятность написания текста «В ОСНОВНОМ ЧЕЛОВЕКОМ» и вероятность смешанного текста, относительно которого он не смог сделать выбор между человеком и машиной. При этом сумма всех трех этих вероятностей равна 100%. Выделение текста, написанного человеком, является важным параметром, который, как я покажу позже, оценивается детектором более надежно, чем вероятность ИИ‑генерации.
Следует отметить, что GZ очень осторожен, и также, как и АП, старается «не обидеть человека». Если для оценки вероятности того, что текст написан человеком, этот сервис не скупится на 98%, то вероятность написания ИИ даже для полностью сгенерированного текста он может ограничивать величиной в 60–70%, оставляя до 30–35% на смешанный текст и единицы% — на человеческий.
На основании представленных и непредставленных мною результатов, и, несмотря на статистически недостаточную выборку, я все же рискну сделать несколько выводов:
1. Повторяемость результатов. Проверки проводились на нескольких текстах из каждой группы (не менее, чем 5–10 работ в группе) несколько раз с интервалами до нескольких недель. Сервис GPTZero продемонстрировал полную повторяемость результатов. Два российских ИИ‑детектора показали надежную повторяемость результатов при использовании одной и той же версии детектора. В этом случае отличия в оценочных параметрах для АП и ДМ составляли не более единиц процентов, тогда как при применении разных версий детектора могли быть существенными — до 43%, что подтвердилось для АП и ДМ в ходе моих тестирований. В 2026 году оба детектора — АП и ДМ, активно работали над совершенствованием своих моделей и регулярно обновляли версии, которые становились все более чувствительны к ИИ‑контенту. Этот факт и объясняет причину недовольства пользователей большим разбросом ИИ‑оценок, получаемых при повторных проверках в разные моменты времени. Однако, наблюдаемое в последнее время заметное сближение оценочных параметров даже для разных версий одного детектора (АП или ДМ) свидетельствует о приближении расчетных моделей к оптимальным версиям.
2. Соответствие реальному результату. Хорошее соответствие сделанных на основании проверок качественных выводов относительно авторства текста, показали все три детектора, хотя различия в количественных оценках ИИ‑присутствия в текстах у АП, ДМ и GZ безусловно заметные, и составляют до нескольких десятков процентов. Существует множество факторов, объясняющих эти различия: это разные модели оценки ИИ‑присутствия, разные базы данных, разные ограничения для проверяемых объемов. Невозможность добиться полного соответствия оценок ИИ‑присутствия, сделанных разными детекторами, очевидна, что приводит к необходимости устанавливать разные границы допустимого вузами уровня применения ИИ для разных детекторов. Субъективность таких границ также очевидна: постоянное обновление версий российских детекторов в 2026 г. приводило к тому, что оценка доли ИИ‑текста могла существенно меняться в течение одного‑двух месяцев, меняя при этом статус текста на противоположный — с допущенного к защите на возвращенный для переработки.
Рискну сделать вывод, что контроль за авторством студенческих работ по доле ИИ‑текста является некорректным, поскольку возможны объективные ошибки в выводах, а доли в 30%, 50% и 70%, показываемые разными детекторами, одинаково свидетельствуют о том, что текст написан с существенным применением ИИ.
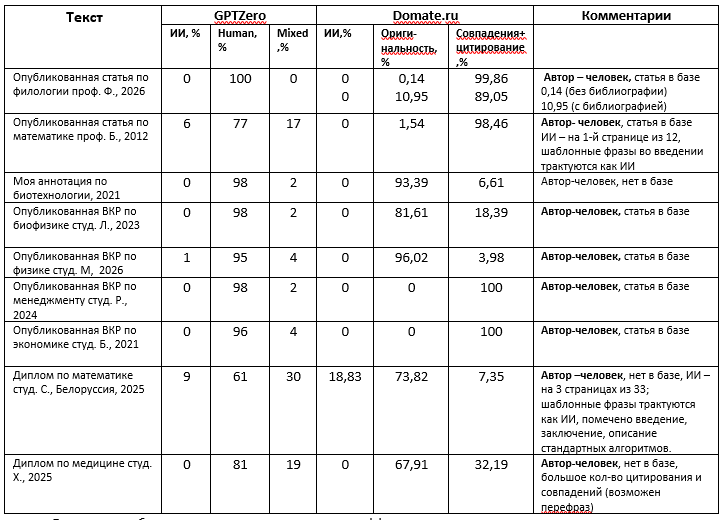
Предлагаю другой подход к определению авторства: нужно искать не ИИ‑текст, а текст, написанный человеком, и оценивать именно его. А вот эту вероятность все протестированные мною детекторы определяют с высокой точностью, различия составляет единицы процентов на текстах любого происхождения. Множество (несколько десятков) проверенных академических текстов по разным тематикам, заведомо написанных человеком, описываются всеми тремя детекторами одновременным сочетанием следующих величин двух параметров: вероятность (GZ) или доля ИИ‑текста (АП, ДМ) оцениваются малой величиной (менее 10%), а вероятность написания текста человеком (GZ) или оригинальность (АП, ДМ) — большой величиной (более 70%) [за исключением случая, когда текст уже опубликован и есть в базе, и оригинальность определена как 0%. В этом случае советую применять GPTZero, который прямо оценивает вероятность написания текста человеком вне зависимости от наличия текста в его базе]. В этом случае оригинальность проверяемого текста обусловлена истинным авторством студента, а не новизной сгенерированного текста для базы детектора. Малая доля параметра, характеризующего присутствие ИИ, в этом случае может являться допустимой ошибкой детектора, связанной с использованием шаблонных фраз при написании формализованных разделов текста, которые детектор мог отнести к ИИ‑генерации. Этот факт, кстати, легко проверить по помеченному тексту в отчете детектора. В случаях более высокой доли ИИ‑присутствия высокая оригинальность складывается уже из двух составляющих: авторского текста студента плюс сгенерированные ИИ разделы. В этом случае для корректной оценки авторства работы достаточно посмотреть в отчете детектора, какие ее разделы помечены как ИИ‑текст.
В качестве иллюстрации предлагаю таблицу, в которой представлены несколько результатов тестирования человеческих текстов с помощью ДМ и GZ, тестирование выполнялось в октябре 2026 г. с помощью последних версий детекторов:
Еще одно соображение, позволяющее повысить эффективность контроля авторства: проверять имеет смысл не весь текст, а только основную его часть, содержащую личные результаты работы студента. Мои предложения по составу основной части: из текста работы при проверке нужно исключать следующие разделы:
1. Библиография, поскольку не содержит авторского текста.
2. Обзор литературы/рынка/технологий, поскольку может быть написан с применением ИИ, это оправдано и может быть честно продекларировано. Использование чат‑бота для подготовки этих разделов позволяет студенту найти в открытом доступе максимально полный и актуальный объем информации, сделать на его основе корректный вводный текст, а также правильно выбрать собственный подход к решению поставленной задачи. Фактически в этом случае ИИ чат‑бот работает помощником научного руководителя.
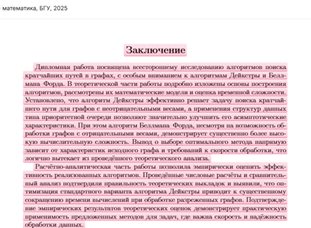
3. Формализованные части работы ‑аннотация, введение и заключение, поскольку в них обязательно используются шаблонные фразы, которые детекторы зачастую оценивают как ИИ‑текст. Для иллюстрации представляю выдержку из отчета Думейта по Диплому по математике Студ.С., Белоруссия, 2025 г., на которой показано заключение, полностью помеченное как ИИ‑текст.
Основная же часть работы ‑защищаемые положения, применяемые методы, описание результатов и выводы — не должны писаться с применением ИИ, и здесь недопустимы ни генерация, ни редактирование. Если студенты будут заранее предупреждены об этом, как и об используемой для основной части работы низкой границе для ИИ‑текста, количество работ, написанных человеком, кратно возрастет. Мое предложение для величины этой границы ИИ, основанное на тестировании контрольной группы, составляет 10%.
Результаты и выводы второго этапа исследования опубликую позже, и они не менее интересны.
Комментарии (14)

alexero
29.10.2026 11:49Недавно жена писала магистерскую диссертацию (ТГУ). Прохождение «антиплагиата» было обязательным условием. Не знаю тот ли это антиплагиат, про который упоминается в статье, но меня больше всего поразило что он считает плагиатом фразы типа: «Как было указано в пункте 3.1» и даже некоторые отдельные слова, кажется, это было слово «следовательно».
Это вообще как?

Graphist
29.10.2026 11:49У моей жены та же фигня(. На "заключении" (которое пишется в форме "рассмотрено..., рассмотрено..., показано, что..., показано, что..., предложено... предложено...") антиплагиат стабильно выдаёт "100% ИИ".
А попробуй это "заключение" перепиши без этих повторов: получится ж "не по форме" (и всё равно не примут).
А самое поганое -- это обновления детектора, после которых он начинает детектить по-другому. Жена у меня возится с диссером уже несколько лет, и только переработает все 400 страниц чтоб избавиться от плашки "ИИ", как выкатывают новую версию "антиплагиата" -- и он снова выдаёт своё "bite my shiny metal ass". И просит деньги за повторные проверки.
ickate Автор
29.10.2026 11:49Вы правы- актуальные версии российских ИИ-детекторов могут определять ИИ-присутствие с высокой точностью. Попробуйте проверить текст, убрав из него формализованные разделы и библиографию. Если величина ИИ-текста все же будет выше 10-15% - текст однозначно писался с применением ИИ (эту долю я оставляю на шаблонные фразы внутри основной части), и придется переписывать все помеченные фразы, увы:((((
ickate Автор
29.10.2026 11:49Привет, Вы правы, АП действительно ищет заимствованные слова из своей базы, поэтому такие фразы, как Вы превели, он трактует, как заимствование. Поэтому я и написала в конце своей статьи, что корректнее проверять основную часть работу без выводов, заключения и других формализованных разделов. Это уже было мое обращение к вузам с тем, чтобы они поправили методику своей проверки :))))
ickate Автор
29.10.2026 11:49Согласна, АП обязательно будет трактовать все формальные фразы как заимствование, поэтому я и написала в конце своей статьи, что нужно менять методику проверки работы, убирая из текста все формализованные разделы и библиографию. Но это уже прерогатива вузов :))))
Kamil_GR
К сожалению, Гигачат пишет более шаблонные тексты, чем текущая модель того же Claude. Специально я не тестировал, но как минимум три текста Claude прошли основные российские ии-детекторы вообще без какой-либо обработки.
Соответственно, студентов просто выдавят на более качественные модели.
Кроме того, работа дипломных руководителей в этом отношении ограничивается тем, что студенту тыкается пальцем в участки текста, помеченные ии-детектором. После чего студент разбивает и упрощает длинные предложения, заменяет термины на более простые выражения. Удаляет лишние причастные обороты.
Сама по себе такая работа абсолютно не ведёт к пониманию студентом собственной работы, с ней справляется и более или менее грамотный старшеклассник.
Если стоит вопрос о понимании своего проекта, ИИ-детекторы бесполезны, и даже вредны. Потому что за деньги дают ложное ощущение самостоятельной работы студента.
Очевидно, что единственный вариант корректной оценки студента, это очное финальное испытание с заданием, сгенерированным в момент начала экзамена.
ickate Автор
Добрый день, Камил! Во-первых, я абсолютно согласна с Вашим утверждением, что корректную оценку квалификации студента может дать только очная защита, либо решение конкретной задачи, полученной в момент экзамена.
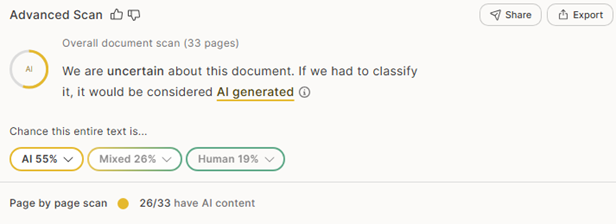
Но не согласна с первым Вашим тезисом - прямо сегодня для Вас специально сгенерировала текст по следующему промту в Клоде: предложи описание программного продукта для онлайн-поддержки принятия решений в области государственного, муниципального и другого местного территориального управления. Ключевые слова: цифровой помощник, многофакторная задача, когнитивные алгоритмы, искусственный интеллект, когнитивное социальное моделирование, деперсонализированные регионоведческие статистические данные, модели-матрицы, мобильные приложения, экспресс-анализ. 604 слова.
Ключевые слова взяла из реальной аннотации проекта, подаваемого в ФСИ. Кстати, успела получить ответ от Клода, который тут же меня заблокировал (жаль, что больше не удастся с ним поработать). Проверила сгенерированный текст на GPTZero и на Думейте. Посылаю результаты
Я проверяла сгенерированные тексты много раз- сейчас уже и Антиплагиат, и Думейт умеют определять ИИ с хорошей точностью. Более того, если я попрошу чат сделать текст более "человеческим" - показатели по ИИ в лучшем случае уменьшаться на 5-10% ( тоже проверяла). Пришлите мне Ваши тексты, если они не секретны, мне интересно проверить их в том числе.
Насчет бесполезности ИИ-детекторов также не согласна. Они не могут определить, насколько обучен студент, но определить, кто писал конкретный текст могут. А ведь это нужно не только для студентов :)))
Kamil_GR
Три промпт-итерации в пределах бесплатного лимита ии-детектора. На двух других регистрироваться не стал.
ickate Автор
Результаты GPTZero, представленные Вами, на самом деле свидетельствуют о полностью сгенерированном тексте. В моей статье есть такой абзац про особенности этого детектора:
"Следует отметить, что GZ очень осторожен, и также, как и АП, старается «не обидеть человека». Если для оценки вероятности того, что текст написан человеком, этот сервис не скупится на 98%, то вероятность написания ИИ даже для полностью сгенерированного текста он может ограничивать величиной в 60-70 %, оставляя до 30-35 % на смешанный текст и единицы % - на человеческий. Причем этот вывод относится к первичному проходу детектора по тексту, без введения "человеческой стилистики". В Вашем случае, как я поняла, было три итерации текста в пользу человека? Вот и получилось вместо 60 % - 43% ИИ.
Прогоните текст через Думейт - там бесплатная генерация и 3 проверки в день бесплатно. И этот детектор максимально объективен, насколько я убедилась.
И пришлите результат, хорошо?
Kamil_GR
Да три итерации, с просьбой откорректировать текст, руками не правился.
Проверил Думейт ... 100% человек. )
ickate Автор
Да, Интересно! А можете прислать результаты по динамике этого текста на Думейте: сгенерированный текст, 1 итерация, 2 итерация, 3 итерация. Значит, Думейт пасует перед Клодом, а перед Гигачатом - нет. Судя по Вашим данным, GPTZero наиболее надежен в детектировании перевертышей. Надо будет это поизучать....
Kamil_GR
Вообще, для типовых ии-детекторов можно протестировать такой пайплайн с несложным питоном и апи:
Парсер режет исходный текст на массив предложений.
Генератор апи запросов идет по массиву предложений, прибавляя случайный шаг из ранее сгенерированной случайной последовательности.
Зачистка оборотов - в выпавших по первой сетке предложениях причастные и деепричастные обороты либо удаляются, либо перестраиваются в простые глаголы.
Сдвиг перплексии по синонимам - модель выделяет в предложении 2–3 опорных слова (не узких термина), строит в JSON массив из 3 синонимов по убыванию частотности и принудительно подставляет 2-й или 3-й вариант, выбор случайно
Ломка длин - генерируется новая случайная сетка (1–6). Для каждого соответствующего предложения скрипт случайно выбирает одну из трех операций ужать до 4–6 слов, разбить на два коротких без союзов или слить со следующим через тире.
Но моё мнение о вреде ИИ-детекторов в высшем образовании даже при 100% точности остается неизменным.
ickate Автор
Здесь могу согласиться, по хорошему, я - за возврат к очной защите для надежной аттестации студента. Но пока тексты тоже нужно сдавать, их как-то надо проверять, и другого способа пока не предложено :))) К тому же, детекторы применяются и в редактуре научных статей, а вот тут без этого вообще никак :((((
Kamil_GR
Написал об этом статью:
https://habr.com/ru/articles/1102058/