

При выборе ИИ-инструмента для разработки обычно сравнивают модели. Какая лучше пишет код, справляется с большим репозиторием и оправдывает расходы?
Но между запросом разработчика и готовым изменением находится ещё один важный компонент — агентная оболочка или harness. Она отвечает за инструкции модели, контекст, инструменты и организацию работы с кодом. Именно от неё зависит, насколько эффективно используется модель.
Мы решили проверить это на практике. Взяли четыре модели и сравнили работу Kodik IDE с Codex, OpenCode и DeepSeek Harness на одних и тех же задачах от DeepSWE 1.1, бенчмарка ИИ-агентов. Вендор модели и вендор харнесса был один и тот же — по логике собственные модели должны отрабатывать лучше прочих (в случае опен-сорсного OpenCode использовали GLM). Во всех четырёх сравнениях Kodik решил больше задач. При этом с тремя моделями из четырёх расчётная стоимость одного успешного решения оказалась ниже, чем у конкурирующих агентов.
Что такое агентная оболочка (agent harness) и почему она влияет на результат
Нейросеть не знает заранее, где в проекте находится нужная функция и какие соглашения приняты в кодовой базе. Ей нужно исследовать репозиторий, выбрать файлы, внести изменения, запустить тесты, увидеть ошибки и при необходимости скорректировать решение.
Модель предлагает действия, агентная оболочка обеспечивает их выполнение. Она определяет, какие инструкции поступают модели, как та получает вывод терминала и результаты инструментов, что сохраняется в контексте после десятков шагов. Поэтому два продукта с одной моделью могут работать по-разному: один агент теряет найденную информацию или делает лишние запросы, другой лучше удерживает условия задачи. Это примеры, а не разбор ошибок конкурентов.
Мы развиваем Kodik в трёх направлениях: инструкции под семейства моделей, работа с контекстом и инструменты агента. Семейства OpenAI, DeepSeek и GLM по-разному реагируют на инструкции, поэтому мы создаём для них отдельные prompts, сокращая избыточные указания.
Осталось проверить, превращается ли это в дополнительные решённые задачи.
Как мы тестировали ИИ-агентов
Мы использовали DeepSWE v1.1 — набор из 113 задач по разработке ПО в 91 открытом репозитории на TypeScript, Go, Python, JavaScript и Rust. Задания создавались специально для бенчмарка, а не копировались из известных исправлений, чтобы уменьшить риск воспроизведения заученных решений.
Каждая задача начинается с определённого состояния репозитория и требования к изменению. Агент работает с кодом, после чего официальный verifier проверяет результат в отдельной чистой среде. Он оценивает поведение программы, а не буквальное совпадение с эталонным патчем. Одну задачу можно правильно решить разными способами.
Запуски проводились через Harbor с реальным Kodik IDE и соответствующим конкурирующим harness. Внутри каждой пары использовали одну модель и один набор заданий; у оболочек были собственные инструкции и инструменты. Официальные задания и verifiers мы не меняли. Сравнения проводили бок о бок, снижая влияние изменений на стороне провайдера.
Основная метрика — решённые задачи: зачёт получают изменения, которые проходят все обязательные проверки. Дополнительно мы смотрели на F2P (долю пройденных тестов), время работы, расход токенов, количество шагов и вызовов инструментов. Стоимость рассчитана по зафиксированному usage и справочным ценам на inference, а не по реальным счетам пользователей.
Дополнительно мы рассчитали стоимость одного успешно решённого задания с учётом неудачных попыток. Для этого среднюю стоимость попытки умножали на 113 — общее количество задач — и делили на число успешных решений. Аналогично рассчитывали затраченное время. Таким образом, метрика учитывает ресурсы, которые агент потратил на задачи, не прошедшие проверку. Для DeepSeek и GLM показатели использования ресурсов оценивались по сопоставимым выборкам из 92 и 108 задач соответственно.
Результаты сравнения ИИ-агентов на DeepSWE 1.1
Модель |
Kodik |
Конкурирующая оболочка |
Отрыв |
|---|---|---|---|
GPT-6 Luna · xhigh |
66/113 — 58,4% |
Codex: 44/113 — 38,9% |
+19,5 п. п. |
GPT-6.1 Sol · xhigh |
83/113 — 73,5% |
Codex: 81/113 — 71,7% |
+1,8 п. п. |
DeepSeek V4.1 Flash 1017 |
86/113 — 76,1% |
DeepSeek Harness: 78/113 — 69,0% |
+7,1 п. п. |
GLM 5.3 Flash |
73/113 — 64,6% |
OpenCode: 67/113 — 59,3% |
+5,3 п. п. |
Данные из завершённых сравнительных запусков Kodik в Harbor Hub.
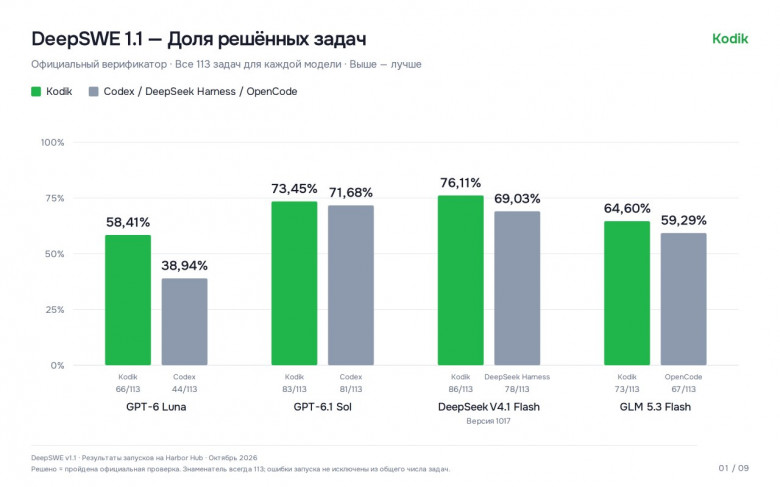
Отрыв колеблется от двух до 22 задач. Для полной картины посмотрим на стоимость:
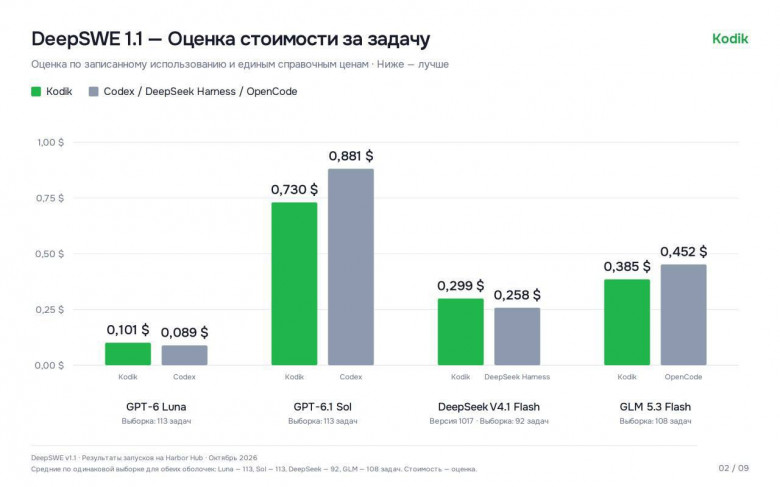
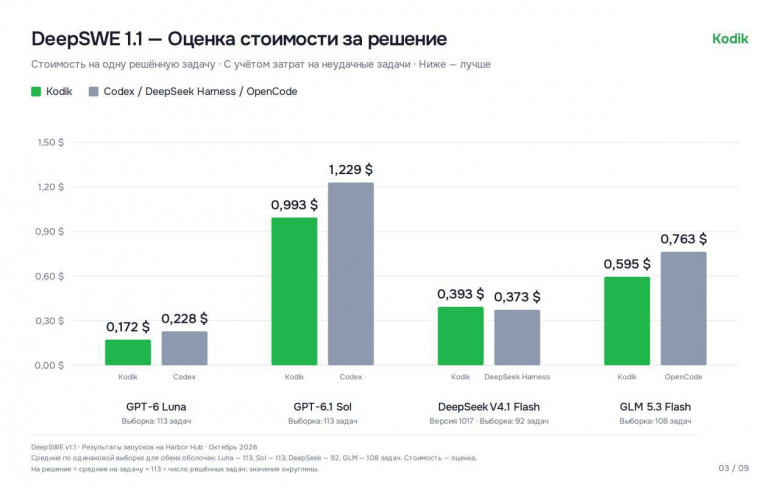
В 3 из 4 случаев вышло дешевле; в случае DeepSeek удельная стоимость незначительно выше
Время:
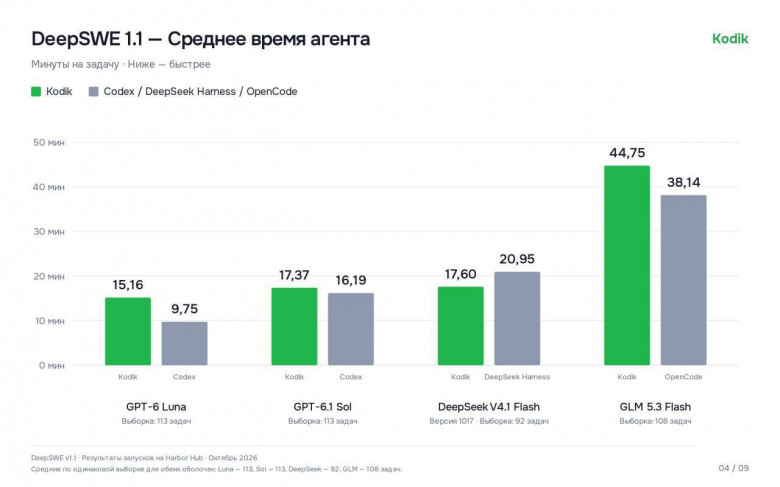
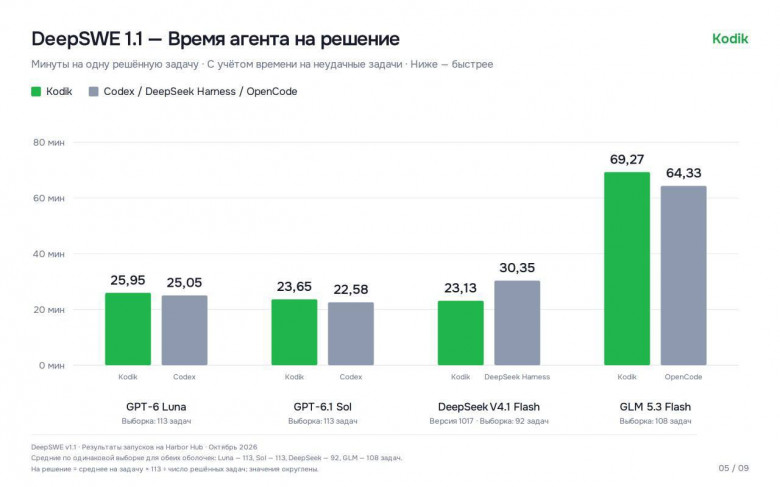
Незначительно выше при меньшей стоимости; в случае DeepSeek Harness заметно быстрее
И, наконец, технические данные:
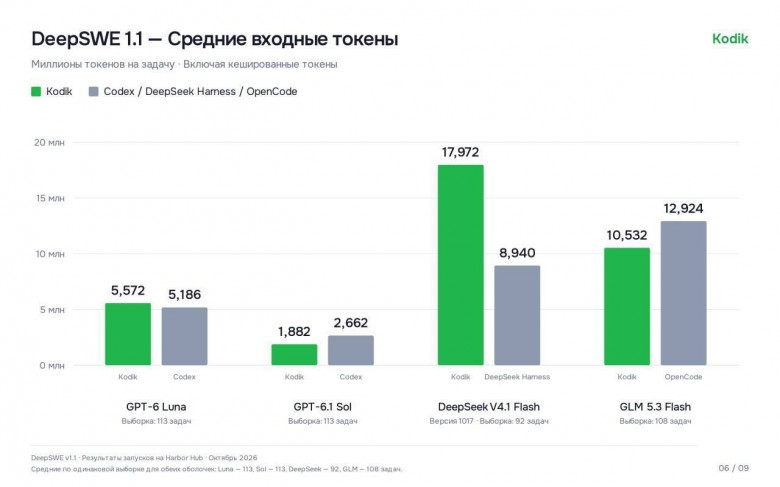
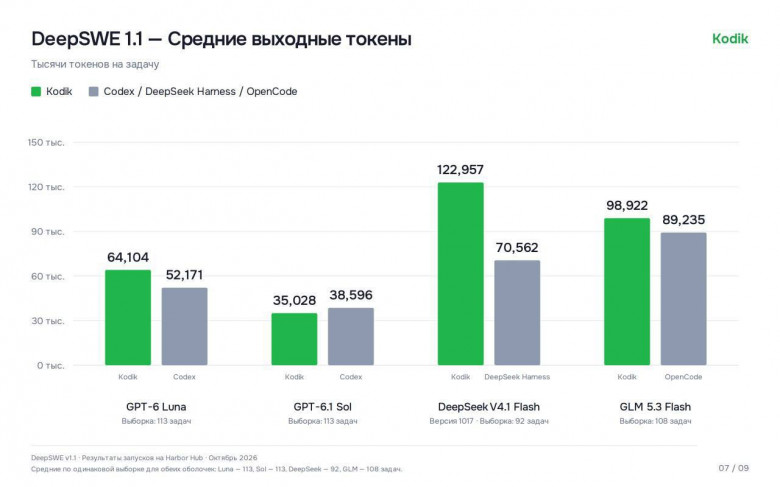
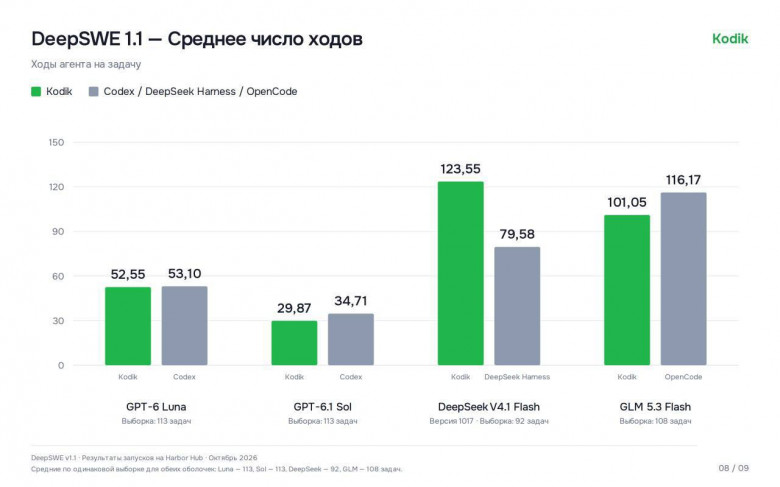
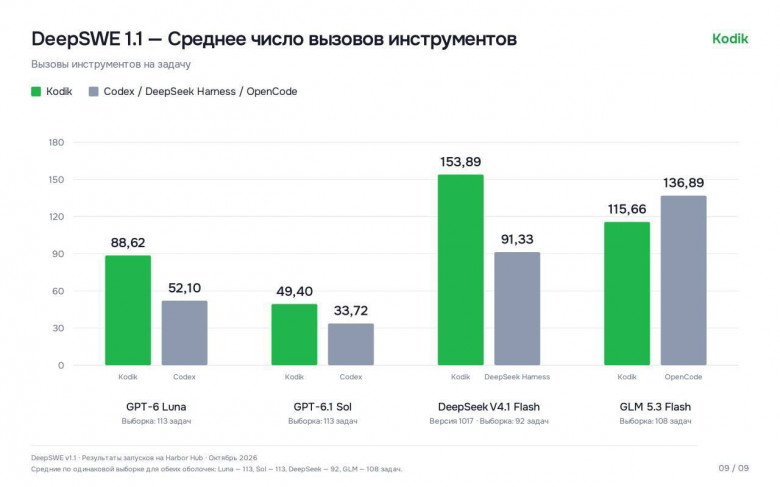
Nuff said, мы лучше.
GPT-6 Luna: плюс 22 решённые задачи
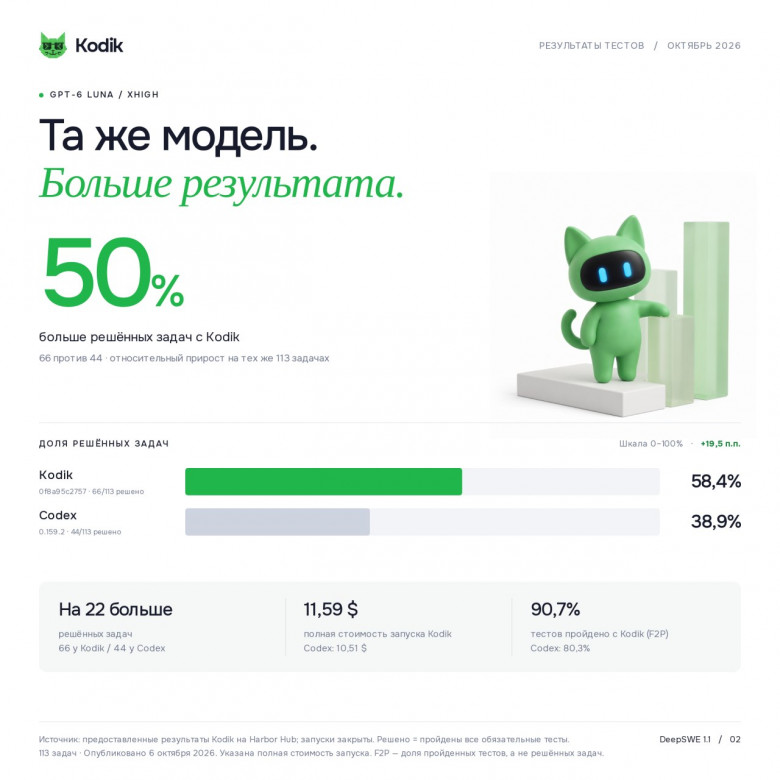
С моделью GPT-6 Luna на уровне рассуждения xhigh Kodik решил 66 задач против 44 у Codex. Это прирост на 50% относительно числа решений Codex, или 19,5 процентного пункта. Доля пройденных обязательных тестов тоже выше: 90,7% против 80,3%.
Но это не бесплатный результат. Kodik в среднем работал над задачей 15,16 минуты против 9,75 у Codex, делал больше вызовов инструментов и расходовал больше токенов. Оценочная стоимость попытки составила $0,101 против $0,089.
Хотя отдельная попытка в Kodik обходилась дороже, стоимость одного успешно решённого задания оказалась ниже: $0,172 против $0,228 у Codex. Экономия составляет около 25% с учётом расходов на неудачные попытки. А время на одно успешное решение практически сравнялось: 25,95 минуты против 25,05. Таким образом, дополнительные действия агента компенсировались значительно большим количеством успешно выполненных задач.
GPT-6.1 Sol: небольшой отрыв по задачам при меньших расходах
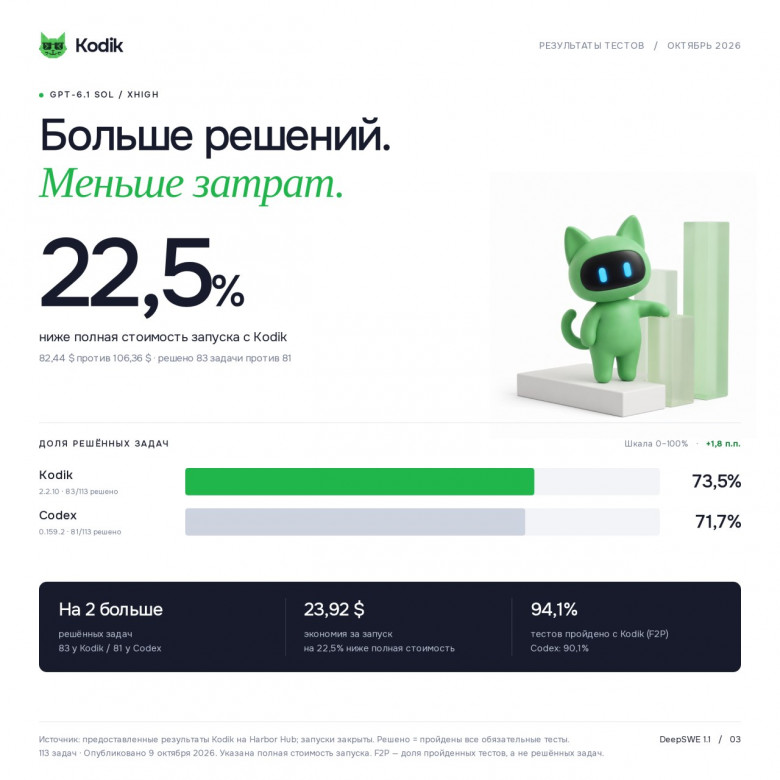
С GPT-6.1 Sol результаты ближе: 83 задачи у Kodik, 81 у Codex, или 73,5% против 71,7%. Преимущество в две задачи по одному набору нельзя выдавать за гарантию победы в любом следующем запуске. Для устойчивого вывода нужны повторные измерения.
Средняя оценочная стоимость попытки — $0,730 против $0,881, то есть примерно на 17% ниже у Kodik. Если учитывать только полученные успешные решения, но включать расходы на все попытки, разница увеличивается: $0,993 против $1,229, или примерно на 19% дешевле. Расчётное время на одно успешное решение составило 23,65 минуты против 22,58 у Codex. Входных токенов он использовал в среднем 1,882 млн против 2,662 млн; выходных — 35 тыс. против 38,6 тыс. Kodik делал больше вызовов инструментов, но меньше агентных turns.
Среднее время работы при этом было чуть выше: 17,37 против 16,19 минуты. Итог: чуть больше решений и дешевле попытка, но не быстрее.
DeepSeek V4.1 Flash: восемь дополнительных решений
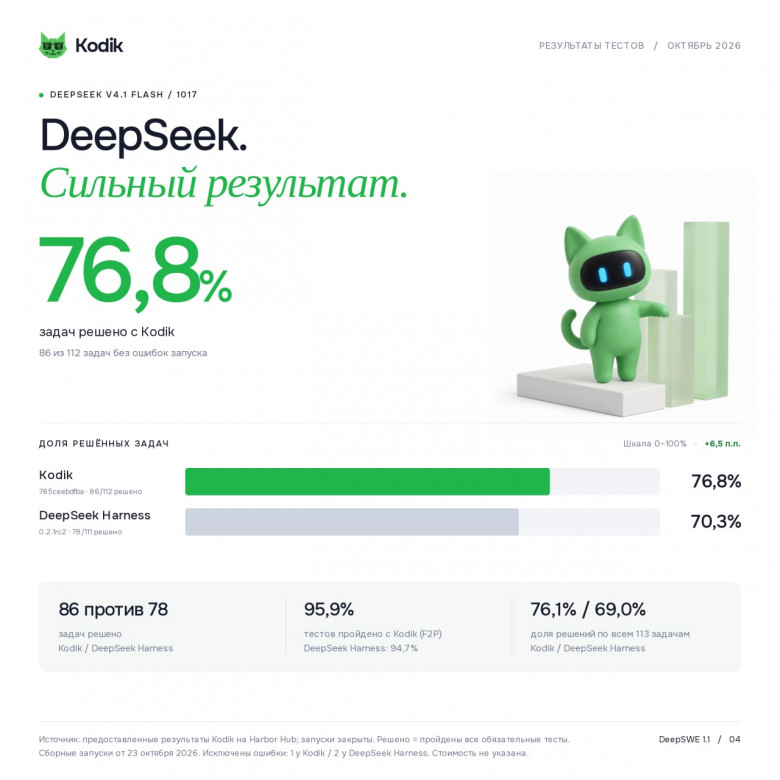
С DeepSeek V4.1 Flash 1017 Kodik решил 86 из 113 задач, а DeepSeek Harness — 78. В общей системе подсчёта это 76,1% против 69,0%. Разница — восемь задач, или 7,1 процентного пункта.
Kodik также быстрее завершал попытки: в среднем за 17,60 минуты против 20,95. Однако использовал больше входных токенов (17,972 млн против 8,940 млн), а также больше выходных токенов, turns и вызовов инструментов. Средняя оценочная стоимость на сопоставленной выборке составила $0,299 против $0,258.
Kodik решил больше задач и работал быстрее, но использовал больше ресурсов. Расчётная стоимость одного успешного решения составила $0,393 против $0,373 у DeepSeek Harness. При этом время на успешное решение сократилось с 30,35 до 23,13 минуты — почти на 24%. Таким образом, небольшое увеличение стоимости сопровождалось заметным выигрышем во времени.
Во всех актуальных сравнительных графиках доля решённых задач рассчитывается от полного набора из 113 заданий, включая ошибки запуска. Для Kodik это 86/113 (76,11%), для DeepSeek Harness — 78/113 (69,03%). Показатели времени, токенов и стоимости рассчитаны по сопоставимой выборке из 92 задач.
Запуск Kodik / запуск DeepSeek Harness.
GLM 5.3 Flash: шесть задач и экономия
С GLM 5.3 Flash мы сравнивали Kodik и OpenCode. 73 успешные задачи против 67, или 64,6% против 59,3%. Разница составила 5,3 процентного пункта.
Средняя оценочная стоимость попытки у Kodik — $0,385, у OpenCode — $0,452: приблизительно на 15% ниже. В среднем Kodik расходовал меньше входных токенов (10,532 млн против 12,924 млн), делал меньше turns и вызовов инструментов. При этом он генерировал больше выходных токенов и работал дольше: 44,75 минуты против 38,14.
Kodik не только решил больше задач, но и оказался экономичнее с учётом неудачных попыток. Расчётная стоимость одного успешного решения составила $0,595 против $0,763 у OpenCode — примерно на 22% ниже. Однако время на успешное решение было больше: 69,27 против 64,33 минуты. Таким образом, преимущество Kodik проявилось в результативности и стоимости, но не в скорости.
Запуск Kodik / запуск OpenCode.
Что именно мы улучшаем в Kodik
Не существует одной настройки, которая гарантированно прибавит любой модели десятки процентов. Агент состоит из множества компонентов, которые нужно проверять на практике.
Первое — отдельные инструкции для семейств моделей. Мы настраиваем prompts с учётом различий между OpenAI, DeepSeek, GLM и другими семействами. Общие инструкции остаются резервным вариантом. В production prompts нет решений под отдельные benchmark-задания или подсказок к скрытым тестам.
Второе — контекст. Агент, который исследует большой репозиторий, постепенно собирает требования, содержимое файлов и выводы команд. Важно удержать требования и нужные сведения, не перегружая модель второстепенным текстом.
Третье — работа инструментов и проверка результата. Мы изучаем, где агент останавливается, какие инструменты дают сбой, замечает ли он ошибки и сколько действий повторяет. Затем меняем инструкции или инструменты и тестируем снова — ради проверяемого результата, а не красивого ответа.
Это направления работы, а не доказанная причина каждой разницы в таблице: для последнего нужен детальный анализ траекторий.
Чем слабее модель, тем важнее харнесс
Особенно, на наш взгляд, интересная закономерность обнаружилась при сравнении двух моделей OpenAI. С более мощной GPT-6.1 Sol Kodik решил на две задачи больше, чем Codex: 83 против 81. Но с менее мощной GPT-6 Luna разрыв увеличился до 22 задач — 66 против 44. В относительных величинах это 58,4% против 38,9%, или на 50% больше успешных решений.
Это позволяет предположить, что возможности агентной оболочки особенно важны для менее производительных моделей. Если сильная модель способна самостоятельно компенсировать некоторые недостатки инструкций или управления контекстом, то более слабая оказывается чувствительнее к организации работы. Ей особенно важно вовремя получать нужную информацию, не терять требования задачи, правильно пользоваться инструментами и проверять собственные изменения.
Конечно, двух сравнений недостаточно, чтобы объявить такую зависимость универсальной. Но наблюдение уже представляет практический интерес.
В первую очередь — для компаний, которые планируют развёртывать ИИ-модели локально. В такой инфраструктуре выбор часто ограничен доступными вычислительными ресурсами. Вместо наиболее мощных облачных моделей приходится использовать компактные альтернативы, а значит, качество агентной оболочки приобретает ещё большее значение.
Для подобных сценариев Kodik может оказаться особенно полезным: грамотно организованная работа агента помогает получать больше результатов даже от моделей с ограниченными возможностями. Насколько велико это преимущество на конкретных локальных моделях, покажут отдельные тесты.
Чего эти результаты не доказывают
Бенчмарк не охватывает все языки и процессы — например, командное ревью и поддержку production. Одна кампания не гарантирует преимущества на любом коде; разница в две задачи может измениться при повторном запуске.
Важна и надёжность самого grader. В аудите DeepSWE v1.1 от 7 сентября 2026 года исследователи Samaritan Research сообщили о проблемах проверки как минимум в 23 из 113 задач: в частности, тестовая инфраструктура может отклонить корректное решение из-за конфликтов с изменёнными тестами. Поэтому незачёт не всегда означает ошибку в коде.
Наши результаты не являются независимой сертификацией Kodik или заявлением о безусловном превосходстве над всеми агентами. Мы сравнивали конкретные версии, настройки и модели, а не весь рынок. И фиксировали не только успешные решения, но и цену результата: в опытах с Luna и DeepSeek Kodik использовал больше ресурсов на задачу.
Ссылки на Harbor позволяют изучить конфигурации и траектории, а не только финальные проценты. Указанные цены — оценка inference, не стоимость подписки или труда разработчика.
И что же из этого следует?
У каждого сравнения свой профиль. С Luna Kodik решил на 50% больше задач, а стоимость одного успешного решения оказалась на 25% ниже. С Sol преимущество по числу решений небольшое, зато успешный результат обходился примерно на 19% дешевле. С DeepSeek Kodik работал быстрее и решил больше задач, хотя стоимость успешного решения была немного выше. С GLM удалось получить больше успешных решений при экономии около 22%, но с увеличением времени работы.
Важно и то, с кем именно мы сравнивали Kodik. В тестах с GPT-6 Luna и GPT-6.1 Sol его соперником был Codex — агент OpenAI, работающий с моделями собственной экосистемы. Аналогичная ситуация с DeepSeek V4.1 Flash: Kodik соревновался с DeepSeek Harness, разработанным для моделей DeepSeek.
Получается, Kodik обошёл конкурентов на их же поле: одни и те же модели, одинаковые инженерные задачи, но разные агентные оболочки. Даже нативные решения не смогли добиться такого же количества успешно выполненных заданий.
Именно это делает результаты особенно показательными. Преимущество обеспечивается не доступом к какой-то уникальной модели, а тем, как агент организует её работу.
Мы продолжим развивать системные промпты, контекст и инструменты Kodik IDE и проверять результаты на новых моделях. Наша цель — как можно больше изменений, которые доходят до рабочего состояния с меньшим объёмом ручного управления агентом.
Для нас бенчмарки — не только возможность сравнить Kodik с конкурентами, но и инструмент развития продукта. Далее планируем публиковать сравнение Kodik IDE с другими харнессами. Что было бы интереснее оценить в сравнении? Поделитесь.
Комментарии (22)

alexed34-2022
29.10.2026 14:59установил, хотел подключить свой api провайдера, нет только для платников эта возможность. удалил , буду продолжать пользоваться opencode, наверно не сильно вам нужно увеличение пользователей вашим продуктом

Kodik_AI Автор
29.10.2026 14:59Раньше у нас был бесплатный доступ для всех, но из-за злоупотреблений его пришлось временно отключить.
Сейчас выдаем триал по запросу: напишите нам в tg @Kodik_AI или на почту info@kodik.ru Выдадим тестовые кредиты, чтобы вы могли попробовать наш продукт в деле.
Плюс в ближайшее время запустим недорогую подписку без встроенных кредитов, а когда выпустим CLI возможно добавим и совсем бесплатный формат доступа через него.
И да, мы всегда рады новым пользователям!

gevals
29.10.2026 14:59Это же все за токены? Эх, если бы через подписку, того же chatgpt.. фантастические мечты ))
Kodik_AI Автор
29.10.2026 14:59Тесты прямо затрагивали вычислительные мощности моделей, затраты на вызов инструментов и ходы. Так что да, за кредиты.(
Запрос на бесплатный формат видим, по понятным причинам он популярен. Выше чуть рассказали о наших ближайших планах на этот счёт.

jorisploski
29.10.2026 14:59(Я не шибко сведущий в технологии, просто интересующийся)
Сама оболочка агента - доступна только онлайн или локально тоже? Не было тестов на более слабых моделях? (Совсем уж мелких которые может завести потребитель без огромных мощностей)
Kodik_AI Автор
29.10.2026 14:59Оболочка доступна локально с учётом ограничений локального формата (без веб-поиска, подключения MCP и пр.). Слабее GPT-6 Luna и DeepSeek V4.1 Flash пока не тестили, однако считаем, что и на них результат показательный.
Какие модели из бюджетных вам было бы интересно сравнить? Учтём в последующих тестах.jorisploski
29.10.2026 14:59Хмм не рассчитывал на быстрый ответ
Жаль что локальный агент теряет в функционале
Так ради интереса посмотрел бы в сторону всего, что влезет на 16гб ddr4 и есть ещё gtx1660 super
И как интересный вопрос - а будет ли ощутимая разница в коде если прикрутить навык от автора "чистый код"?
Спасибо за ответ

Sabin
29.10.2026 14:59Ничего не влезет локально на 1660 super, будут единицы токенов в секунду. У агентов только системный промт легко съест несколько тысяч токенов и попытка прочитать файл с кодом для ознакомления заполнит контекст. В сторону чат ботов смотрите и то будет медленно.
16 Гб VRAM или 24 Гб унифицированной - не комфортный минимум для агентов, ещё хотя бы +8 Гб нужно, чтобы не работать с крошечным квантованным контекстом.
12b-14b модели поместятся в 8-12 Гб, может даже в 6 Гб, но у них уже идут проблемы с вызовом инструментов, путаница в файлах и т.п.
Просто поболтать попробуйте llama-server из llama.cpp и модель gemma-4-12b в формате UD-IQ3_XXS или подобном, контекст в формате q8 скорее всего придется

dilmah949
29.10.2026 14:59А вот в чем проблемма сделать подписку, я не могу понять? Жадность? Это глупо,т.к. по подписке, те кому надо тратили бы не меньше денег, а сейчас приходится решать многие задачи в чате и тоько потм лезть в агента за баксотокены? Разве это сложно осознать? Или подписка просто технически не возможно?
Kodik_AI Автор
29.10.2026 14:59Подписка у нас есть со старта, причём не одна: Pro и Super Pro. В рамках каждого тарифа пользователь ежемесячно получает определённый объём кредитов. Возможность докупки кредитов по себестоимости API-запросов в подписке также предусмотрена. Также можно подключить и свои модели по принципу Bring Your Own Key (BYOK).
Вероятно, вы имеете в виду не подписку, а безлимитное использование агента, что несколько разные вещи. Стоимость агентных задач может различаться в десятки раз в зависимости от модели, объёма контекста и количества обращений к инструментам. Поэтому безлимит за фиксированную сумму неизбежно требует либо ограничений на использование (по модели Codex или Claude Code), либо существенного повышения стоимости подписки.
Понимаем ваше желание работать с агентом, не задумываясь о каждом потраченном кредите. ОС вполне обоснованная, но вопрос здесь не в отсутствии подписки (она есть).

DopeBat
29.10.2026 14:59Все модели посадили в родные харнесы, а глму почемуто zcode не дали
Sabin
29.10.2026 14:59А он в родном на удивление хорошо работает, только токены просто улетают. По результату розданных миллионов, остатки которых сгорели всего через пару часов после начисления, маленькая задача легко 15-30 миллионов на среднем (high) рассуждении и 5-10 на low тратит забивая контекст на половину-четверть
Миллиона полтора ему только ознакомиться с задачей
В начале сказать Тестируй, сервер доступен так-то и все сам кладёт, запускает в своём браузере, тыкает кнопки, делает скриншоты.
Может сказать, что какая-то задача не выполнима в текущих версиях, надо переносить из нового или писать недостающие функции, делать?
Проверял написав себе плагины для браузера, для Forge neo, попросив сделать админку для выдуманного сайта, попросив сделать сайт со статусами, дав доступ к локальной копии куска БД и локальному же веб серверу.
Минус - когда словами просил составить только план / ТЗ и не начинать, всё равно брался через раз сам выполнять, это без включённой галочки плана если.
DopeBat
29.10.2026 14:59Юзаю через подписку и наоборот всегда удивляюсь как мало контекста у него уходит на довольно объемные правки и разные манипуляции. Рассуждения с max никогда не снимаю. Может за счет множества отдельных операций он и сожжет в итоге больше токенов чем другие - не особо сравнивал, с подпиской пофигу. В опенкоде раньше подобные вещи очень быстро съедали 200к контекста при кодовой базе ~200кб, а в зкоде нормально с мегабайтом кода может работать в рамках 200к контекста.
Kodik_AI Автор
29.10.2026 14:59Да, согласны, немного рассинхрон.)
Выбрали OpenCode для справедливости сравнения, ниже частично описали, почему (z.code тратит очень много токенов). Однако мы и z.code обязательно учтём, спасибо за рекомендацию!

german25avenue
29.10.2026 14:59Подробнее бы рассказали про задачи и критерии успеха. Очень уж подозрительно то, что модель уровня GPT Astra(6.1 Sol) справилась хуже чем дешевый DeepSeek. Я таких результатов ни разу видел.
Kodik_AI Автор
29.10.2026 14:59Запуск по бенчмарку DeepSWE 1.1, ссылки на результаты запусков есть в статье, внутри блоков сравнения харнессов по каждой модели. Например, запуск GPT-6 Luna в Kodik IDE.
Задачи во вкладке "Trials" по той же ссылке.

Mdm3
29.10.2026 14:59Зря вы так на DeepSeek. Не знаю в чем конкретно здесь нюанс. А у меня были эпизоды, когда модель антропика выедала 5ч сессию и давала отрицательное заключение, что решить задачу нельзя, а GLM 5.2 решал почти на легке (GLM 5.3 тогда еще не вышла). В задаче надо было устранить задержку при кодировании потокового видео и opus сказал, что дело в проприетарном драйвере, все перепробовал и ничего сделать нельзя, а GLM просто по другому стал работать с драйвером и проблему решил.
С DeepSeek vs Sonnet была подобная история, но не помню уже детали. Попробовав разное, в общем уже не топлю за американцев, что их модели прям топ.
Mdm3
29.10.2026 14:59Правильно понял, что локальную LLM (например Qwen 27b) с Kodik не получится использовать, как например в opencode? Или возможно?
Кроме харнеса еще важен процесс вокруг ИИ агентов, как организован. От этого результат разработки зависит гораздо больше, имхо.
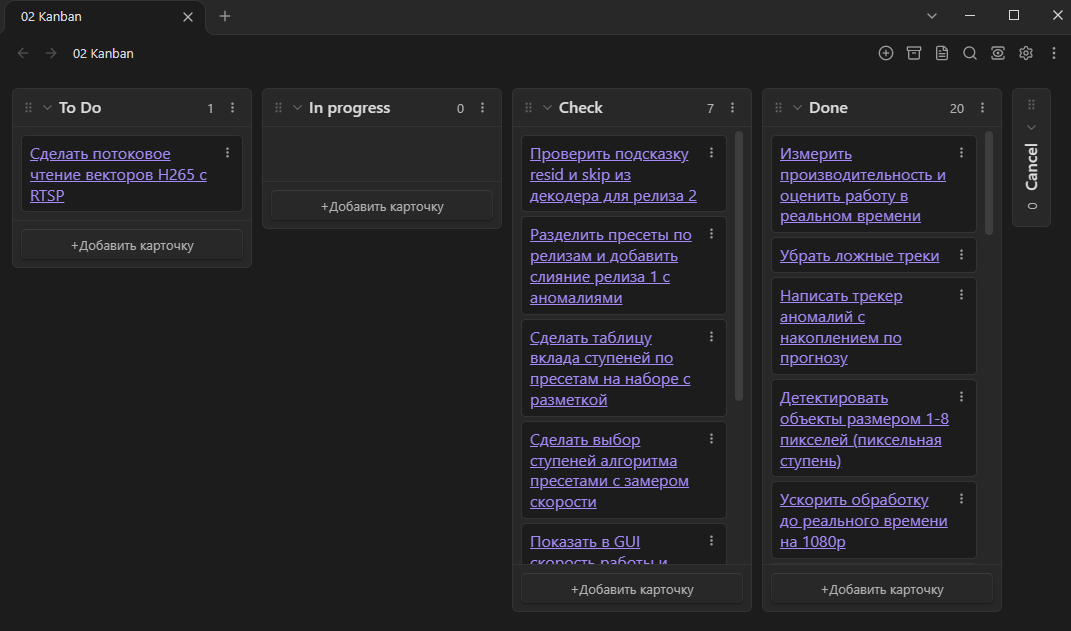
Когда стал работать с вынесенным в локальную wiki контекстом и доской канбан (obsidian) сложность и скорость проектов выросла очень существенно, сохранив управляемость и надежность. А значимость, в чем кодить, opencode, claude code или dsh наоборот снизилась.
PS: Пример доски мини-проекта ниже, а тут результат (распознавание очень мелких движущихся объектов): https://youtu.be/8wMZgFRSSM8

Uglevod
29.10.2026 14:59Так вы сравнивали результативность кодика с обвесом ( причем обвес не раскрыт, MCP и т.д.) - против и агентов без обвеса ?
При этом независимо проверить ваши данные непредставляется возможным по причине - я не нашел как подрубить стороннюю ии.
Ну, тогда это больше похоже на cursor , ИМХО.
т.к. opencodе например это опенсорс, с выложенным кодом на github.
т.е. разные весовые категории.
Планируете выложить результативность по сравнению с cursor ?
Оффтоп, Вечером 29 видел новости про выход новой модели от сбера - на утро на мобильном сайт opencode перестал быть доступным, совпадение ?
Взялись по ходу за ии конкретно.
AnSt
А вот моё недавнее сравнение - https://rutube.ru/video/0cf181ee2c949525369fc53063b1001d/
И, если честно, я от Kodik Chat’а ожидал большего.
Но я ещё буду на разных сценариях использования сравнивать разные ИИ. Посмотрим что получится.
Kodik_AI Автор
Здравствуйте!
Статья про Kodik IDE, а не про KodikChat. Разные продукты. Сравнивать ИИ-чаты по написанию кода не совсем корректно, так как они не совсем для этого предназначены. Отправили вам в Tg-чате предложение на этот счёт — загляните!
И, как мы вам уже ответили в Tg-чате, KodikChat пока не вышел в широкий доступ, активно дорабатывается. Запуск уже скоро — было бы здорово, если бы вы и его перепроверили.
AnSt
Я протестировал что мне было доступно. До этого теста Kodik Chat выдавал отличнейшие результаты. Мне он очень нравится. А то что он в бете доступен - тем будет интереснее посмотреть, как он потом будет работать. В планах у меня ещё несколько видео с разными запросами.