

Главный секрет эффективности Mixture of Experts (MoE) по сравнению с Dense-моделями кроется в их разреженности: экспертов в пуле гигантское количество, но на генерацию каждого конкретного токена активируется лишь крошечная их часть.
Например, Qwen3.8-Flash-Next насчитывает 125 миллиардов параметров и 24 576 экспертов, но на один токен задействуется всего около десятка. Обычная же Dense-модель аналогичного размера обязана вычитывать из памяти абсолютно все веса на каждом шаге. Именно эта архитектурная особенность MoE моделей и позволила в конечном счете запускать большие модели на потребительском железе.
Не смотря на то что MoE использует небольшую часть своих экспертов хранить нужно все веса, ведь разреженность сокращает вычисления на токен, но не байты, которые нужно держать для работы модели. Но что, если сделать для модели иерархию памяти, как у процессора с кэшами?
Именно это и сделал проект Strata:
L1 кеш: в видеопамяти лежат слои внимания, DeltaNet, роутеры, наиболее востребованные эксперты, MTP-слой, KV-кэш и кэш самых используемых экспертов.
L2 кеш: в оперативной памяти лежат все 24 576 экспертов, с которыми процессор работает параллельно GPU.
L3 кеш: на диске лежит таблица n-gram размером несколько десятков гигабайт. Поскольку на один токен оттуда запрашиваются буквально считанные строки, скоростей SSD хватает с головой.
Подобные гибридные схемы пытались внедрять и раньше, но они традиционно утыкались в пропускную способность PCIe-шины. Strata решила эту проблему: если нужного эксперта не оказалось в VRAM, его не гоняют по медленной PCIe-шине, а задействуют прямо в оперативной памяти с помощью CPU.
При таком подходе объем видеопамяти по-прежнему критически важнее чистой вычислительной мощности GPU: каждый дополнительный гигабайт VRAM позволяет разместить в быстром кэше примерно 700 дополнительных экспертов. При этом остальное железо (проц, память, диск) начинает активно участвовать в вычислениях.
Прелесть этого подхода еще и в том, что ставшие уже стандартными оптимизации вроде MTP (Multi-Token Prediction) и предсказания/подгрузки экспертов следующего слоя параллельно с обсчетом внимания текущего здесь тоже вовсю работают.
Я не буду подробно останавливаться на установке (в одну команду) и настройке (пошаговым мастером настройки стрелками и кнопкой ввода). Лучше разберу, что конкретно предлагается, а также насколько быстро и качественно оно работает.
На текущий момент проект поддерживает запуск трех моделей: Qwen3.8-Flash-Next, Qwen3.6-35B-A3B и DeepSeekV4.1-Flash-1017. Среднюю модель мы опустим как наименее интересную, а на двух флагманах остановимся подробнее.
Наиболее качественные кванты этих моделей на текущий момент предлагает лаборатория распределенных алгоритмов и систем при Австрийском институте науки и технологий.
Лаборатория специализируется на усовершенствовании GSQ/RCO методов квантования и выкладывает результаты исследований на HuggingFace. Предложенные ими методы квантования позволяют существенно сжать модели с минимальными потерями качества.
При этом выбор оптимального кванта теперь привязан не столько к чистой VRAM, сколько к суммарному объему видео- и системной памяти. Минимальные пороги входа для использования их квантов выглядят следующим образом.
Для Qwen3.8-Flash-Next (180B):
Размер кванта |
RAM + VRAM |
|---|---|
Q2_0 |
~38 GB |
IQ2_XS |
~40 GB |
IQ3_XXS |
~47 GB |
IQ3_S |
~55 GB |
Для DeepSeekV4.1-Flash-1017 (763B):
Размер кванта |
RAM + VRAM |
|---|---|
IQ1_M (1.75 bpw) |
~46 GB |
IQ2_XXS (2.00 bpw) |
~54 GB |
IQ2_XS (2.25 bpw) |
~64 GB |
Более детально о выборе квантов под ваше железо можно почитать здесь. Если суммарного объема памяти меньше, то это не значит что ничего не запустится. Запустится, но работать будет медленнее. Ориентиры (из интернета) по скорости следующие.
Qwen3.8-Flash-Next (180B):
Железо |
Квант |
Decode, ток/с |
|---|---|---|
RTX 5070 12 GB, Ryzen 5 7600, 64 GB RAM |
Q2_0 / IQ2_XS / IQ3_S |
94 / 79 / 53 |
RTX 4070 12 GB, i5-12600KF, 32 GB RAM |
IQ2_XS |
48 |
RX 9070 16 GB, 5800X3D, 64 GB RAM |
IQ3_XXS |
58 |
RTX 5070Ti 16 GB, 64 GB RAM |
IQ3_S |
30 |
RTX 5060Ti 16 GB, 128 GB RAM |
IQ3_S |
48 |
2x TITAN RTX 24 GB, Xeon E5-2696 v4, 125 GB RAM |
IQ3_S |
77 |
Strix Halo (ноутбук), 128 GB RAM |
UD-IQ4_XS |
40 |
Radeon 780M (встройка), 60 GB RAM |
Q2_0 + MTP |
14 |
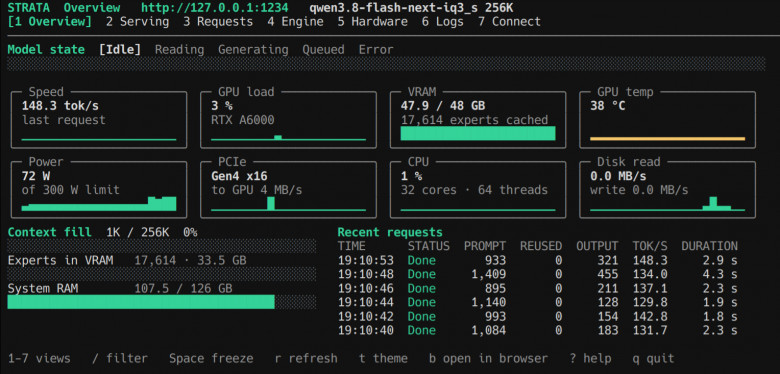
Мой замер: IQ3_S квант на RTX A6000 48GB + 128GB RAM и Threadripper 3970X с 256К контекстом выдает 150 токенов в секунду.
DeepSeekV4.1-Flash-1017 (763B):
Железо |
Квант |
Decode, ток/с |
|---|---|---|
RTX 3060 12 GB, 46 GB RAM |
IQ2_XXS (2.00 bpw) |
10 |
RTX 4000 SFF Ada, 64 GB RAM |
IQ2_XXS (2.00 bpw) |
6 |
RTX 5070 12 GB, 64 GB RAM |
IQ2_XXS (2.00 bpw) |
5 |
RTX 5070Ti 16 GB, 64 GB RAM |
IQ2_XXS (2.00 bpw) |
12 |
RTX 4090 24 GB, 96 GB RAM |
IQ2_XXS (2.00 bpw) |
15 |
RTX 4090 24 GB, 90 GB RAM |
IQ2_XS (2.25 bpw) |
25 |
Ryzen 5 5600, 96 GB DDR4 (2400 MT/s) + RTX 3090 |
IQ2_XS (2.25 bpw) |
13 |
Radeon AI PRO R9700, 251 GB RAM |
IQ2_XXS (2.00 bpw) |
23 |
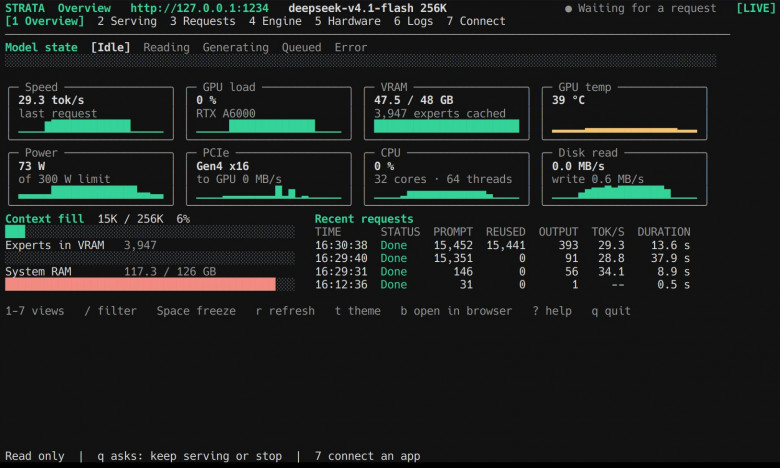
Мой замер: IQ2_XS (2.25 bpw) квант на RTX A6000 48GB + 128GB RAM и Threadripper 3970X с 256К контекстом выдает 30 токенов в секунду.
Такая скорость получается за счет агрессивного квантования, но т.к. кванты имеют разную точность по разным слоям стало возможно добиться следующего уровня качества: IQ3_S сохраняет 90,0%, IQ3_XXS 87,3%, IQ2_XS 85,0%, Q2_0 84,1%, а UD-Q4_K_XL 94,1% от базовой BF16 модели.
К сожалению, подобная агрессивная оптимизация движка под кванты сделала невозможным запуск моделей других архитектур и семейств, поэтому появился форк Strata под названием Project Maya.
Он позволяет запускать GLM-5.3-Flash (321 B), DeepSeek-V4.1-Flash-1017 (748 B) и MiniMax-M3.1-Flash (428 B). Мы рассмотрим GLM-5.3-Flash (321 B) т.к. она поставлется в аблитерированном (uncensored) варианте и является хорошим вариантом для реверс инжиниринга, а контекст до 1M делать действительно долгие сессии без сжатия контекста.
Авторы выпустили собственные кванты:
Вариант |
Размер |
Для кого |
Сохранение точности vs FP8 |
|---|---|---|---|
Maya-S |
96,5 ГБ |
карты до 16 GB |
97,9% |
Maya-S24 |
94,7 ГБ |
карты от 16 до 24 GB |
97,7% |
Maya-M |
116 ГБ |
карты от 24 до 48 GB |
97,9% |
Maya-L |
156,3 ГБ |
карты от 48 GB и выше |
99,2% |
Минимум для запуска: 32GB RAM
Скорость (из интернета):
Железо |
Модель |
Decode |
Prefill |
|---|---|---|---|
2x H100 80 ГБ |
Maya-L, 1M |
122–124 |
~2000 |
4x RTX 4090 |
S24 |
118 |
4129 |
RTX PRO 6000 Blackwell |
M, 256K |
81 |
3102 |
2x RTX 3090 (225 Вт) |
S24 |
53 |
885 |
RTX 3090 + RTX 3060, EPYC 8-канал |
M |
33,7 |
682 |
RTX 5090, Ryzen 9 7950X, 96 ГБ DDR5 |
M |
30+ |
~2000 |
RTX 3090 24 ГБ, 128 ГБ RAM |
S24 |
26,0 |
913 |
RTX 5090, 64 ГБ, Win 11 |
S |
23,0 |
2173 |
RTX 4090 24 ГБ, Ryzen 7 9700X, 64 ГБ |
S24, 32K |
16,6 |
1320 |
RTX 5090 Laptop 24 ГБ, 64 ГБ |
S24 |
14,5 |
994 |
Radeon 8060S (Strix Halo), 128 ГБ, Win 11 |
S |
18,3 |
320 |
NVIDIA DGX Spark |
S, 128K |
16,5 |
~730 |
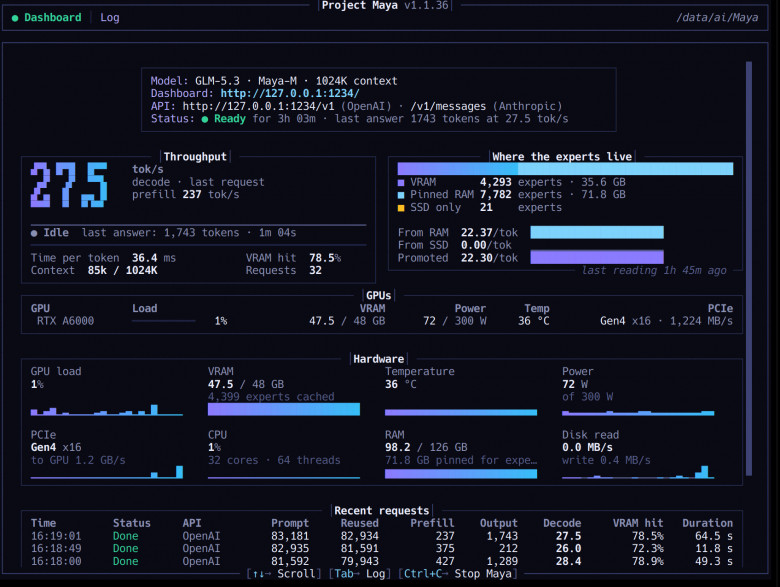
Мой замер: Maya-M квант на RTX A6000 48GB + 128GB RAM и Threadripper 3970X на 1M контексте выдает 28 токенов в секунду.
Итог
Концепция иерархичной памяти в сочетании с узкоспециализированными движками и MTP ускорением доказала свою состоятельность. Qwen-125B на RTX 5070 с 12 ГБ VRAM выдает десятки токенов в секунду, а GLM-321B уверенно запускается на одной RTX 3090, обеспечивая 20–35 ток/с. Подход отлично масштабируется: даже DeepSeek-748B физически помещается на потребительском железе, пусть и выдавая скромные (пока что) 4–6 ток/с.
Однако за этот прорыв приходится платить: в ход идут агрессивные квантования до 2–3 бит, 64–128 ГБ быстрой оперативной памяти и быстрые NVMe-накопители.
Вопрос “Влезет ли модель?” уходит в прошлое. Теперь задается другой вопрос: “Сколько битов квантования вы готовы сбросить ради скорости?”, и у каждого пользователя здесь будет свой ответ.
Мы вступаем в эру ИИ-специализации: рынок постепенно отходит от универсальных облачных гигантов в сторону узкоспециализированных решений.
Не смотря на это модели общего назначения удерживают свою актуальность за счет точечной оптимизации квантования и продвинутых движков инференса, проходя путь от облачных решений до локальных вариантов на потребительских ПК. И эта тенденция не может не радовать.
Комментарии (8)

Ka463
30.10.2026 16:04Отличная статья, расширяет кругозор того что можно попробовать.
Кстати на счет крупных игроков, тех же Open AI и т.д, в каком кванте они запускают собственные модели и как именно, мы незнаем.
Кто знает, может быть они тоже используют что то из похожих технологий вроде Strata

artden111
30.10.2026 16:04А почему для Qwen3.8-Flash-Next не упомянуты кванты UD-IQ4_XS и UD-Q4_K_XL? Владельцы 32 Гб VRAM вполне могут их себе позволить. Сам юзаю UD-Q4_K_XL и не вижу смысла опускаться на кванты ниже ради скорости, т.к. модель при этом тупеет

rusplay
30.10.2026 16:04Интересная статья, думаю стоит подумать и над горизонтальным масштабированием. Сделать аналог хард для модели и распределять запросы между серверами
Evgenii64
Один вопрос - а для чего? Именно с этого и надо начинать.
Soren
Для локальной работы с ИИ.
Если такие вопросы появляются, скорее всего, статья просто не для вас.
Сам с полмесяца кручу 3.8 на 4070TiS+64G — очень доволен.
pa_kru
На перспективу, прослеживается тренд, что модели со временем становятся все лучше и лучше, и однажды пользователь поймет, что ему не нужно будет платить за токены/подписки, когда все может работать локально на его железе.
ToxaBes Автор
Сэм Альтман, перелогиньтесь.