

При оценке производительности систем со сборщиком мусора и анализе задержек в хвосте распределения часто используются бенчмарки SPECjbb2015 и DaCapo. Оба предусматривают механизмы коррекции скоординированного пропуска измерений (coordinated omission), однако только SPECjbb2015 позволяет запускать генератор нагрузки и серверную часть как в одной виртуальной машине Java (JVM), так и в отдельных JVM. В этой статье мы подробно рассмотрим возможности SPECjbb2015 и на их примере покажем, какие риски возникают при размещении генератора нагрузки и серверной части в одной JVM.
1. Предыстория
Генераторы нагрузки, используемые для измерения задержек, должны учитывать эффект скоординированного пропуска измерений (coordinated omission). Эта проблема возникает, когда генератор нагрузки отправляет запрос с помощью блокирующего вызова, из‑за чего следующий запрос не может быть отправлен до получения ответа на предыдущий.
Хотя время отправки можно скорректировать, такая коррекция не позволяет воспроизвести реальный поток запросов, которые поступили бы в очередь серверной части, если бы генератору не приходилось дожидаться ответа перед отправкой следующего запроса. Один из способов коррекции — фиксировать запланированное время отправки каждого запроса. Тогда любая последующая задержка отправки, вызванная блокирующими вызовами, будет учтена, поскольку время отклика рассчитывается относительно запланированного момента, а не фактического времени отправки. Однако если работа генератора нагрузки приостанавливается из‑за сборки мусора (GC), вследствие чего он не может планировать отправку запросов, скорректировать результаты значительно сложнее.
Для каждого запроса генератор нагрузки обычно фиксирует три временные точки:
Запланированное время отправки (когда запрос должен был быть отправлен).
Фактическое время отправки.
Время получения ответа (момент, когда ответ был получен).
Фактическое и запланированное время отправки могут различаться, если генератор нагрузки не способен отправить следующий запрос до получения ответа на текущий.
1.1. SPECjbb2015
Этот бенчмарк предназначен для тестирования производительности Java‑серверов. Подробное описание его архитектуры доступно здесь. Если изложить суть кратко, опустив детали, несущественные для нашего исследования, SPECjbb2015 моделирует работу международной сети супермаркетов. Для этого в его состав входит генератор нагрузки, который отправляет запросы двух типов: запросы без ожидания ответа (saturate) и диагностические запросы для измерения производительности (probe). Последние используются для измерения времени отклика и блокируют выполнение до получения ответа.
При измерении времени отклика и отправке запросов внутри блокирующей функции необходимо учитывать эффект скоординированного пропуска измерений. Запросы не существуют в вакууме. Генератор нагрузки должен формировать их с определённой частотой — ограниченной или неограниченной. Но независимо от выбранного режима, если следующий запрос не может быть отправлен из‑за того, что текущий ожидает ответа, результаты измерений начинают отклоняться от предполагаемой модели поведения системы. Например, это происходит, когда серверная часть надолго приостанавливает работу из‑за сборки мусора.
В SPECjbb2015 реализован механизм коррекции скоординированного пропуска измерений: бенчмарк фиксирует запланированное время отправки запроса и использует его в качестве отправной точки для расчёта времени отклика.
SPECjbb2015 поддерживает несколько режимов запуска, различающихся степенью изоляции компонентов и способом их взаимодействия:
Режим |
Отдельные JVM |
Сериализация трафика |
Сетевой стек |
Соответствие правилам |
Composite |
❌ |
❌ |
❌ |
✅ |
Composite‑Net |
❌ |
✅ |
✅ |
❌ |
MultiJVM |
✅ |
✅ |
❌ |
✅ |
Distributed |
✅ |
✅ |
✅ |
✅ |
2. Экспериментальная конфигурация
В нашем исследовании используются режимы Composite‑Net и Distributed (с подключением через localhost). Это позволяет обеспечить одинаковые накладные расходы на взаимодействие компонентов и задействовать сетевой стек в обоих случаях. Использование Composite/MultiJVM было бы столь же обоснованным вариантом экспериментальной конфигурации.
Кроме того, мы используем SPECjbb2015 версии 1.04 и OpenJDK 27 с параметром ‑Xlog:gc*,safepoint под управлением Linux с ядром 6.8.0. Для всех сборщиков мусора отключены прозрачные огромные страницы памяти (Transparent Huge Pages).
Для регистрации времени обработки всех запросов добавлено событие JFR, позволяющее свести к минимуму накладные расходы и влияние самого процесса наблюдения на результаты.
Интенсивность поступления запросов (Injection Rate, IR) установлена на уровне 6000 запросов в секунду. Для каждого сочетания параметров предусмотрено не менее 240 секунд работы в установившемся режиме и десять отдельных запусков JVM.
Тестируемая система имеет следующие характеристики:
cpu                 AMD Ryzen 9 5900X 12-Core Processor
Ядра               24  (12 physical, SMT enabled)
Память              128 GB
governors           24 x performance   (all cores)
Для режима Distributed намеренно выделено больше оперативной памяти в совокупности, чем для Composite‑Net, чтобы исключить возможность объяснить различия в задержках нехваткой памяти.
Кроме того, в режиме Composite‑Net используется только половина процессорных ядер. В режиме Distributed серверная часть работает на другой половине процессора, а контроллер и компонент txinjector — на первой. Это позволяет учесть дополнительные накладные расходы, возникающие из‑за использования трёх JVM, каждая из которых имеет собственный набор потоков, в том числе для сборки мусора.
Компонент |
Composite‑Net |
Distributed |
composite |
16 ГБ |
— |
backend |
— |
16 ГБ |
controller |
— |
2 ГБ |
txinjector |
— |
4 ГБ |
Всего выделено памяти |
16 ГБ |
22 ГБ |
Для всех куч заданы параметры -Xms/-Xmx и +AlwaysPreTouch. Таким образом, память выделяется и заранее затрагивается при инициализации, что позволяет уменьшить разброс результатов.
Параметры, влияющие на внутреннюю многопоточность, зафиксированы, чтобы изменения конфигурации не зависели от автоматического подбора настроек JVM.
2.1. Время отклика p99: сравнение Composite‑Net и Distributed
На рисунке 1 виден существенный разрыв (примерно в 2–3 раза) между Composite‑Net и Distributed для трёх сборщиков мусора, характеризующихся заметными паузами GC.
ZGC, у которого продолжительность пауз составляет менее 1 мс, подобного расхождения не демонстрирует. Для сравнения: у G1 целевое время паузы по умолчанию составляет 200 мс.
Это подтверждает гипотезу о том, что в режиме Composite планирование запросов становится невозможным, если всё приложение заблокировано на время паузы сборщика мусора.
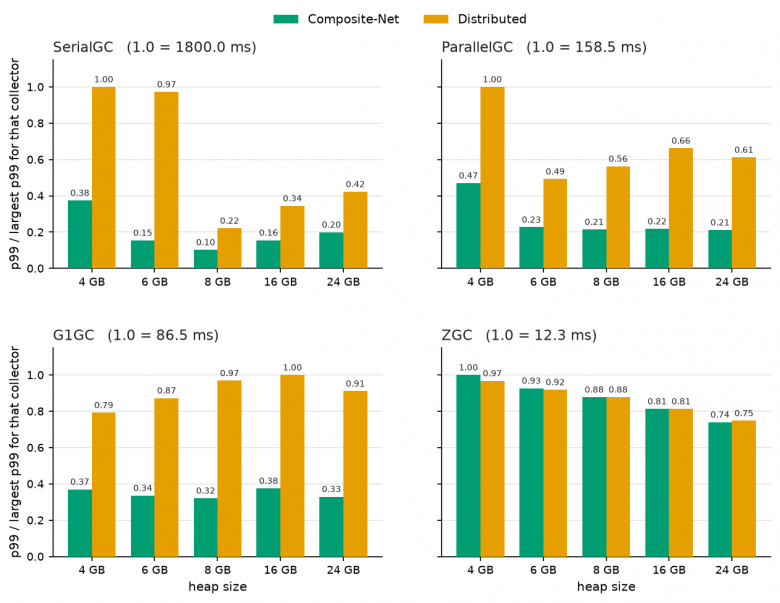
Нормализованное наблюдаемое время отклика p99 (интервал между запланированной отправкой запроса и получением ответа). Интенсивность нагрузки установлена на уровне 6000 запросов в секунду. Результаты и конфигурации не соответствуют правилам официального тестирования.
Стоит также обратить внимание на абсолютные значения — см. рисунок 2. С точки зрения соглашения об уровне обслуживания (SLA) разница между временем отклика 34 мс и 100 мс огромна.
Для сборщика Serial при размере кучи 6 ГБ разница между 1750 мс и 278 мс оказывается ещё на порядок значительнее.
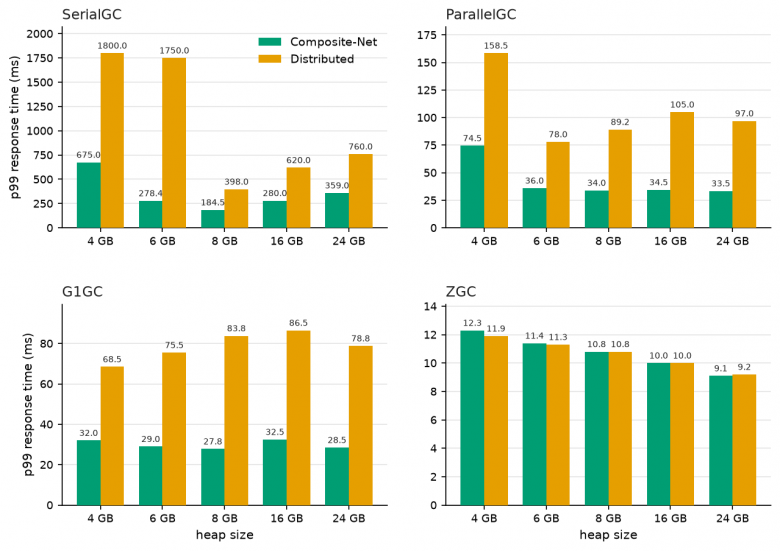
Наблюдаемое время отклика p99. Интенсивность нагрузки установлена на уровне 6000 запросов в секунду. Результаты и конфигурации не соответствуют правилам официального тестирования.
2.2. Объяснение расхождений
Мы выгрузили временные метки запланированной отправки, фактической отправки и получения ответа для всех запросов. Сопоставив их с журналами GC, можно построить графики, показывающие время отклика относительно паузы сборщика мусора.
Для этого мы выбрали Parallel GC с кучей объёмом 16 ГБ и паузы GC примерно одинаковой продолжительности в обоих режимах.
На рисунке 3 по оси X отложено запланированное время отправки запроса, а по оси Y — время отклика.
В режиме Distributed показанная пауза GC происходит в серверной части. При этом генератор нагрузки располагает значительным объёмом памяти, а активность сборщика мусора в нём практически отсутствует.
Очевидно, что в режиме Composite‑Net во время паузы GC новые запросы не планируются. Именно этим объясняется существенное расхождение результатов, наблюдаемое на рисунках 1 и 2.
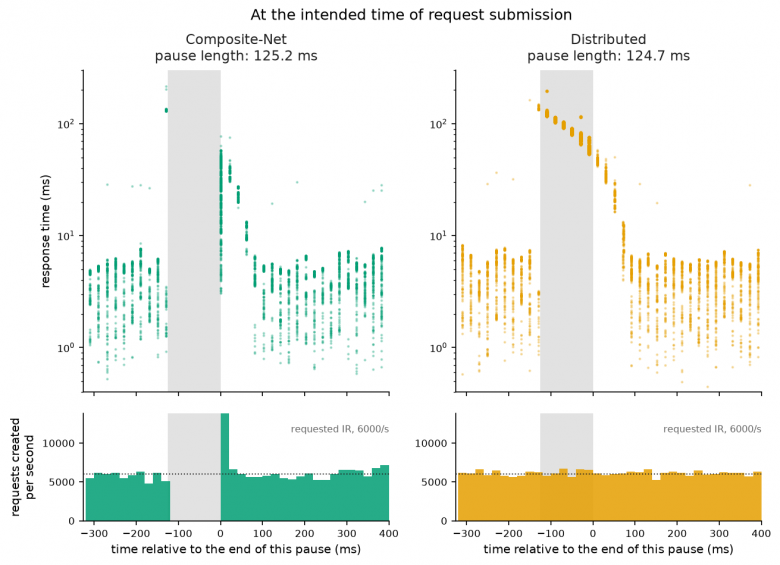
На примере Parallel GC с кучей объёмом 16 ГБ отчётливо видно, что во время паузы сборщика мусора в режиме Composite‑Net планирование новых запросов невозможно. Серая полоса обозначает продолжительность паузы GC.
График для режима Distributed показывает, что пауза GC в серверной части не мешает генератору нагрузки планировать запросы. Запросам с большим временем отклика, отправленным до начала паузы GC, пришлось дождаться её полного завершения, прежде чем ответы могли быть получены.
Результаты и конфигурации не соответствуют правилам официального тестирования.
Стоит также подчеркнуть, что всё наблюдаемое здесь различие обусловлено исключительно невозможностью планировать запросы.
На рисунке 4 показано фактическое время отправки запросов. Поскольку серверная часть занята сборкой мусора, а генератор не может отправить следующий запрос до получения ответа на предыдущий, становится очевидно, что использование запланированного, а не фактического времени отправки для расчёта времени отклика — правильное решение.
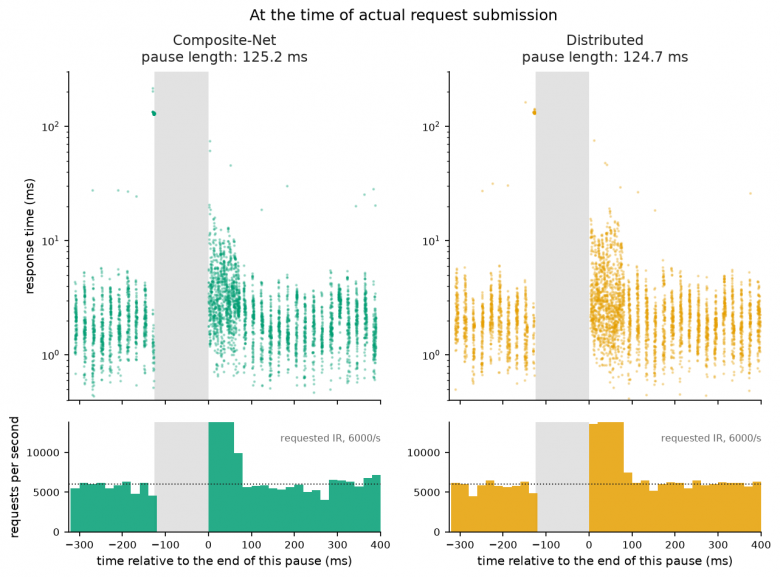
Генератор нагрузки, использующий блокирующие вызовы, должен фиксировать запланированное время отправки запросов, иначе результаты измерений будут некорректно искажены.
Поскольку серверная часть выполняет сборку мусора, все рабочие потоки генератора нагрузки заблокированы и не могут отправлять новые запросы. В результате все фактические моменты отправки смещаются на время после завершения паузы.
Такая модель не соответствует действительности. Клиенты не прекращают отправлять запросы только потому, что в вашей системе происходит пауза сборщика мусора.
Результаты и конфигурации не соответствуют правилам официального тестирования.
3. Подведение итогов
SPECjbb2015 уже предоставляет режимы тестирования для пользователей, которым особенно важно измерять задержки.
Режимы MultiJVM и Distributed позволяют запускать генератор нагрузки в отдельной JVM, причём перейти на один из этих режимов достаточно просто.
Мы рекомендуем всем, кто заинтересован в точном измерении задержек, использовать исключительно Distributed и MultiJVM. Это упрощает анализ результатов и позволяет точнее соотносить абсолютные значения времени отклика с показателями реальных систем, с которыми взаимодействуют конечные пользователи.

Присоединяйтесь к русскоязычному сообществу разработчиков на Spring Boot в телеграм — Spring АйО, чтобы быть в курсе последних новостей из мира разработки на Spring Boot и всего, что с ним связано.