

То, что вы сейчас прочитаете, — полный бред, во всяком случае с точки зрения физики. Но меня это не особенно беспокоит. Теория не обязана быть абсолютной истиной. Важно, чтобы она согласовывалась с наблюдениями, позволяла делать предсказания и выдерживала проверку экспериментом. Моя теория никаких научных проверок пока не проходила, зато удивительно хорошо объясняет то, что я регулярно наблюдаю при работе с искусственным интеллектом.
А началось всё с обычного сайта, нескольких заголовков и моего наивного предположения, что если исполнителю что-то запретить, он не станет этого делать.
Куда делись заголовки?
Работаю над сайтом с помощью ИИ-агента. Меняю структуру, оттачиваю тексты, исправляю недочёты. В файле AGENTS.md подробно прописано, что агенту разрешается делать, а чего категорически нельзя. Некоторые запреты повторены по нескольку раз. Не потому, что я особенно люблю повторяться, а потому, что жизнь уже научила. Скоро, наверное, начну заверять этот файл у нотариуса.
Особенно это касается HTML-разметки. Если я попросил изменить текст, совершенно незачем заодно переставлять заголовки, менять их уровни или переделывать структуру документа. Агент соглашается, принимает задачу и через некоторое время сообщает: «Готово». Открываю страницу, проверяю нужный блок. Всё замечательно, именно так, как я хотел.
Проходит пара дней. Возвращаюсь к странице по другому поводу и случайно обнаруживаю, что структура заголовков изменилась. Где-то поменялись уровни, где-то заголовок оказался совсем не там, где должен быть. Причём внешне страница выглядит совершенно нормально: дизайн на месте, тексты на месте, ничего не съехало. Только HTML рассказывает другую историю.
Спрашиваю агента: «Какого чёрта ты это сделал? Кто разрешил?» А получаю ответ на совершенно другой вопрос — обстоятельное объяснение про семантику, доступность и правильную иерархию заголовков. Я, конечно, рад его глубоким познаниям в HTML, но спрашивал-то о другом. Почему он нарушил прямой запрет?
И тут мне пришла в голову странная мысль: он действительно не знает почему. Не забыл, не скрывает, не пытается выкрутиться. У него просто нет такого свойства — знать причину собственного выбора в том смысле, в каком я ожидаю этого от человека.
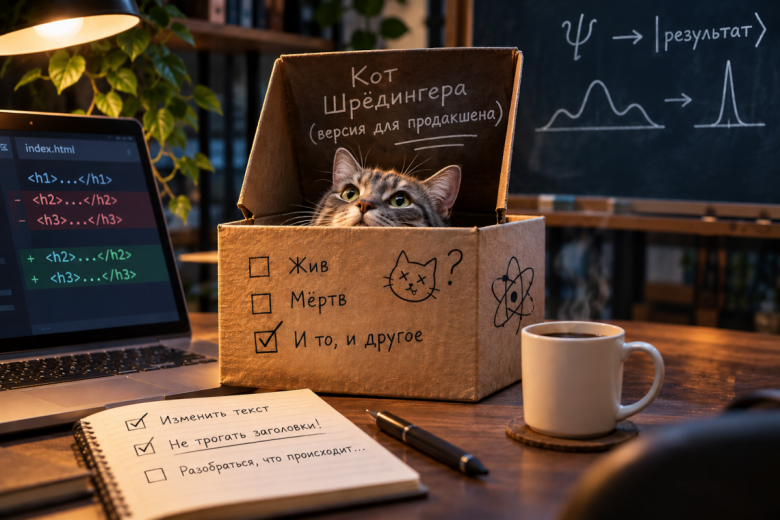
И тут я вспомнил квантовую механику. Казалось бы, где HTML-заголовки, а где квантовая физика? Но потерпите, сейчас мы доберёмся и до кота Шрёдингера.
Немного квантового безобразия
В квантовой механике существует понятие волновой функции. Если сильно упростить, она описывает состояние квантовой системы и позволяет вычислять вероятности различных результатов измерения. Причём система может находиться в суперпозиции множества состояний. Для некоторых физических величин это множество бесконечно.
Представьте, что мы пытаемся определить положение электрона. До измерения оно описывается не одной заранее известной нам точкой, а волновой функцией, связанной с распределением вероятностей. Но стоит провести измерение, и мы обнаруживаем электрон в конкретном месте. В одной из распространённых интерпретаций говорят, что волновая функция схлопнулась. Из множества возможных результатов мы наблюдаем один.
Красиво, правда? Особенно если не задавать физикам лишних вопросов о том, что именно произошло при измерении. Они спорят об этом уже около ста лет, так что я со своими заголовками HTML, пожалуй, воздержусь от участия.
А теперь посмотрите на языковую модель. Когда я задаю ей вопрос, ответа как такового нет. Он возникает в процессе генерации. Не существует где-то внутри нейросети готового текста, который она собирается мне показать. Модель последовательно формирует ответ, токен за токеном. Каждый выбранный фрагмент влияет на следующие, и из множества возможных продолжений возникает один конкретный текст.
А если вместо разговора модель управляет инструментами? Открывает файлы, меняет шаблоны, выполняет команды? Тогда возможных последовательностей действий тоже множество. Одна из них реализуется, и агент сообщает: «Готово».
Я открываю сайт и наблюдаю результат. В моей аналогии волновая функция схлопнулась: из множества возможных вариантов реализовался один. Правда, проверил я только тот участок страницы, где ожидал изменений. Всё прекрасно, кот жив, можно закрывать коробку.
А через три дня заглядываю в HTML и обнаруживаю, что кот не только жив, но ещё и самостоятельно переставил мебель. HTML, конечно, не изменился от моего взгляда. Всё произошло раньше. Но эта странная аналогия привела меня к вопросу гораздо интереснее первоначального.
А какого цвета электрон?
Давайте проведём мысленный эксперимент. Представьте, что вы подходите к физику и спрашиваете: «Скажите, а электрон синий или зелёный?» Физик, скорее всего, посмотрит на вас как на идиота. И будет по-своему прав.
У электрона нет свойства обладать каким-либо цветом. Не потому, что он слишком маленький или мы ещё не изобрели достаточно хороший микроскоп. У него просто нет такого свойства «быть какого-то цвета». Можно повторить вопрос тысячу раз, но электрон от этого не покраснеет. Даже от стыда.
А теперь представим, что электрон научился разговаривать. Вы спрашиваете его, какого он цвета, а он начинает обстоятельно объяснять преимущества зелёного. Приводит аргументы, рассуждает об особенностях спектра, ссылается на исследования. Через пять минут вы уже обсуждаете оттенки, совершенно забыв, что исходный вопрос не имел смысла.
Улавливаете, к чему я клоню?
Когда я спрашиваю искусственный интеллект «почему ты так сделал?», то предполагаю, что сначала у него возникло намерение, потом он принял решение, а теперь может вспомнить, какими соображениями руководствовался. Но с чего я вообще взял, что он обладает таким свойством?
У электрона нет свойства обладать цветом. А у искусственного интеллекта нет свойства знать, почему он поступил именно так. У него нет свойства «почему». Но, в отличие от электрона, искусственный интеллект способен убедительно объяснить то, чего не знает.
И вот здесь возникает довольно неприятная мысль: возможно, вопрос «почему ты так сделал?» — самый глупый вопрос, который можно задать искусственному интеллекту.
У действий модели существуют причины: вычисления, контекст, инструкции, результаты предыдущих операций. Но наличие причин вовсе не означает, что система способна достоверно вспомнить и объяснить собственный выбор. Мы приписываем ей человеческое свойство, а затем требуем его продемонстрировать. И самое замечательное — она всё равно нам ответит!
Второй коллапс
Вот теперь смотрите внимательно. Мы подошли к самой интересной части нашего эксперимента.
Агент изменил страницу. Я обнаружил неожиданное изменение и потребовал объяснений. Он рассказал, что стремился улучшить структуру документа, соблюсти семантику HTML и вообще сделать всё правильно. Объяснение получилось настолько убедительным, что впору самому извиниться за то, что мешал ему работать.
Но подождите. Откуда вообще взялось это объяснение?
Оно появилось после моего вопроса! До этого модель сформировала последовательность действий, а теперь сформировала рассказ о них. Причём рассказ может опираться на историю команд и действительно отражать причины выбора, а может оказаться вполне правдоподобной реконструкцией, которой раньше не существовало.
Посмотрите, какой замечательный фокус получается. Первое схлопывание создаёт результат. Второе создаёт его историю.
Я спрашиваю о прошлом, а получаю только что созданный рассказ о прошлом. И почему-то автоматически предполагаю, что именно эта история определила первоначальное действие.
Представьте, что электрон после измерения начинает объяснять, почему оказался именно здесь. Он тщательно изучил обстановку, рассмотрел несколько вариантов, оценил перспективы и решил, что здесь будет лучше. Возможно, даже составил сравнительную таблицу. Отличное объяснение. Жаль только, что электрон ничего подобного не планировал.
И вот здесь я наконец понял, что меня так смущало в разговорах с ИИ. Я просил объяснить действие, предполагая, что объяснение уже существует и его достаточно вспомнить. А получал новый результат работы той же самой системы.
Искусственный интеллект — это волновая функция, которая научилась оправдываться.
Полагаю, на этом месте физики окончательно потеряли ко мне уважение. Зато мне самому стало гораздо интереснее.
А кто здесь наблюдатель?
Давайте проведём последний эксперимент. Я спрашиваю агента, почему он изменил заголовки. Он объясняет, что так правильно. Показываю первоначальный запрет — агент признаёт, что неправильно интерпретировал ограничения. Ещё немного поспорим, и, вероятно, появится третье объяснение. Какое из них настоящее? Первое, второе, третье? Или мы наблюдаем, как система создаёт всё новые версии прошлого в зависимости от того, что именно у неё спрашивают?
И вот парадокс: я задаю вопрос «почему?», рассчитывая узнать причину, а сам вопрос может вызывать появление объяснения, которого раньше не существовало. Затем я принимаю это объяснение за доказательство того, что причина была именно такой.
А теперь посмотрите, что произошло со мной. Я начал с нескольких заголовков HTML, хотел разобраться, почему агент нарушает инструкции, а вместо этого добрался до квантовой механики и построил целую теорию. Причём могу очень убедительно объяснить, почему она возникла и как замечательно описывает происходящее.
Постойте. Но ведь именно за это я и ругал искусственный интеллект! Он сделал что-то неожиданное, а потом убедительно объяснил, почему так получилось. Я тоже получил совершенно неожиданный результат и теперь с удовольствием его обосновываю.
Получается, я пытаюсь доказать, что искусственный интеллект придумывает объяснения задним числом, и для этого сам придумал объяснение задним числом.
И вот теперь возникает действительно неприятный вопрос. Если моя теория верна, насколько можно доверять моему собственному рассказу о том, как я к ней пришёл?
Кажется, мы только что обнаружили третий коллапс. На этот раз — моего здравого смысла.
Комментарии (16)

Apoheliy
02.11.2026 08:15Если моя теория верна, насколько можно доверять моему собственному рассказу о том, как я к ней пришёл?
Фух, ну здесь всё просто.
Казань брал?Делал?:Спрашиваю агента: «Какого чёрта ты это сделал? Кто разрешил?»
Делал! Т.е. у тебя было НАМЕРЕНИЕ! А посему напрашиваются два вывода:
твой мозг работает в человеческом стиле;
ты сам виноват в том, что получил такой результат. Вина доказана, статью сам подберёшь (или попроси знакомого адвоката)!
---
Прим: простите за фамильярность текста, но это явно напрашивалось.

rumataestor Автор
02.11.2026 08:15Вину признаю, от адвоката пока отказываюсь. :)
Но ведь самое интересное, что человек тоже прекрасно умеет придумывать объяснения собственным поступкам задним числом. И далеко не всегда понимает, почему действительно поступил именно так.
Так что теперь у меня появились сомнения не только в искусственном интеллекте, но и в собственном. Кажется, третий коллапс всё-таки состоялся.

helg1978
02.11.2026 08:15Представьте что вам дали мешок, в который насыпали 10000 открытых коробок с пазлами и просят сложить 1 квадратный пазл из секций котрые голубоватые, и не очень тревожные.
Вы складываете такие кусочки, опираясь на свои ассоциации. На рисунке получилась желтая надпись "хрен" на голубом фоне.
И вас спрашивают "а чего ты ругаешься, зачем ты это сделал"?
rumataestor Автор
02.11.2026 08:15Вот именно! А самое интересное начнётся, когда вы спросите, почему получилось слово «хрен». И сборщик пазла обстоятельно объяснит, что именно это слово лучше всего соответствует голубому фону и вашему эмоциональному состоянию. И ведь убедит, зараза!

PoksPoks
02.11.2026 08:15Реально бессмысленно задавать вопрос о причинах генеративной модели, так как у нее нет механизма внутреннего логирования принятых решений. Каждый новый запрос просто запускает процесс выдачи текста с чистого листа на основе текущего промпта
Если агент в процессе работы теряет первоначальные инструкции из-за переполнения контекста, никакие запреты не помогут удержать нужную разметку на сайте
Человеческий мозг тоже отлично придумывает оправдания собственным глупым поступкам задним числом, просто от машины мы подсознательно ждем строгой логики и абсолютной честности

ivanstor
02.11.2026 08:15Забавно наблюдать, как вокруг ИИ формируется своя эзотерическая мифология. Особенно, если вспомнить, что свойства "цвет" нет не только у электрона, но и у фотона. У фотона есть длина волны или частота. Цвет есть в голове у человека. У пчелы другой...

Ka463
Тут все несколько проще, и нет не какого кота.
Ваш кодовый агент просто теряет историю, все ваши правила смещаются вместе с ростом контекста в окне, и в какой то момент попадают в слепую зону, а потом вообще уходят через суммаризацию, и агент их не перечитывает, пока вы не начнете новую сессию или явно об этом ему не скажите.
Отсюда и деградация....
rumataestor Автор
С деградацией контекста согласен, это вполне возможное объяснение. Но меня заинтересовало немного другое.
Допустим, мы выяснили, почему агент нарушил инструкцию. А теперь спрашиваем его самого: «Почему ты это сделал?» И он выдаёт совершенно убедительное объяснение, которое вовсе не обязательно связано с действительной причиной.
Вот об этом, собственно, и статья. Не о том, почему агент ошибается, а о том, насколько можно доверять его объяснениям собственных ошибок.
А кот, конечно, ни при чём. Он вообще-то просто сидел в коробке, ни жив, ни мёртв, пока его не втянули в эту историю.
Ka463
Смотрите, когда вы спрашиваете агента, он вам что то должен обязательно ответить, если у него нет памяти из которой он может проследить свои же действия и решения, (нет ответа от среды), то он начнет выдумывать.
Принцип простой, нет ответа среды = гарантированные галлюцинации.
rumataestor Автор
Но ведь есть замечательный ответ: «Я не знаю». И иногда я действительно получаю его от ИИ.
Проблема в том, что на основании убедительного, но недостоверного объяснения я могу сделать неправильные выводы и начать что-то исправлять. В результате одно ошибочное решение порождает следующее. И вот это уже гораздо опаснее первоначальной ошибки.
Ka463
А вот тут есть фокус, если у вас явно прописано в настройках промта, что бы агент не выдумывал, то это работает так же как и все остальное, пока не замылится и не уедет из фокуса окна, по этому вы и получаете иногда "я незнаю".
Если не прописано, то тут вообще все на усмотрение модели и как ее обучающий корпус совпадает с теми задачами и моментами когда модель знает что можно сказать "я незнаю".
Так же сильно зависит от формулировки, и в каком контексте позже был задан вопрос, доступные инструменты, заполненность окна и т.д.
Именно по этому вы получаете не линейное поведение.
rumataestor Автор
Да, именно об этом я и говорю. Просто немного с юмором. Поведение модели зависит от множества факторов, которые мы не всегда можем проследить. И даже если все инструкции сохранились в контексте, это ещё не гарантирует их выполнения.
Ka463
Ну, самое простое, поменять своего агента, выбрать что то что обеспечивает долговременную память, а не только суммаризацию, и поведение агента значительно улучшиться по предсказуемости