Всем привет! Эта статья является третьей в серии статей про основы глубокого обучения. В прошлых двух частях я рассказал много интересного и полезного новичкам, так что рекомендую перечитать.
В этой части мы разберём подробнее задачи связанные с обработкой естественного языка (NLP) и реализуем двухслойную нейронную сеть классификации текста.
Разберём, что подразумевает под собой область ИИ под названием обработка естественного языка
Какие задачи решает NLP?
Эта область посвящена автоматизированному изучению человеческого языка (не обязательно с использованием именно глубокого обучения).
Вот несколько видов задач, которые решают с помощью NLP:
определение начала и конца слов по символам, предложений и словосочетаний по словам, а также начало и конец именованных сущностей (людей, городов и тд) по словам в предложении;
определение части речи каждого слова в предложении;
определение человека/места/предмета, к которому относятся местоимения, по предположениям в документе;
определение эмоциональной окраски предложения по словам в нём;
машинный перевод;
классификация текста;
восполнение отсутствующей информации по контексту;
обработка и генерация связного текста, похожего на человеческий.
Очевидно, что сам процесс обучения нейронной сети для решения какой-то из перечисленных задач особо не поменяется концептуально. Нам лишь нужно придумать, как преобразовать входной текст в числа, ведь именно с числами работает сеть.
Нужно выбрать такой способ преобразования, чтобы сеть могла эффективно извлечь функцию, которая будет максимально точно выражать отношение между входными и выходными данными.
Для выбора конкретного способа представления входных данных, который сделает корреляцию между входом и выходом наиболее очевидной для сети, нужно посмотреть на входной и выходной набор данных.
В качестве примера я возьму популярную задачу классификации темы.
Рассмотрим задачу классификации отзыва для определения эмоциональной окраски
Я буду использовать набор данных кинопоиска с отзывами на фильмы. Этот набор — это коллекция из 36591 пар "текст отзыва : рейтинг" (если опустить ненужные нам поля). Получить датасет можно по-разному, например, скачать файл вручную или как я с помощью библиотеки Hagging Face. Также можете обучать модели на датасете IMDb, он есть в keras.datasets, но он английский.
Мы должны будем обучить нейронную сеть определять по входному тексту отзыва его выходной рейтинг (1/0 или позитивный/негативный). Для упрощения из датасета убраны отзывы с нейтралиным рейтингом. А также, чтобы не было перекоса выбраны и перемешаны по 10000 положительных и отрицательных отзывов.
Тут сразу выберем размер токена (минимальная единица текста, которую нейронная сеть воспринимает). Хорошей идеей в качестве токена выбрать слово, так как некоторые слова хорошо коррелируют с эмоциональной окраской текста (хороший, плохой, понравился, ненавижу). На первом этапе контекст слов учитывать не будем для простоты.
Так как нейронная сеть у нас является параметрической моделью (то есть имеет фиксированное количество весов, нейронов и как в следствии фиксированный размер входного слоя), то самым простым преобразованием входного текста будет составление словаря из всех возможных слов из отзывов и преобразование входного текста в вектор, где единицы будут стоять на тех местах, которые соотносятся с конкретным словом в словаре.
То есть пусть в словаре 5 слов (например, первое слово «плохой» и ему соответствует вектор [1,0,0,0,0]), и наш входной текст содержит 1,3,4 слово из этого словаря, тогда входной текст преобразуем в [1,0,1,1,0]. Эта форма хранения уже использовалась нами в прошлых частях и называется прямым кодированием (one-hot encoding).
Также в случае если входной текст содержит несколько раз одно и тоже слово из словаря, то мы можем либо несколько раз сложить вектор для этого слова, либо прибавить его всего один раз. Второй способ обычно предпочтительнее.
Опираться будем при написании новой нейронной сети на нашу двухслойную нейронную сеть из прошлых частей. Которая имела 100 нейронов в скрытом слое и 1 в выходном.
Первым делом мы скачаем нужный датасет и приведём его к более удобному виду. Далее разобьём каждый отзыв на токены (в нашем случае это слова) и получим список из множеств слов каждого отзыва.
После этого составим словарь всех слов и дадим им их собственный индекс (идентификатор), ключ — слово, а значение — идентификатор. По сути этот идентификатор просто более компактный способ хранения вектора one-hot encoding. Мы записываем не весь вектор, а индекс, где должна стоять единица.
Далее создадим список отзывов (точнее список, где элементами являются списки с идентификаторами слов этого отзыва), которые мы будем непосредственно подавать в модель. Также список рейтинга переведём из слов в цифры.
import numpy as np
np.random.seed(1)
from datasets import load_dataset
import pandas as pd
import re

dataset = load_dataset("blinoff/kinopoisk")
df = pd.DataFrame(dataset["train"])
df = df[df["grade3"].isin(["Good", "Bad"])]

df_good = df[df["grade3"] == "Good"].head(10000)
df_bad = df[df["grade3"] == "Bad"].head(10000)
df = pd.concat([df_good, df_bad]).sample(frac=1, random_state=1).reset_index(drop=True)

def clean(text):
    text = text.replace("\n", " ").replace("\xa0", " ").lower()
    text = re.sub(r"[^а-яa-z\s]", "", text)
    text = re.sub(r"\s+", " ", text)
    return text.strip()

raw_reviews = list(map(clean, df["content"].head(20000).tolist()))#список с отзывами
raw_labels = df["grade3"].head(20000).tolist()
tokens = list(map(lambda x: set(x.split(" ")), raw_reviews))

vocab = set()
for sent in tokens:
    for word in sent:
        if len(word) > 0: vocab.add(word)
vocab = list(vocab) #пока создадим просто список всех слов без повторений

word2index = {} #а это уже будет наш словарь
for i, word in enumerate(vocab):
    word2index[word] = i

input_dataset = list() #входные данные для модели
for sent in tokens:
    sent_indices = list()
    for word in sent:
        sent_indices.append(word2index[word])
    input_dataset.append(list(set(sent_indices)))

target_dataset = list() #переведём рейтинг в цифры
for label in raw_labels:
    if label == "Good": target_dataset.append(1)
    else: target_dataset.append(0)
Теперь перейдём к непосредственно обучению модели. Но тут стоит заметить ценную вещь, так как у нас входной отзыв по сути длинный вектор, где единицы стоят только на некоторых местах, соответствующих словам, то при прямом распространении нам можно не перемножать матрицу входную на матрицу весов, вместо этого мы можем сложить лишь те строки в матрице весов, которые соответствуют индексам наших слов. Чтобы проверить это просто перемножьте вектор из единиц и нулей на матрицу и сравните.
Этот процесс выбора строк и их суммирование (или усреднение) определяет первый линейный слой (до применения к взвешанной сумме функции активации) как слой векторного представления (слой Embedding). Концепция преобразования данных в векторный формат часто называется вложением (эмбеддингом). Используя первый слой сети (как мы сейчас и как работает в GPT) или другую предварительно обученную модель такой сети, можно осуществить вложение различных типов данных. Для разных данных входных требуются разные модели вложения.
Ещё раз, по сути, вложение представляет собой преобразование дискретных объектов в точки на непрерывном векторном пространстве. То есть сначала мы просто подготовили данные, переведя их в удобный формат для вычислений (прямое кодировние), а станут они векторным представлением слов только после сложения нужных строк матрицы весов (после слоя векторного представления). Более подробно рассмотрим это в следующих частях, когда дойдём до GPT-подобных моделей.
Теперь приступим к коду, для упращения будем использовать стохастический градиентный спуск, но потеряем во времени обучения. Оператор индексирования для матрицы возвращает те строки, номера которых мы передали (если передали вектор [1,3,5], то получим матрицу из трёх этих строк). Прямое распространение не должно вызвать вопросов.
def sigmoid(x):
    return 1/(1+ np.exp(-x))

alpha, iterations, hidden_size = (0.01, 2, 100)
weights_1 = 0.2*np.random.random((len(vocab), hidden_size)) - 0.1
weights_2 = 0.2*np.random.random((hidden_size, 1)) - 0.1

correct, total = (0,0)
for j in range(iterations):
    for i in range(len(input_dataset) - 1000): #обучаем на первых 19000 отзывах
        x, y = (input_dataset[i], target_dataset[i])
        layer_1 = sigmoid(np.sum(weights_1[x], axis=0))
        layer_2 = sigmoid(np.dot(layer_1, weights_2))
        layer_2_delta = layer_2 - y
        layer_1_delta = layer_2_delta.dot(weights_2.T)*layer_1*(1-layer_1)
        weights_1[x] -= alpha*layer_1_delta #эта операция удобно вычтет градиент ошибки от нужных весов
        weights_2 -= alpha*np.outer(layer_1, layer_2_delta)

        if(np.abs(layer_2_delta) < 0.5):
            correct +=1
        total +=1
        if (i%10 == 9): print(f"Iter: {j}-{i} Progress: {100*(i+1)/(len(input_dataset) - 1000):.4f}% TrainingAcc: {100*correct/float(total):.4f}%")

print("\nТестируем")
#протестируем на 1000 отложенных образцов
correct, total = (0,0)
for i in range(len(input_dataset)-1000, len(input_dataset)):
    x, y = (input_dataset[i], target_dataset[i])
    layer_1 = sigmoid(np.sum(weights_1[x], axis=0))
    layer_2 = sigmoid(np.dot(layer_1, weights_2))
    if(np.abs(layer_2-y) < 0.5): correct +=1
    total +=1
print(f"TestAcc: {100*correct / total:.4f}%")
Переходим к обратному распространению. Важно, что тут мы используем не перекрёстную энторпию в качестве способа подсчёта ошибки, а бинарную перекрёстную энтропию. Благодаря этому у нас та же ситация, что и с производной перекрёстной к softmax. Производная бинарной перекрёстной энтропии к входу sigmoid (то есть к взвешанной сумме, подающейся на вход функции активации) равна результат модели минус истина.
Поэтому дельта выходного слоя это просто результат минус истина. При подсчёте дельты первого слоя мы умножаем число (матрица из одного элемента, но по сути то же самое, что и умножение числа) на вектор весов. Не забываем множить на производную выхода нейрона к взвешанной сумме (sigmoid'(x) = sigmoid(x)*(1 - sigmoid(x)) ).
Обновляем веса первого слоя используя удобную операцию индексирования, которая вычтет градиент из нужных строк (исходная матрица тоже изменится в этих строках, так как они ссылаются на одинаковые строки в памяти). Вычитаем так просто градиент без умножения на входные данные, потому что входные данные имеют только 1 и 0, следовательно умножение на единицу ничего не меняет, а вместо умножения на 0 мы просто не трогаем эти строки.
Веса второго слоя обновляем просто через np.outer(), который перемножит каждый элемент первой матрицы на каждый элемент второй матрицы и положит их по строчно согласно количеству элементов левой матрицы (то есть левую матрицу разложит в стобец, а правую в строку и перемножит сначала первый элемент левой на все правой по одному и тд). В итоге мы получаем вектор столбец.
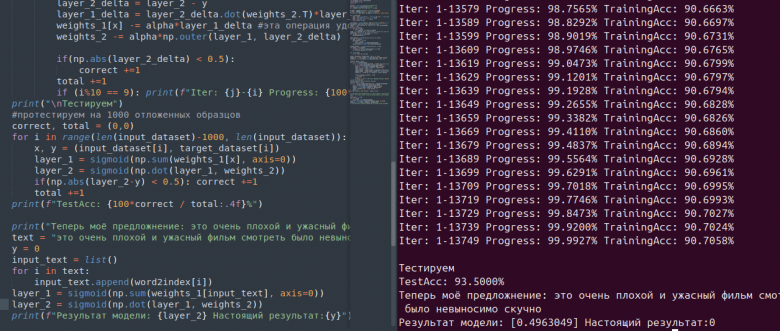
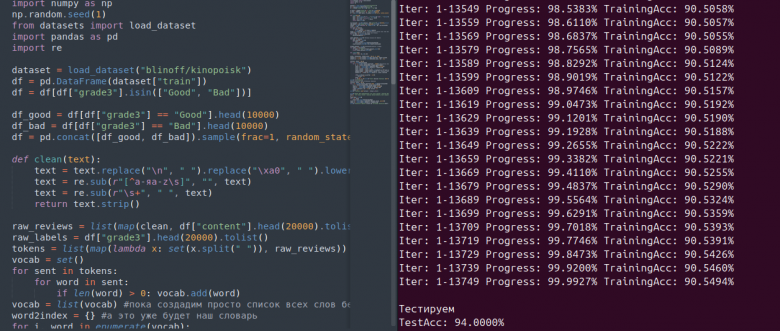
В конце проводим подсчёт правильно отгаданных отзывов и тестируем модель на 1000 отложенных образцах. В итоге модель достигла 94% точности на тестовой выборке.
Но мне этого мало давайте напишем своё предложение и посмотрим определит ли модель его верно.
print("Теперь моё предложнение: это очень плохой и ужасный фильм смотреть было невыносимо скучно")
text = "это очень плохой и ужасный фильм смотреть было невыносимо скучно".split()
y = 0
input_text = list()
for i in text:
    input_text.append(word2index[i])
layer_1 = sigmoid(np.sum(weights_1[input_text], axis=0))
layer_2 = sigmoid(np.dot(layer_1, weights_2))
print(f"Результат модели: {layer_2} Настоящий результат:{y}")
В итоге она смогла отгадать, но к сожалению, это было на краю уже, а всё это только потому, что в датасете кинопоиска всего на самом деле 4751 плохих отзывов, а остальные хорошие в итоге перекос остался в сторону хороших отзывов и обучили мы не на 20000 отзывов, а на 14751 (10000 хороших и 4751 плохих).