

Автор оригинала: Scott Cooper
Последние несколько недель я с помощью кодинг-агента искал и чинил проблемы с производительностью бэкенда Sentry. Отправной точкой служили трейсы, которые Sentry отправляет сам себе.
Большинство правок меняли строку-две. Но вместе они убрали сотни миллионов запросов в неделю, а некоторые дорогие выборки ускорились в сотни и тысячи раз (подробности ниже).
Как я направил агента на наши трейсы
Я подключил агента (в данном случае Claude с Opus 5.5) к Sentry MCP, указал ему нашу организацию и проект в Sentry и попросил найти проблемы на горячих путях, похожие на небольшой PR про производительность, который я подготовил сам:
поищи через sentry mcp ещё похожие быстрые победы вокруг проблем на горячих путях
По моему опыту, с последними несколькими релизами моделей уже не нужно так тщательно выстраивать промпт или контролировать контекст агента (например, подсовывать ему конкретные спаны). Начать можно с такого общего запроса:
Найди все критические пути в моём приложении. Через Sentry MCP найди их трейсы и способы их оптимизировать.
После моего первого промпта агент отсортировал спаны по тому, как часто они выполнялись и сколько длились. Для каждого кандидата он давал файл и строку, оценку недельного объёма и ссылку на пример трейса. Когда список редел, я направлял его в новое место. Промпты были короткими и в основном сводились к вопросам вроде этих:
«поищи проблемы с большой нагрузкой на базу»
«это изменение чем-нибудь рискованно?»
«ты проверил новый запрос через EXPLAIN, как мы делали раньше?»
«rpc тоже может быть интересен»
«кажется, тут есть чей-то PR, который уже может это чинить»
«давай не будем трогать эту часть»
Затем я выбирал проблему и просил агента разобраться глубже, прежде чем что-либо менять. Он читал код и историю git и рассказывал, что может сломаться. Если исправление выдерживало проверку, он открывал черновик PR.
Кодовая база Sentry большая, и есть области, которые я знаю недостаточно хорошо, чтобы уверенно их менять. Я уводил агента от таких мест, проверял, не идёт ли там уже работа, и продолжал искать что-нибудь поменьше. Результаты становятся намного лучше, если агент может проверять изменения на базе в режиме только для чтения, а не гадать.
Инструментация Django SDK как отправная точка
Значительная часть кода Sentry написана на Django, и автоматическая инструментация Sentry Django SDK дала нам хорошую основу:
В описании спанов запросов Django лежит сам SQL. Кроме того, в наши трейсы попадают обращения к кэшу, RPC между силосами, задачи и маршруты API. Группировка спанов по описанию позволила агенту превратить данные трейсов в ранжированный список дорогой работы.
Если у спана базы данных были атрибуты источника запроса, они давали агенту файл и строку, откуда запрос выполнялся.
Атрибут
user_agentпоказал, что один нагруженный эндпоинт в основном дёргаетsentry-cli set-commits --auto, постранично проходя по репозиториям организации при каждой сборке. У одной организации было около 16 тысяч репозиториев, и делала она это примерно каждые 40 секунд. Отсюда появились правка в CLI, которая избегает постраничного обхода, и индекс на сервере, удешевляющий запросы для уже установленных версий CLI.Каждый PR ссылается на пример трейса с лишним запросом или вызовом, чтобы ревьюеру было немного проще разобраться. В одном трейсе вебхук дважды выполнял один и тот же запрос на 140 мс.
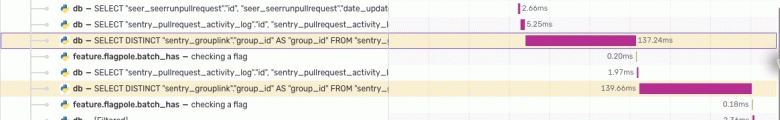
Результат удаления запроса в трейсе виден сразу. Чтобы понять, насколько это важно, я также смотрел в Sentry на задержку запросов и нагрузку на базу.
Проверка изменений в запросах
При изменениях в SQL агент запускал EXPLAIN ANALYZE до и после на зеркале базы, доступном только для чтения, и сравнивал результаты. Нагляднее всего получилось с выборкой из GroupHistory (GroupHistory хранит каждую смену статуса у issue). Запрос искал самую новую строку сразу по нескольким статусам, поэтому Postgres читал и сортировал все подходящие строки:
-- до
SELECT * FROM sentry_grouphistory
WHERE group_id = %s AND status IN (1, 2, 11, 12, 13)
ORDER BY date_added DESC LIMIT 1

-- после: по одной выборке на статус, максимум берём в Python
(SELECT date_added FROM sentry_grouphistory
 WHERE group_id = %s AND status = 1
 ORDER BY date_added DESC LIMIT 1)
UNION ALL ...
Для самой загруженной группы на зеркале время упало с 935 мс до 0,4 мс при прогретом кэше.
Прим. пер.: в описании PR условия замера другие. Для группы со 130 тысячами строк истории старый запрос занимал примерно 935 мс на холодном кэше и примерно 274 мс на прогретом, новый занял 0,4 мс. Оценка «в тысячи раз» из начала статьи держится на холодном замере. Группы для проверки выбирали среди худших: у обычных запрос и раньше занимал около 2 мс, а теперь укладывается в миллисекунду.
Там же точнее названа причина. Индекс (group, status, date_added) не умеет отдавать строки сразу нескольких статусов от новых к старым. У групп, которые постоянно переходят между resolved и regressed, таких строк десятки тысяч. Запрос при этом остаётся одним.
Результаты
Перед выполнением запроса при приёме события проверять, что у события есть нужное свойство. Этот UPDATE выполнялся примерно 10 тысяч раз в секунду на базе вложений в нашем регионе US, а теперь его практически нет. Число коммитов в этой базе упало примерно на 17%, а
link_event_to_user_reportв среднем ускорился с ~6 мс до ~2,5 мс.Переиспользовать уже загруженный проект и пропускать лишние выборки на двух горячих путях. Повторное использование проекта убрало, по оценке, около 143 млн лишних SELECT в неделю. Вместе две правки приёма occurrence снизили p50 у
save_issue_occurrenceс ~35 мс до ~30 мс, а p95 с ~95 мс до ~61 мс по сравнению с теми же часами предыдущего дня (правка выборки детекторов).Перестроить запрос к GroupHistory, чтобы эффективнее использовать существующий индекс при обновлении статуса issue. На этот запрос приходилось около 8% чтений с диска на основной базе в нашем регионе EU (Германия) и около 3% в регионе US, а теперь его чтения с диска упали почти до нуля. Смена статусов в консьюмере occurrence стала быстрее примерно на 30% в регионе US и на 13% в регионе EU по сравнению с тем же временем предыдущего дня.
Жадно загружать приложение и токен для запросов Sentry-приложений, чтобы не ходить за ними в базу позже. Два лишних SELECT сократились с ~1,9% объёма запросов к управляющей базе до ~0,16%. Это примерно на 29 млн запросов в день меньше. Правка присоединяет связанные объекты к двум запросам, которые мы и так выполняем.
Добавить недостающий индекс таблицы для постраничного вывода репозиториев. Только на этот постраничный запрос до выкатки приходилось около 1,6% времени выполнения запросов на основной базе в нашем регионе US. Среднее время выполнения в базе упало примерно на 69% (с 30 мс до 9,2 мс), а обращений к блокам в кэше на запрос стало примерно на 52% меньше. Стабильного ускорения самих запросов к API не появилось, но работы для базы стало меньше.
Вызывать
bulk_setодин раз вместо записи в кэш отдельно для каждого issue в результатах, чтобы сократить число обращений. Запись флага unhandled требовала отдельного обращения к кэшу на каждый issue, в измеренном примере это занимало около 51 мс. После объединения записей осталось одно обращение примерно на 1,2 мс.Обойти неудачный план Postgres для запроса в детекторах. На зеркале базы запрос для небольшого детектора ускорился со 180 мс до 0,2 мс при прогретом кэше.
Примечание. Объёмы запросов и суточная экономия — это оценки по сэмплированным спанам и наблюдаемому трафику. Я сравнивал работу базы в расчёте на запрос, чтобы изменения трафика нельзя было ошибочно принять за рост производительности.
Прим. пер.: по статистике GitHub размер перечисленных правок заметно различается: от +1/−3 строки у PR 127494 до +54/−22 у PR 127496.
Как попробовать на своём приложении
Агенту нужен доступ к вашим трейсам. Дальше попросите его найти проблемы с производительностью в приложении. Можно начать с общего запроса и спускаться к конкретным областям:
«Найди транзакции, где один и тот же запрос с разными параметрами выполняется в одном трейсе больше 10 раз (N+1)».
«Найди
SELECT *и широкие запросы на горячих путях, где используется всего несколько колонок».«Найди медленные запросы с
ORDER BY ... LIMIT, постраничным выводом черезOFFSETилиLIKE '%...', которые, скорее всего, не используют индекс».
Выберите проблему и попросите агента разобраться глубже, прежде чем что-либо менять. Пусть он прочитает код и историю git и оценит, что может сломаться. После этого пусть открывает PR.