

Количество данных в современном мире постоянно растет. При этом количество потребляемой, копируемой и генерируемой информации на сегодня увеличилось до 163–175 ЗБ. Это на 430% больше, чем было 10 лет назад.
Для хранения большого количества данных компании используют S3. Но как весь этот объем защитить, например, от случайной утечки в открытый доступ или потери из-за человеческого фактора? Об этом мы сейчас и поговорим.
S3 и классы хранения данных
В отличие от блочных и файловых систем хранения, данные в S3 находятся внутри бакета — корневого контейнера. Каждый элемент представляет собой отдельный объект с уникальным URL-адресом, доступный по протоколу HTTP/HTTPS через S3-совместимый API. Это решение дает определенную гибкость: можно создавать миллионы бакетов, хранить триллиарды объектов и использовать тысячи петабайт.
Такие возможности позволяют удобно хранить в больших объемах медиафайлы, резервные копии и архивы, датасеты для обучения и работы моделей и чувствительные корпоративные файлы. В зависимости от того, как часто происходит взаимодействие с данными, существуют разные классы хранения: горячий, стандартный, холодный и ледяной.
Горячий и стандартный классы хранения подходят для объектов, к которым пользователи обращаются часто. К таким относятся, например, датасеты для обучения ML/AI-моделей. В связи с режимом использования стоимость хранения у этих решений выше, а стоимость запросов, наоборот, ниже.
В холодном и ледяном стоимость хранения обычно ниже, а стоимость запроса выше. Такие хранилища подойдут для резервных копий, к которым пользователи редко обращаются.
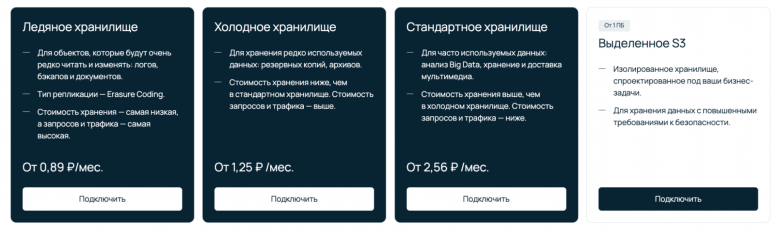
Отличительная особенность S3 Selectel в том, что в ледяном классе нет обязательного срока хранения. Вы можете воспользоваться им на неделю и удалить данные — при этом оплата будет списана не за год хранения, а за конкретное время использования. Сколько использовали, столько и заплатили.
Основные угрозы для данных в S3
Сегодня бизнес все чаще сталкивается с угрозами безопасности данных. Такой тренд наглядно показывает аналитика от Kaspersky Cyber Threat Intelligence Team, который подготовили еще летом:
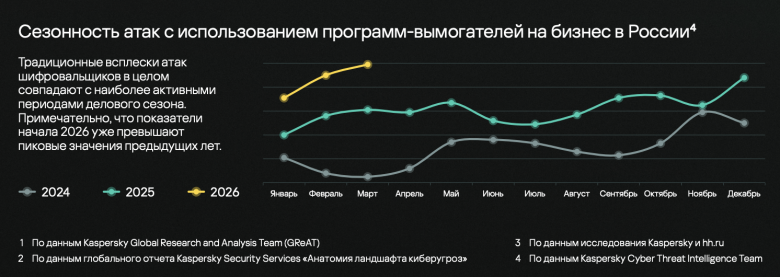
Прежде чем перейти к защите, давайте рассмотрим основные причины, которые могут угрожать данным не только в S3, но и во всех типах хранилищ.
Публикация бакета в публичный доступ. В таком случае злоумышленники могут получить доступ к секретной информации, которую компания не хотела распространять.
Перезапись информации может происходит из-за клиентского приложения или человеческой ошибки. Последствия бывают довольно серьезными, вплоть до безвозвратной потери данных. Например, если в хранилище лежит фронтенд веб-приложения, то случайная перезапись может привести к тому, что он перестанет работать для всех посетителей.
Удаление данных из-за человеческого фактора или действий злоумышленника. Худший сценарий в данном случае — полная ликвидация, когда удаляются все бакеты со всей историей версий и бэкапами.
Шифрование данных. После взлома злоумышленники могут ограничить доступ к данным и требовать выкуп для предоставления доступа.
Но без паники. В S3 данные можно защитить, чтобы злоумышленники не получили к ним доступ.

Арендуйте сервер с доставкой на вашу площадку
Предоставим мощные серверы для запуска проекта on-premise с помесячной оплатой, полным контролем над железом на этапе запуска и возможностью выкупа.
Разграничение прав доступа через Bucket Policy
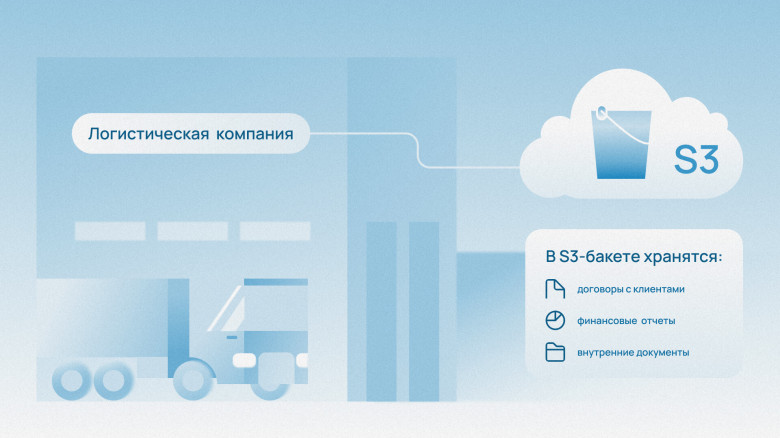
Представим логистическую компанию, которая занимается грузоперевозками и управляет цепочками поставок. В S3-бакете она хранит договоры с клиентами, финансовые отчеты и внутренние документы — то есть данные, к которым крайне важно ограничить доступ.
Здесь на помощь приходит Bucket Policy — политика доступа к бакету. Она представляет собой JSON-файл с правилами доступа, который прикреплен к бакету и работает в связке с IAM. Но в отличие от IAM, Bucket Policy умеет работать с ограничением доступа по IP и подсетям, а также заголовками HTTPS. Политика будет приоритезировать свои правила над правилами IAM и применять их так: сначала явный запрет, затем явное разрешение. Если в правилах однозначно не прописать запрещенное или разрешенное действие, то это действие будет неявно запрещено. Подробнее об этом читайте в статье «Как защититься от удаления в S3 с помощью Object Lock / WORM».
В кейсе воображаемой логистической компании достаточно было бы установить белый список IP-адресов для доступа к данным только из корпоративной сети:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "AllowOnlyWhitelistedIPs",
      "Effect": "Allow",
      "Principal": "*",
      "Action": [
        "s3:GetObject", // Что можно делать с данными
        "s3:PutObject"
      ],
      "Resource": [
        "arn:aws:s3:::my-bucket", //С каким именно бакетом
        "arn:aws:s3:::my-bucket/*"
      ],
      "Condition": {
        "IpAddress": {
          "aws:SourceIp": [
            "192.x.x.0/24", // Кому можно что-то делать с данными
            "203.x.x.5/32"
          ]
        }
      }
    }
  ]
}
Если компания захочет изолировать чувствительные данные или запретить удаление в критически важных папках, то она может задать ограничения в Bucket Policy. Например, запретить удаление или изменение объектов и оставить к ним доступ только для чтения.
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "ReadOnlyFolder",
      "Effect": "Allow",
      "Principal": "*",

            "Action": [
        "s3:GetObject"
      ],
      "Resource": "arn:aws:s3:::my-bucket/*"
    }
  ]
}
er/*"
Однако при работе с этим инструментом нужно быть внимательным. Важно учитывать, что Bucket Policy применяется мгновенно: одной неверно написанной строчкой можно отрезать доступ к бакету. В связи с этим рекомендуем тестировать политику на стейджинг-бакете, а также всегда держать резервную копию предыдущей политики.
Помимо этого стоит помнить, что возможности Bucket Policy ограничены размером самого файла — 20 КБ. Если в списке много IP-адресов, то можно упереться в лимит.
Защита от удаления: версионирование и Object Lock
Версионирование
Логистическая компания ограничила удаление объекта злоумышленником извне, но остается вопрос: как защитить файлы от попыток их переписать? В данном случае нужно действовать превентивно, то есть заранее включить версионирование. Главное свойство, ради которого стоит его использовать, — возможность откатиться к любой предыдущей версии объекта.
Подобный откат достигается за счет того, что загрузка объекта по существующему ключу не затирает физически старую версию, а создает новую со своим versionId. Старая версия никуда не пропадает, а остается лежать рядом в бакете как non-current.
В списке предыдущую версию не будет видно, но до нее можно дотянуться, передавая versionId. Попытка сделать DELETE без указания конкретной версии объекта не удаляет сам объект, а ставит тег delete-marker, после чего объект не отображается в листинге. Get Object в таком случае вернет 404.
Функциональность включается одним тумблером в панели управления или командой в CLI. Однако нужно помнить, что версионирование –- это защита только от случайного удаления. Если нужно убрать конкретную версию физически, стоит использовать другую операцию — DeleteObjectVersion. Поэтому прибегать к версионированию без Bucket Policy нежелательно.
Подробнее о том, как работать с версионированием, рассказали в предыдущей статье.
Object Lock
Если необходимо не просто сохранить целостность файла, но в целом исключить любые изменения, стоит обратить внимание на Object Lock. Это режим хранения, который делает версии объекта неизменяемыми. Он работает по принципу WORM (Write Once Read Many): удерживает объект и не дает его удалить до конца срока удержания. Время ограничения зависит от примененной политики:
Retention Period— на конкретный срок;Legal Hold— бессрочно.
У Object Lock есть две ключевые особенности. Во-первых, он применяется к версиям объектов, а не к ключам. Во-вторых, он защищает объект через метаданные самой версии, а не через политику. В результате обход становится невозможным даже при изменении самой Bucket Policy. Такое решение идеально подойдет в случаях, когда необходимо соблюдать строгие регуляторные правила или когда у компании есть повышенная потребность в сохранности данных.
Подробнее о том, как защитить данные от удаления в S3 с помощью Object Lock, рассказали в предыдущей статье. Будет полезно тем, кто хочет использовать его на практике.
Теперь рассмотрим подробнее политики работы Object Lock и начнем с Retention Period. Он действует в двух режимах: Governance и Compliance. Между ними есть существенная разница, поэтому важно понимать, какой именно режим нужен в конкретной ситуации.
Governance — это режим с «подстраховкой», в котором нельзя удалить объект, пока не завершится срок его удержания. Попытка удаления просто завершится ошибкой. При этом имеется отдельное право s3:BypassGovernanceRetention, c помощью которого можно обойти запрет и совершить эти действия.
Compliance — более строгий режим, который не позволяет сокращать срок удержания или удалять объект всем без исключений.
К выбору режима нужно подходить ответственно и с учетом вводных данных компании. Представим, что вы хотите предотвратить компрометацию и шифрование данных или выполнить особые требования регуляторов. Если вам не нужно уменьшать срок удержания, стоит присмотреться к режиму Compliance, в противном случае — к Governance.
Вернемся ко второй политике — Legal Hold. По сути, это флаг ON/OFF на конкретной версии объекта, который может работать параллельно с Retention, но по сравнению с ним будет иметь приоритет. У политики нет срока действия, то есть она будет действовать до тех пор, пока вы не снимете ее вручную. Снять или установить такое удержание можно только с правом s3:PutObjectLegalHold. Типичный сценарий использования Legal Hold — заморозка данных до принятия решения регулятором и расследование инцидентов, когда крайне важен факт отсутствия изменений в данных.
Такое разнообразие функций у инструмента имеет и обратную сторону. Применять его стоит осознанно, поскольку Object Lock нельзя отключить после создания бакета, а применение к версиям, загруженным до начала использования политики, не представляется возможным.
Шифрование данных
Если возможности прошлых политик кажутся недостаточными и необходимо, чтобы даже при получении доступа к S3 злоумышленник не смог ничего сделать, можно воспользоваться шифрованием данных на стороне клиента. Да, это не совсем про функциональность S3, а скорее про внешнюю возможность повышения защиты, но не упомянуть об этом было бы неправильно.
Идея клиентского шифрования (Client-side Encryption) заключается в том, что вся магия криптографии происходит на стороне клиента, а S3 получает уже зашифрованный поток данных. Клиент использует пару ключей — публичный и приватный — для реализации гибридного шифрования. Сами данные шифруются быстрым симметричным ключом, который затем защищается асимметричной парой. Такая механика гарантирует, что расшифровать информацию сможет только владелец приватного ключа.
Существует несколько моделей работы с ключами. Выбирать стоит ту, которая будет вам полностью подходить с учетом ваших особенностей. Например, статический ключ — быстрый вариант, но требует надежного хранилища. Envelope encryption — более продвинутый с созданием data key на каждый объект и зашифрованного master key, но ротация ключей может стать проблемой для неподготовленного специалиста. Внешняя KMS — Vault Transit, который предоставляет гибкость решения и полный контроль над ключами, но при этом имеет высокий порог входа. Компании нужно уметь разворачивать, настраивать, бэкапить и самостоятельно следить за жизненным циклом ключей.
Выбор места хранения ключей может быть в отдельных случаях даже более важен, чем само шифрование. Каким бы надежным оно ни было, скомпрометированный или потерянный ключ может свести на нет все старания над возведением неприступной крепости для данных.
Многослойность защиты
Вернемся опять к логистической компании. Что же можно посоветовать ей для обеспечения высокого уровня сохранности данных? Bucket Policy? Может, Object Lock или шифрование? На самом деле не нужно выбирать что-то одно, если можно взять лучшее от каждого инструмента.
Рассмотрим комбинацию способов в четыре слоя. Для защиты от перезаписи логистическая компания включит версионирование, с помощью Bucket Policy запретит удаление конкретной версии объекта через наложение Deny на DeleteObjectVersion и изменение конфигурации версионирование через PutBucketVersioning.
Включаем версионирование через команду в CLI:
 > aws s3api put-bucket-versioning \
--bucket $Bucket \
--versioning-configuration Status=Enabled \
Далее добавляем Bucket Policy:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "AllowMembersFullAccess",
      "Effect": "Allow",
      "Principal": "*",
      "Action": "s3:*"
      "Resource": [
        "arn:aws:s3:::my-bucket",
        "arn:aws:s3:::my-bucket/*"
      ]
    },
    {
      "Sid": "DenyDestructiveActions",
      "Effect": "Deny",
      "Principal": "*",
      "Action": [
        "s3:PutBucketVersioning",
        "s3:DeleteObjectVersion"
      ],
      "Resource": [
        "arn:aws:s3:::my-bucket",
        "arn:aws:s3:::my-bucket/*"
      ]
    }
  ]
}
Добавляем Object Lock в режиме Compliance, чтобы никто, включая root, не смог навредить данным.
Последним рубежом станет шифрование. Благодаря нему даже если какой-либо из слоев не сработает, злоумышленник все равно не сможет добраться до заветных данных.
Пишем команду для Object Lock:
 > aws s3api put-object-lock-configuration \
--bucket $Bucket \
--object-lock-configuration ‘{“ObjectLockEnabled”:”Enabled}’
Добавляем режим Compliance — например, на один день:
> RETAIN_UNTIL-${date u -v+ld + “%Y-%m-%dT%H:%M:%SZ”}
> aws s3api put-object \
--bucket $Bucket \
--object-lock-mode COMPLIANCE \
--object-lock-retain-until-date $RETAIN_UNTIL
И последний, но от этого не менее важный этап — шифрование. Выполняем генерацию ключа, например, во временный файл:
> age-keygen -o /tmp/cse2.key
В ответе увидим секретный и публичный ключи.
Важно: всегда храните ключи в надежном месте.
Публичный ключ сохраняем в переменную PUBKEY для удобства и пробуем загрузить файл в зашифрованном виде:
> age -r “$PUBKEY” | \
aws s3 cp - s3://$Bucket/test.txt.age
Для злоумышленника содержимое не будет иметь никакого смысла. При чтении файла он получит примерно следующее:
-> X25519 S4U3b2R9NIC9DOF+ksb0ZFvljoEpzQ4079hvZ8g5KTQ 0gCQou8LJD/N5MshrnNWal/PAuMUXd5cacop0NxuJUc --- a2h9qCjcJpeJWWY12/DXCKjC6xjd/6sjN0f8nESrLD8 ???kX5??x??+-~?8?x`??c0%??kh?@??J?:??k?_? ?O??gk???b??%
А законный обладатель ключа с помощью команды age -d -i /tmp/cse2.key сможет спокойно расшифровать интересующий его файл.
> aws s3 cp s3://$Bucket/test.txt.age | \ age -d -i /tmp/cse2.key
<Содержимое вашего файла>
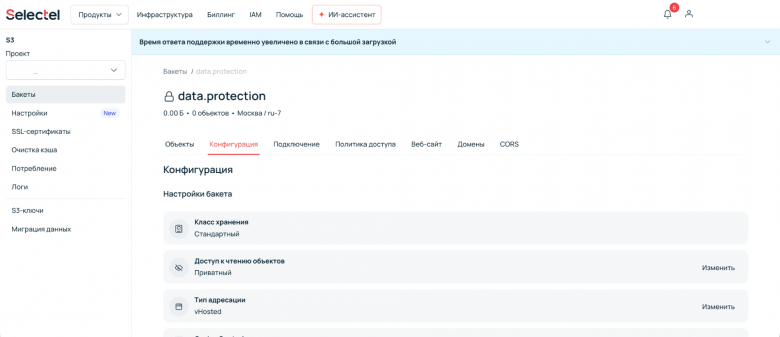
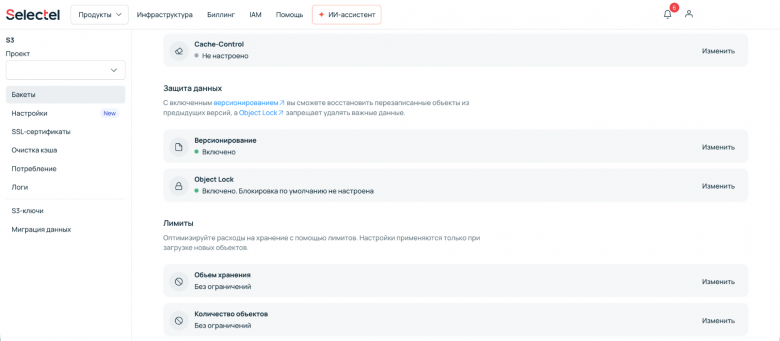
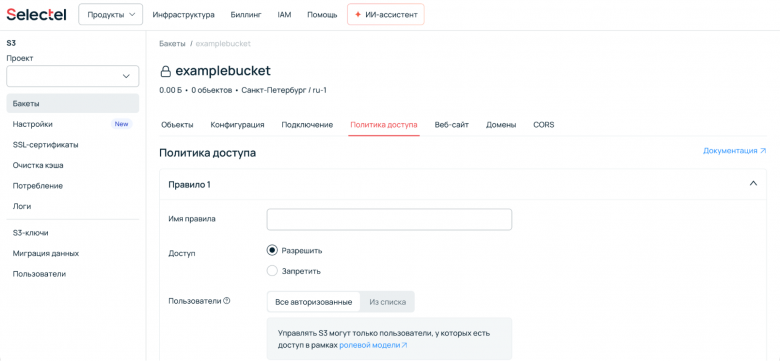
Если вы не любитель работы с CLI, все вышеперечисленное можете легко настроить через панель управления. Для этого зайдите в S3 → Бакеты, далее выберите нужный бакет и укажите необходимые настройки в разделах Конфигурация и Политика доступа.

30+ бесплатных курсов на ИТ‑темы в Академии Selectel
Для начинающих и опытных специалистов.
Что еще нужно для защиты данных в S3
Доступ к S3 через приватные сети
Проектам с повышенными требованиями к безопасности, стабильности и объему передаваемых данных может не подходить стандартный доступ через интернет. В таких сценариях можно организовать приватный доступ к S3 через глобальный роутер, при котором трафик между инфраструктурой (облачными или выделенными серверами) и объектным хранилищем будет циркулировать исключительно внутри изолированного сетевого периметра провайдера.
В отличие от публичного доступа, где запросы отправляются на общий домен s3.selectel.ru, приватный контур требует построения выделенной сетевой топологии. К глобальному роутеру подключаются локальные подсети ваших серверов, которые развернуты в различных проектах или дата-центрах. Далее между глобальным роутером и объектным хранилищем создается выделенная стыковочная подсеть из приватного пула IP-адресов. Она связывает таблицу маршрутизации вашего роутера напрямую с внутренней сетью S3.
Вместо стандартного публичного URL-адреса, приложения и системные утилиты перенастраиваются на обращение к приватному эндпоинту, предоставленному провайдером для вашей стыковочной сети. На самих серверах при этом прописывается статический маршрут.
Что это дает? Самое очевидное — изоляцию и невозможность перехватить данные извне. Из менее очевидного — при стандартном подходе серверы из приватных подсетей маршрутизируются в S3 через NAT-шлюз. При обработке больших массивов данных трафик S3 быстро исчерпывает лимиты пакетной производительности и пропускной способности NAT-маршрутизаторов. Приватный доступ направляет этот поток напрямую, высвобождая ресурсы NAT для штатной работы приложений.
Условная запись. Conditional Write
Есть еще одна интересная фича — Conditional Write. Она не совсем про защиту данных, а скорее про экономию: помогает избежать ненужных запросов и лишнего трафика.
Это также функциональность S3, которая нужна для защиты от потерянных обновлений при Race Condition. Работает она как Compare-and-Swap (CAS) на уровне S3, где перед записью происходит проверка условий. Данная фича обрабатывает несколько заголовков. Два из них основные: If-Match и If-Non-Match.
If-Match ожидает текстовый идентификатор версии в значении объекта <etag> либо списка <etag>, которые будут проверяться на момент записи. Если по данному ключу сейчас лежит объект с данными <etag>, то запись успешно проходит в S3. Если же на момент записи кто-то успел изменить объект, то появляется ошибка 412 Precondition Failed.
То же самое с If-Non-Match. Если вы передаете его на момент записи, то система проверяет существование любого объекта по данному ключу. Если он существует, запись прервется с ошибкой. А если никакого объекта по данному ключу не существует, запись проходит успешно.
Ниже типичные кейсы применения.
Хранение Terraform State.
Хранение различных фича-флагов в формате JSON в публичном бакете.
Реализация распределенного лога на «голом» S3.
Идемпотентная обработка с последующим сохранением стейта хранения в S3. Это основное место, где
Conditional Writeпринесет наибольшую пользу. Вы сохраняете<etag>, который помните по данному ключу, и при следующем запросе проверяете, что никто не успел изменить объект по нему.
Вывод
Важно понимать, что реальная защита — это именно слои. Один инструмент не закроет вас от всех угроз. Используйте сразу несколько, чтобы защититься от разных типов атак. В результате у вас получится хранилище-крепость, к которому будет очень сложно подступиться