

Браузеры традиционно относятся к самым крупным потребителям памяти на персональных компьютерах. Иногда кажется, что разработчики просто забили на оптимизацию, но реальность куда прозаичнее: пользователи открывают всё больше вкладок, сайты обрастают медиа и JavaScript, новые веб‑стандарты требуют хранить больше данных, а ради безопасности браузер изолирует сайты в отдельных процессах.
На три последних пункта повлиять сложно. Но что делать с десятками вкладок, которые пользователь открыл, посмотрел и забыл? Не запускать процесс до первого посещения — легко. Гораздо интереснее случай, когда страница уже загрузилась и продолжает занимать память — почти как активная вкладка.
Просто так закрыть её нельзя: страница потеряет состояние, а музыка, видео или фоновая задача могут прерваться. В Chromium уже есть сборка мусора, очистка кешей и другие способы оптимизации — однако память всё равно не всегда возвращается операционной системе надолго.
Чтобы разобраться, почему так происходит, мы в команде Яндекс Браузера собрали собственный профайлер обращений к страницам памяти. Под катом — устройство виртуальной памяти, lock‑free‑структуры внутри обработчика сигнала, профилирование через управляемый SIGSEGV, борьба с kevent64, mach_msg и libdispatch, а также переход от эксперимента на macOS к оптимизации, которая сильнее всего проявила себя на Windows.
Этой же теме посвящён мой доклад на конференции Back to Back. Если вам удобнее видеоформат, вот запись.
Почему память фоновой вкладки нельзя просто освободить
Самый эффективный способ освободить память фоновой вкладки — завершить отвечающий за неё процесс. Но это крайняя мера: если пользователь вернётся, страницу придётся загрузить заново. Для некоторых вкладок такой вариант вообще недопустим — никто не хочет, чтобы музыка или видео прервались из‑за оптимизации памяти.
Отличить важную вкладку от забытой помогают десятки эвристик. Учитывается, воспроизводит ли она медиа, выполняет ли фоновую задачу и как давно пользователь к ней обращался. Например, одна из таких временных границ — два часа: после неё вероятность возвращения заметно снижается, но при этом никогда не равна нулю. Другими словами, ни одна эвристика не гарантирует, что вкладка действительно больше не понадобится.
Закрыть вкладку — крайняя, но эффективная мера. Но всё же сначала хочется попробовать освободить память, не закрывая страницу. В Chromium для этого уже есть сборка мусора, очистка кешей, сжатие и дедупликация JavaScript‑строк. Есть и заморозка вкладок — к ней мы ещё вернёмся. Проблема в том, что даже после этих оптимизаций фоновый процесс может продолжать занимать сотни мегабайт.
Код браузера настолько велик, что ни один разработчик не сможет прочитать его целиком за всю жизнь. Поверх Chromium каждый браузер добавляет собственный слой кода: исправляет проблемы, адаптирует движок под свои сценарии и реализует продуктовые функции. В результате разработчик не может знать обо всех местах, где его коллеги и авторы Chromium выделяют память или обращаются к ней.
Поэтому оптимизации, как правило, начинаются не с изучения исходников, а с измерения критических вещей на готовом скомпилированном коде. Просмотреть все места, где выделяется память, а затем оптимизировать их по одному — не вариант. Каждое из них отвечает лишь за долю общего потребления, поэтому даже заметное локальное улучшение часто даёт процент от процента на уровне всего браузера.
И тут в ход идут профайлеры. Чаще всего для оптимизации памяти используют перехват malloc/new и их производных, а в случае с Chromium есть даже встроенный вариант с семплированием. Увы, это мало помогает, так как аллокации большого буфера не гарантируют, что он занимает память, а деаллокация не гарантирует, что память вернулась в систему. При этом не стоит забывать, что в Chromium используются каскады из нескольких аллокаторов, чтобы ускорять конкретные места кода.
Чтобы понять, куда уходит память процесса, нужен уникальный профайлер, который понимает, зачем, почему и где код трогает память. Теоретически такой инструмент можно было бы сделать на стороне операционной системы — у неё есть механизмы учёта страниц памяти. Но на Windows и macOS всё упирается в проприетарность кода ядра: без доступа к исходникам разрабатывать и отлаживать такой модуль гораздо сложнее. На Linux модуль написать можно, однако остаётся другая проблема: отладочные символы находятся на стороне пользовательского процесса, а нам нужно сопоставлять обращения к памяти со стеками его кода.
Мы решили работать изнутри процесса. Но прежде всего нам нужно было разобраться, как устроена виртуальная память и что именно мы собираемся измерять.
Что на самом деле занимает оперативную память
Память процесса делится на страницы памяти. Их размер зависит от архитектуры: например, на стандартной x86 это обычно 4 КБ, а на моём ноутбуке — 16 КБ, так как это Mac с M4.
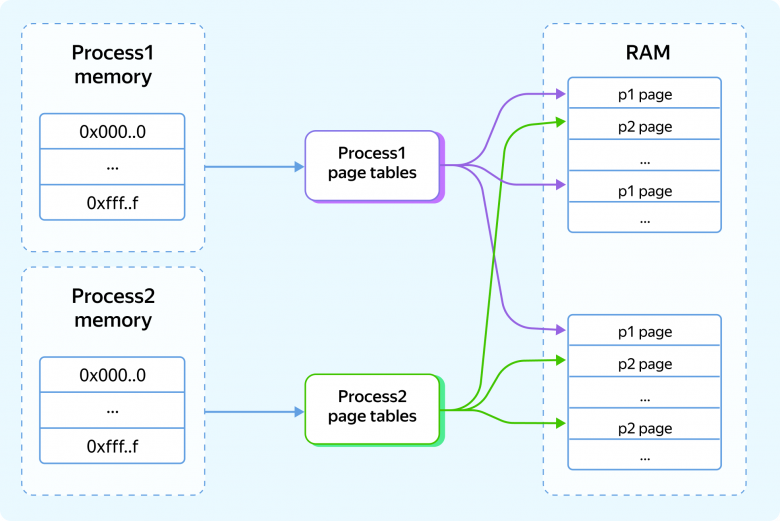
Процессы работают в абстракции виртуальной памяти: для них создаётся иллюзия непрерывного адресного пространства, хотя физически данные могут располагаться в разных участках памяти. Чтобы эта абстракция работала, связь между виртуальными и физическими адресами обеспечивают таблицы страниц:
Когда процессор получает команду прочитать или записать данные по виртуальному адресу, он сначала преобразует его в физический с помощью таблиц страниц:
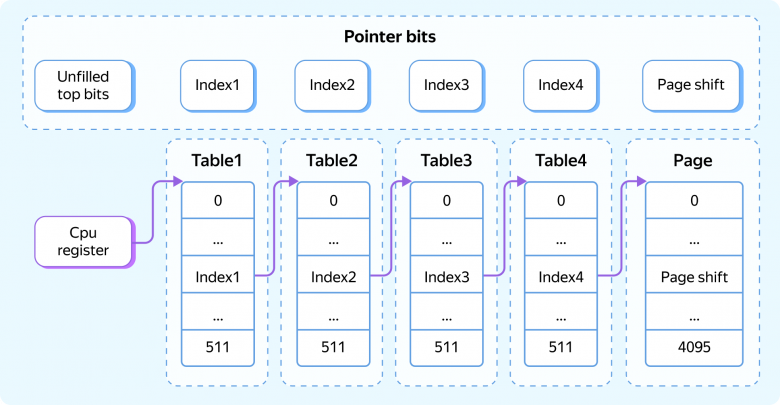
По сути, таблицы страниц — это префиксное дерево по битам указателя. Поиск начинается со значения, лежащего в специальном регистре. Самые старшие биты обычно не используются. Средние биты делятся на несколько полей, каждое из которых отвечает за свой уровень в дереве таблиц. Младшие — это смещение внутри самой странички. Кроме самого адреса, в таблице обычно хранятся права доступа: на чтение, запись и выполнение — как у файлов.
Потребление памяти — это количество страниц, которые хранятся в RAM. Обычно ОС достаточно ленивые и не выделяют память сразу: просто помечают в таблице страниц, что память обещана, но физически не выделена. И только в момент, когда идёт обращение, страница реально выделяется и начинает использоваться. Такой «ленивый» подход помогает экономить ресурсы: типичный рендерный процесс Chromium может занимать несколько гигабайт виртуальной памяти, но использовать лишь несколько сотен мегабайт физической.
Как превратить SIGSEGV в профайлер памяти
Чтобы оптимизировать потребление памяти, нужно определить, какой код действительно обращается к ней. Нас интересуют не участки выделенной памяти виртуального адресного пространства, а страницы, которые фактически используются и занимают место в RAM.
Как же это сделать?
Операционная система может остановить процесс при обращении к несуществующему адресу или к странице, права которой не разрешают запрошенную операцию — чтение, запись или выполнение. В зависимости от ОС процесс получает сигнал SIGSEGV или SIGBUS. Если обработчик сигнала не зарегистрирован, процесс обычно завершается, а система по возможности создаёт дамп памяти.
Большинство разработчиков на C++ воспринимают SIGSEGV как недостаток языка. И это один из аргументов для перехода на другие языки вроде Java. Но на самом деле JVM под капотом использует SIGSEGV для остановки тредов, генерации NullPointerException и многих других штук. То есть SIGSEGV происходит в Java‑коде чаще! Просто это хороший, приручённый SIGSEGV, который делает полезные вещи.
Заставим его делать полезную работу и мы.
Попробуем с помощью обработчика сигнала сделать профайлер, который узнает, какой код обращается к памяти. Любой профайлер — это, по сути, триггер и сбор стека. Вся соль в том, как запустить этот сбор, чтобы сфокусироваться на нужных событиях. Чтобы поймать код в момент обращения к памяти, можно изменить права доступа к её страницам. Это вызовет SIGSEGV и позволит собрать стек в обработчике сигнала.
Через mprotect установим для страниц режим PROT_NONE, запрещающий чтение, запись и выполнение. Так в таблице страниц появится ловушка: при первом обращении процесс получит SIGSEGV или SIGBUS, а мы сможем сохранить стек вызовов и восстановить права с помощью mprotect. Затем символизируем собранные стеки в отдельном треде, залогируем их в файл, обработаем скриптами и построим по ним флеймграф или другую приятную глазу аналитику. При этом мы сами выбираем страницы памяти, которые хотим анализировать, — хоть конкретный буфер, хоть всю память процесса.
Осталось понять, как в C++ устроены обработчики SIGSEGV/SIGBUS.
Как работает обработчик SIGSEGV
Обычно процесс взаимодействует с операционной системой через системные вызовы. Он помещает параметры в регистры, и специальная инструкция вызывает прерывание, после чего процессор переходит в режим ядра, где доступен более полный набор инструкций (например, можно менять значение регистра, указывающего на таблицы страниц), и передаёт управление соответствующему обработчику. По сути, это тот же процесс, просто выполняется код ядра с повышенными доступами.
Но SIGSEGV и другие сигналы работают иначе. Тут, наоборот, ядро ОС передаёт управление в пользовательском режиме. Поэтому это не ядро регистрирует обработчики системных вызовов, а мы пытаемся зарегистрировать в ОС свой обработчик сигнала:
#include <signal.h>

void SigsegvHandler(int sig, siginfo_t* info, void* uctx);

bool RegisterHandler() {
  struct sigaction sa = {};
  sa.sa_sigaction = &SigsegvHandler;
  sigemptyset(&sa.sa_mask);
  sa.sa_flags = SA_SIGINFO;
  int res = sigaction(SIGSEGV, &sa, nullptr);
  return res == 0;
}
Создаём функцию с нужными аргументами, регистрируем как обработчик сигнала — и всё. Теперь при получении сигнала вызывается эта функция.
Главная особенность — код вызывает ядро. Для SIGSEGV и SIGBUS (в Linux и современных версиях macOS) он выполняется в контексте потока, который вызвал ошибку. Если мы попытаемся распечатать стек в обработчике, он будет выглядеть магически: поверх прерванного кода появляется вызов нашего обработчика, которого в исходной функции, конечно, нет. Между ними находится сигнальный кадр — служебная область, куда ОС записывает состояние потока и информацию о том, что произошло.
Как не сломать процесс внутри обработчика SIGSEGV
Написать обработчик сигнала — отдельное испытание. Как можно было понять из прошлого раздела, для процесса происходит что‑то из ряда вон: целый тред больше не выполняется. Если до этого он успел захватить блокировку или спинлок, ждать их освобождения внутри обработчика бессмысленно. По той же причине нельзя использовать обычный аллокатор: мы могли остановить поток прямо в его критической секции. Не все системные вызовы здесь тоже безопасны.
Удивительным образом многое из этого можно обойти:
Использовать создание памяти на стеке. Это реализуется за счёт одного регистра стека. Такой памяти немного, зато выделяется она быстро.
Заранее выделить всю необходимую память.
Постараться использовать только lock‑free‑код.
Использовать только доступные вызовы. Например, среди них неожиданно есть
write.Для получения стека использовать
backtrace. Он чаще всего безопасен, но формально implementation‑defined. Chromium использует в основном его.
Одного этого уже было бы достаточно, чтобы логировать все стеки без символизации — только адреса инструкций кода. Символизация потенциально аллоцирует строчки, так что её лучше отложить до окончания обработки.
Так как мы играемся с памятью и доступами к ней, нам надо чётко знать, где лежат наши структуры, чтобы случайно не вставить самим себе палки в колёса. Здесь нужен свой простой наколеночный аллокатор в контролируемом регионе памяти. Например, простой std::array:
std::array<std::byte, 512 * 1024 * 1024> buffer;
class MyAlloc {
public:
  MyAlloc(std::byte* start, std::byte* end)
      : start_(start), end_(end) {
    CHECK(start_ < end_);
  }

  template <typename T>
  T* Provide(std::atomic<T*>& ptr) {
    if (!ptr) {
      ptr = Allocate<T>();
    }
    return ptr;
  }

  template <typename T>
  T* Allocate() {
    T* ret = (T*)start_;
    new (ret) T();
    start_ += sizeof(T);
    CHECK(start_ <= end_);
    return ret;
  }

private:
  std::byte* start_;
  std::byte* const end_;
};
В примере мы заранее выделяем буфер на 512 МБ. Это не означает, что он сразу займёт столько же физической памяти: ОС выделяет физические страницы по мере обращения к ним. Другими словами, лень операционной системы не позволит потратить больше необходимого.
Сам аллокатор максимально простой: никакого выравнивания, никакого возврата памяти, никакого расширения при переполнении.
Самая интересная строчка — inplace new в методе Allocate. Это настолько редкая форма new, что можно программировать на C++ годами, не зная о её существовании. По сути, это вызов конструктора по переданному адресу без предварительного malloc.
В методе Provide есть ещё немного «сахара» — атомарный указатель с lock‑free‑инициализацией. Так мы сохраняем необходимые инварианты и учитываем ограничения обработчика сигнала.
Как связать страницы памяти со стеками: PageRecord и префиксное дерево
Если мы хотим для каждой страницы памяти запомнить стек, который к ней обращался, нам нужно заранее создать структуру, куда мы положим этот стек. Например:
struct PageRecord {
  std::array<const void*, 60> stack;
  size_t count = 0;
  std::atomic<int> generation = 0;
  std::atomic<int> restore_protection = PROT_NONE;
};
Здесь можно сохранить стек глубиной до 60 кадров — для большинства проектов этого достаточно. Но, по моему опыту, код библиотеки Blink легко превышает глубину стека в 180 кадров. Поэтому размер нужно подбирать под конкретный проект.
В count храним фактическое количество кадров, записанных в стек. Поле generation показывает, в каком поколении профилирования к странице обращались в последний раз, а restore_protection содержит права доступа, которые нужно восстановить после срабатывания ловушки.
Так как нам нужно отображать адрес страницы на эту структуру, должен быть собственный trie, по логике повторяющий таблицы страниц.
Вот класс ноды дерева:
template <size_t bits, typename TNext>
class Node {
 public:
  template <size_t used_bits>
  std::atomic<TNext*>& GetPtr(uintptr_t key) {
    size_t shift = sizeof(uintptr_t) * 8 - used_bits - bits;
    return subnodes_[(key >> shift) & ((1 << bits) - 1)];
  }

  template <size_t used_bits>
  TValue* find(uintptr_t key) {
    if (TNext* subnode = GetPtr<used_bits>(key)) {
      return subnode->template find<used_bits + bits>(key);
    }
    return nullptr;
  }

  template <size_t used_bits>
  static TValue& find_or_alloc(MyAlloc* alloc, std::atomic<Node*>& self, uintptr_t key) {
    std::atomic<TNext*>& ptr = alloc->Provide(self)->template GetPtr<used_bits>(key);
    return TNext::template find_or_alloc<used_bits + bits>(alloc, ptr, key);
  }

  template <size_t used_bits, typename TFunc>
  static void Visit(Node* self, uintptr_t key, TFunc&& func) {
    if (!self) {
      return;
    }
    size_t shift = sizeof(uintptr_t) * 8 - used_bits - bits;
    for (uintptr_t i = 0; i < (1 << bits); ++i) {
      TNext::template Visit<used_bits + bits>(self->subnodes_[i],
                                              key | (i << shift), func);
    }
  }

 private:
  std::atomic<TNext*> subnodes_[1 << bits] = {};
};
Здесь есть немного магии с битами в методе GetPtr. Метод find предназначен для читающих потоков, а паттерн Visitor, реализованный в методе Visit, позволяет обходить собранные стеки. Матрёшка нод завершается простой обёрткой над значением:
class FinalNode {
 public:
  template <size_t used_bits>
  TValue* find(uintptr_t) {
    return &Value;
  }

  template <size_t used_bits>
  static TValue& find_or_alloc(MyAlloc* alloc,
                               std::atomic<FinalNode*>& self,
                               uintptr_t key) {
    return alloc->Provide(self)->Value;
  }

  template <size_t used_bits, typename TFunc>
  static void Visit(FinalNode* self, uintptr_t key, TFunc&& func) {
    if (self) {
      func(key, self->Value);
    }
  }

 private:
  TValue Value;
};
Заворачиваем всё в структуру trie. Для простоты давайте опустим конструкторы:
class MyTrie : public MyAlloc {
public:
  TValue& operator[](uintptr_t key) {
    return TRoot::template find_or_alloc<0>(this, root_, key);
  }
  TValue* find(uintptr_t key) {
    if (root_) {
      TRoot* root = root_;
      return root->template find<0>(key);
    }
    return nullptr;
  }

  template <typename TFunc>
  void Visit(TFunc&& func) {
    TRoot::template Visit<0>(root_, 0, func);
  }

private:
  using TRoot =
      Node<10, Node<8, Node<8, Node<8, Node<8, Node<8, FinalNode>>>>>>;
  std::atomic<TRoot*> root_ = nullptr;
};
Здесь предполагается 64-битная архитектура: trie использует 50 старших битов, а оставшиеся 14 битов отбрасывает, поскольку смещение внутри страницы нас не интересует. Метод find можно использовать в обработчике сигнала — всё внутри lock‑free. А operator[] и Visit, напротив, рассчитаны на использование в одном треде.
Как собрать профайлер из готовых частей
Собственно, можно собрать профайлер. Но для начала немного вспомогательных методов:
uintptr_t PageAlignDown(uintptr_t x) { return x & ~(uintptr_t(PAGE_SIZE - 1)); }

int ProtToMprotect(vm_prot_t p) {
  int out = 0;
  if (p & VM_PROT_READ) {
    out |= PROT_READ;
  }
  if (p & VM_PROT_WRITE) {
    out |= PROT_WRITE;
  }
  if (p & VM_PROT_EXECUTE) {
    out |= PROT_EXEC;
  }
  return out;
}

static void MprotectImpl(uintptr_t start, int restore_prot) {
  mprotect((void*)start, PAGE_SIZE, restore_prot);
}
Нам понадобятся три вспомогательные операции: выровнять произвольный адрес по границе страницы, преобразовать системные права доступа в формат, понятный mprotect, и применить их к странице. С ними заготовка профайлера будет выглядеть так:
class Profiler {
public:
  Profiler(Profiler** self_global_ptr);
  void Process(uintptr_t addr);
};

Profiler* global_profiler = nullptr;

void SigsegvHandler(int sig, siginfo_t* info, void* uctx) {
  if (Profiler* p = global_profiler) {
    p->Process((uintptr_t)info->si_addr);
  }
};
Сам профайлер доступен через глобальный указатель, к которому обращается обработчик сигнала. Инициализируем профайлер так:
global_profiler = new Profiler(&global_profiler);
Важный момент: глобальный указатель на профайлер тоже нужно защитить от ловушек в памяти. Иначе SigSegvHandler не сможет получить доступ к самому профайлеру. Поэтому в конструктор передаём его собственный адрес.
Теперь можно обработать сигнал внутри профайлера:
void Profiler::Process(uintptr_t addr) {
  // DO NOT ALLOCATE
  uintptr_t page_addr = PageAlignDown(addr);
  PageRecord* data = pages_.find(page_addr);
  CHECK(data);
  int restore_prot = data->restore_prot;
  if (restore_prot != PROT_NONE) {
    MprotectImpl(key, restore_prot);
    data->Collect(current_generation);
  }
}
Преобразуем адрес, вызвавший ошибку, к адресу страницы и находим соответствующую запись. Если её нет, значит, сигнал вызван не нашей ловушкой и выполнение лучше аварийно завершить. Затем восстанавливаем права страницы и только после этого собираем стек. Порядок важен, так как сбор стека потенциально будет обращаться к памяти:
bool PageRecord::Collect(int cur_gen) {
  int new_gen = cur_gen + 1;
  int old_gen = generation.load(std::memory_order_relaxed);
  while (old_gen >= 0 && old_gen < new_gen) {
    if (generation.compare_exchange_weak(old_gen, -1, std::memory_order_acq_rel,
                                   std::memory_order_acquire)) {
      count = backtrace(const_cast<void**>(stack.data()), 60);
      generation.store(new_gen, std::memory_order_release);
      return true;
    }
  }
  return false;
}
Это похожий на спинлок, но всё же lock‑free‑паттерн: он собирает стек только по одному потоку — тому, который первым захватил переменную generation. При этом каждое новое поколение перезаписывает предыдущее, поэтому мы всегда видим максимально свежие стеки.
Осталась самая сложная для портирования и поддержки часть — архитектурнозависимое сканирование виртуальной памяти для расстановки ловушек. Так как я работаю на macOS, профайлер разрабатывался под эту ОС — в его основе лежит mach_vm_region_recurse. Эта функция последовательно отдаёт принадлежащие процессу регионы виртуальной памяти вместе с их правами доступа и флагами.
Дальше начинаются костыли и подпорки. Мы хотим расставлять ловушки только в памяти, изначально доступной для чтения или записи, но не для выполнения: защищать код гораздо сложнее. При этом нужно исключить стеки потоков и память, которой процесс делится с другими процессами. Для этого накинем список исключений:
mach_vm_address_t addr = 0;
mach_vm_size_t size = 0;

while (true) {
  vm_region_submap_info_data_64_t info{};
  mach_msg_type_number_t count = VM_REGION_SUBMAP_INFO_COUNT_64;
  natural_t depth = 0;

  kern_return_t kr = mach_vm_region_recurse(
    mach_task_self(), &addr, &size, &depth,
    (vm_region_recurse_info_t)&info, &count);

  if (kr != KERN_SUCCESS) {
    break;
  }

  if (size == 0) {
    addr += PAGE_SIZE;
    continue;
  }

  const bool is_exec = (info.protection & VM_PROT_EXECUTE) != 0;
  const bool is_write = (info.protection & VM_PROT_WRITE) != 0;
  const bool is_read = (info.protection & VM_PROT_READ) != 0;
  const bool is_private = info.share_mode == SM_PRIVATE;
  const bool excluded = info.user_tag == VM_MEMORY_STACK ||
                        info.user_tag == VM_MEMORY_SHARED_PMAP ||
                        info.user_tag == VM_MEMORY_UNSHARED_PMAP ||
                        info.user_tag == VM_MEMORY_DYLD ||
                        info.user_tag == VM_MEMORY_OS_ALLOC_ONCE ||
                        info.user_tag == VM_MEMORY_GENEALOGY;
  if ((is_write || is_read) && !is_exec && is_private && !excluded) {
    // Process region
  }

  addr += size;
}
И добавим обработку конкретного региона памяти:
uintptr_t start = (uintptr_t)addr;
uintptr_t end = start + (uintptr_t)size;
while (start < end) {
  if (IsProtectedRegion(start)) {
    start += PAGE_SIZE;
    continue;
  }

  auto& record = pages_[start];
  record.restore_prot = ProtToMprotect(info.protection);
  MprotectImpl(start, PROT_NONE);

  start += PAGE_SIZE;
}
Бегаем по всем страничкам, проверяем, не трогают ли они наши структуры — профайлер и глобальный указатель на него. Сканируем память с небольшими паузами между поколениями: достаточно пары секунд, чтобы процесс не слишком часто «икал» на ловушках. Всё это выполняем в отдельном специализированном потоке: сканируем память, расставляем ловушки, затем снимаем их, чтобы они не мешали обработать и вывести собранные стеки, — и повторяем цикл. Но реальный код устроен сложнее.
Большая ложка дёгтя, или Почему профайлер начал ронять Chromium
Вся идея красивая и шикарно работает для большинства страниц. При семплировании всё запускалось с первого раза. Но когда мы попытались расставить ловушки на всех страницах, прошедших фильтр, процесс начал непредсказуемо падать.
В чём же проблема?
Системные вызовы тоже проверяют права доступа к страницам в процессе своей работы. Но вместо вызова нашего обработчика сигналов они могут просто вернуть ошибку invalid access. Значит, память, используемую системным вызовом, нужно отдельно защищать от ловушек.
Для этого каждый системный вызов можно обернуть в guard, который:
защитит страницы от расстановки ловушек всё время работы сканирующего треда;
после этого снимет с них уже существующие ловушки — либо обращаясь к памяти, либо напрямую, вызывая метод
Processпрофайлера.
Порядок операций очень важен для lock‑free. Поэтому расстановка ловушек проходит в два этапа: сначала мы планируем её, а затем, ещё раз проверив отсутствие новых запретов, применяем. Guard при этом отменяет уже запланированные ловушки для защищаемых страниц.
Полный код выкладывать нет смысла: практически все функции увеличатся вдвое, а листинги перестанут читаться. Lock‑free не для слабонервных.
Системных вызовов довольно много, но в Chromium они сосредоточены в платформозависимом коде, поэтому на практике защищать приходится не так много мест. На macOS это в основном kevent64, mach_msg, read, pthread_mutex_* и pthread_cond_*.
Например, в этом списке нет write, и это логично: перед вызовом процесс обращается к памяти, заполняя её данными, и тем самым заранее снимает ловушку. Есть вероятность, что сканирующий поток успеет расставить её между заполнением буфера и вызовом write, но для экспериментального инструмента это допустимо.
Если нужен инструмент, работающий в 100% случаев, одних системных вызовов недостаточно. Придётся выдрать ещё один пучок нервов в борьбе с libdispatch: библиотека регистрирует свои очереди в ядре, и другие системные вызовы могут обращаться к ним, даже если в их аргументах нет явного указателя на нужную очередь.
Что показал профайлер и кто оказался главным виновником
Вот как выглядит работа профайлера:
Забавный момент: инструмент работает настолько бесшовно, что пользователь практически не замечает замедления. При этом профайлер продолжает собирать новые поколения стеков, позволяя почти в реальном времени наблюдать за тем, что происходит внутри рендерного процесса.
Значительная часть памяти браузера приходится на рендерные процессы фоновых вкладок. Профайлер показал, что даже после перехода вкладки в фон они продолжают обращаться к памяти, чтобы:
очищать кеши;
сжимать большие JavaScript‑строки и при возможности сбрасывать их на диск;
запускать более интенсивную сборку мусора, чем в активной вкладке, где важнее сохранить отзывчивость;
выполнять JavaScript‑обработчики событий и пересылать фоновые сетевые сообщения, в том числе аналитику сайтов.
Первые проходы сборщика мусора действительно освобождают память. Но уже на третий‑четвёртый проход он почти ничего не находит, хотя продолжает обходить множество страниц. Часть из них содержит редко используемые или почти не меняющиеся данные, которые хотелось бы просто выгрузить на диск. Но со стороны процесса это сделать сложно: память распределена между десятками библиотек, каждая из которых держит собственные пулы и буферы «на всякий пожарный».
Зато операционная система видит активность отдельных страниц и может отправлять неиспользуемые данные в файл подкачки. И здесь же обнаружился парадокс: сборщик мусора пытался уменьшить потребление памяти процесса, но во время обхода снова обращался ко множеству страниц. Для ОС они выглядели активными и возвращались в физическую память, хотя очередной проход GC почти ничего не освобождал.
Поэтому мы изменили жизненный цикл фоновой вкладки:
очищаем кеши;
сжимаем JavaScript‑строки;
запускаем полную сборку мусора без жёстких ограничений по времени;
замораживаем вкладку, останавливая JavaScript и последующие запуски GC;
просим операционную систему забрать неиспользуемые страницы;
позволяем ОС загрузить нужные данные из файла подкачки, когда пользователь возвращается..
В результате процессы фоновых вкладок, которые раньше занимали сотни мегабайт, в диспетчере задач Windows сжимались до 5–15 МБ физической памяти.
Внимательный читатель заметит, что macOS здесь как‑то незаметно превратилась в Windows. В этом и заключается особая магия Chromium: эффект можно обнаружить на одной платформе, а само решение перенести на другие, поскольку основная логика браузера у них общая. Платформенные механизмы управления памятью работают по‑разному, а сильнее всего от оптимизации выиграла версия для Windows, где работает большинство пользователей Яндекс Браузера. При этом эффект заметен и в других операционных системах.
Что дала оптимизация
В итоге потребление памяти Яндекс Браузером на Windows снизилось в среднем на 20% среди пользователей на уровне 95-го перцентиля по потреблению памяти. Это как раз та группа, для которой нехватка ресурсов наиболее заметна.
Почему всего 20% общей экономии?
Рассмотрим конкретный пример. Браузерный процесс занимает 300 МБ, GPU‑процесс — 400 МБ, служебные процессы для работы с сетью и диском — ещё 300 МБ. На рендеры приходится 1,9 ГБ: четыре свежих по 250 МБ, три небольших фоновых по 100 МБ и три неактивных фоновых по 200 МБ. Суммарно браузер занимает 2,9 ГБ.
Если сократить потребление трёх неактивных рендеров с 200 до 10 МБ, получится освободить 570 МБ — около 20% всей памяти браузера. Поэтому даже сильная оптимизация рендерных процессов по‑разному влияет на общий результат: всё зависит от количества фоновых вкладок и объёма памяти, занятого остальными процессами.
Эти 20% — не гарантированный результат для каждого компьютера. Эффект зависит от количества вкладок и их содержимого, объёма оперативной памяти и сценария использования. У одних пользователей экономия будет больше, у других — меньше.
Косвенно результат подтвердило независимое исследование ИАА TelecomDaily: в его сценариях Яндекс Браузер показал самое низкое потребление памяти на Windows среди протестированных браузеров. Это отдельный эксперимент со своей методикой, поэтому напрямую приписывать его результат нашей оптимизации нельзя. Но он показывает, что эффект заметен не только во внутренних измерениях.
В итоге оказалось, что для экономии памяти недостаточно активнее её освобождать, — иногда процессу нужно просто перестать к ней обращаться. Профилирование на уровне страниц помогло увидеть этот конфликт между Chromium и операционной системой и найти решение там, где обычные профайлеры аллокаций его не показывали.