

Привет, Хабр! Меня зовут Никита Калганов, я ведущий системный инженер данных в X5 Tech. Мы с командой проектируем и развиваем высоконагруженную систему потоков данных и поддерживаем её в условиях постоянного роста, как по числу потоков, так и по количеству команд, которые с ней работают.
В нашей системе обработки данных живёт больше двенадцати тысяч потоков данных, и их число растёт в среднем на несколько десятков в день. Всё нормально работает, но мы решили сделать её ещё лучше. В этой статье расскажу, как мы построили единое окно инженера данных, сделали собственный DDL-мигратор с поддержкой зависимостей и при этом сохранили то, что уже работает.
Что уже было хорошо и чего не хватало
К моменту, когда мы задумались о следующем шаге, система была достаточно зрелой. Потоки описывались декларативно в YAML, из конфигураций автоматически генерировался Python-код, сборка двенадцати тысяч потоков данных занимала полторы-две минуты, а вывод нового потока в прод мог укладываться в один день. Но оставались разные рутинные действия, которые все вместе съедали кучу времени:
Из-за огромного количества инструментов нужно постоянно переключаться между несколькими окнами: IDE для кода, GitLab, Airflow для мониторинга, причём у каждого хаба свой инстанс, Confluence для документации.
YAML валидировались только на этапе CI, если допускалась ошибка, о ней узнавали через несколько минут после push.
Права доступа в Airflow и GitLab управлялись раздельно, разделение было нормой.
DDL миграции не имели единой системы управления, что могло приводить к конфликтам между командами.
Branching-стратегия
Прежде чем рассказать про единое окно, стоит рассказать, как мы организовали работу с репозиторием, потому что без этого не взлетело бы и всё остальное.
Мы перешли на собственную модель ведения репозитория, при которой каждый разработчик работает в изолированной ветке. Инженер создаёт feature-, bugfix- или hotfix-ветку от main. На этапе push срабатывает набор статических проверок: линтеров, валидация YAML, проверка зависимостей. После прохождения проверок изменения, которые внёс разработчик, автоматически деплоятся в dev-окружение Airflow, где инженер проводит функциональное тестирование. Когда всё проверено, создаётся merge request в main, после которого изменения деплоятся в prod.
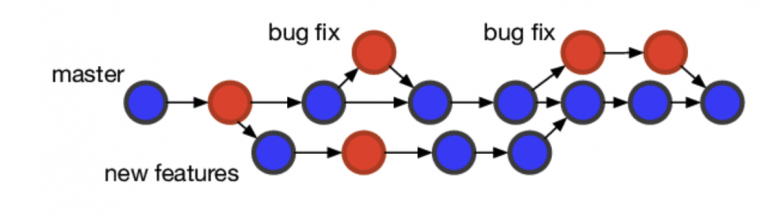
Ключевое преимущество — полная изоляция. Каждая ветка независима: у неё свой набор изменений, свой деплой в dev, свои тесты. Больше нет ситуаций, когда один разработчик своей ошибкой блокирует работу всей команды.
Bach — единое окно инженера данных
Bach — это не просто отсылка к композитору. Так же, как Бах соединял голоса в сложных фугах, наша система оркестрирует потоки данных в единую систему.
Мы подумали, что если инженер всё равно работает с YAML-конфигурациями, Git, Airflow и документацией, то зачем заставлять его прыгать между пятью вкладками. Поэтому сделали веб-среду разработки, в которой цикл от создания потока до мониторинга в проде выполняется из одного интерфейса.
Архитектура
Bach построен на микросервисной архитектуре. У нас девять сервисов, каждый со своей зоной ответственности:
Сервис |
Что делает |
API Gateway |
Единая точка входа, маршрутизация, аутентификация |
User Service |
Обмен Keycloak-токена на внутренний JWT, хранение GitLab-токенов и AI API-ключей |
Hub Service |
Реестр хабов — маппинг на инстансы Airflow |
Workspace Service |
Место, где разработчики создают потоки |
Template Service |
Библиотека шаблонов операторов — динамические JSON-описания для редактора блоков |
Pipeline Orchestrator |
Сборка данных со всех Airflow, запуск DAG-ов, получение логов |
Code Converter |
Конвертация из JSON-кода в YAML |
GitLab Service |
Система взаимодействия с GitLab |
AI Assistant |
Чат-бот с RAG - индексирует документацию из Confluence и отвечает на вопросы |
Визуальный конструктор потоков
Центральная фича — это drag-and-drop редактор на базе ReactFlow. Инженер перетаскивает операторы из палитры в рабочую область, соединяет их, образуя зависимости, заполняет параметры и видит, как блоки превращаются в код в реальном времени.
Каждый оператор описан JSON-шаблоном, который определяет набор полей ввода, маппинг полей в YAML и визуальное отображение. А если нужен новый оператор, то можно просто добавить шаблон.
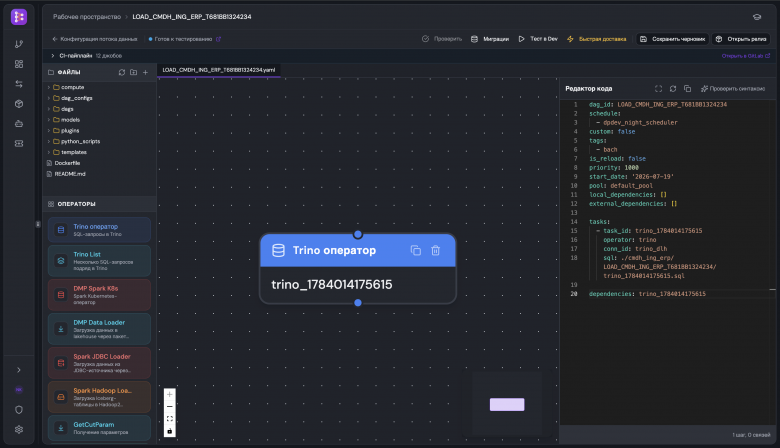
YAML-конвертация в реальном времени
Одно из ключевых архитектурных решений, когда YAML на ходу конвертируется через веб-сокет. При любом изменении (добавил оператор, поменял параметр, изменил связь) превью обновляется мгновенно в панели справа.
Топологическая сортировка корректно группирует параллельные задачи в Airflow-синтаксис — [task_a, task_b] >> task_c. JSON-поля автоматически встраиваются как YAML-объекты.
Workflow: от драфта до прода
Bach реализует полноценный жизненный цикл пайплайна:
Draft (черновик, автосохранение каждые 2 сек)
-> Validated (прошёл валидацию)
-> Testing in Dev (ветка в GitLab, CI, деплой в dev)
-> In Review (финальные проверки)
-> Reviewed -> Merge Request -> Deployed
Ревью выполняется прямо в интерфейсе Bach, и не нужно переключаться в GitLab.
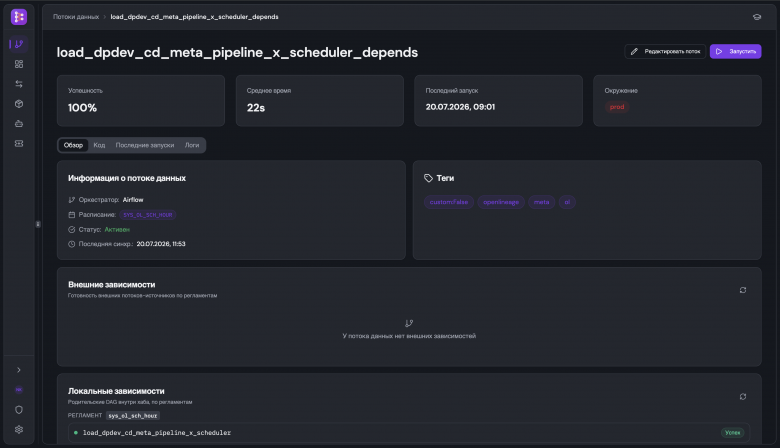
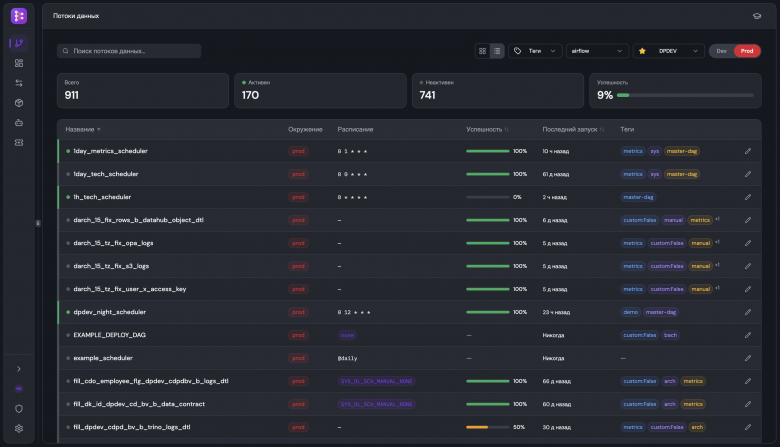
Мониторинг всех хабов в одном окне
Раздел «Потоки данных» агрегирует информацию со всех инстансов Airflow. Поэтому в одном табличном представлении теперь все DAG-и со всех хабов: название, окружение (dev/prod), расписание, успешность, последний запуск, теги. Фильтрация по хабу, окружению, тегам. Полнотекстовый поиск.
Из карточки конкретного DAG можно посмотреть историю запусков, развернуть логи по задачам и запустить DAG вручную. Всё без переключения в Airflow UI.
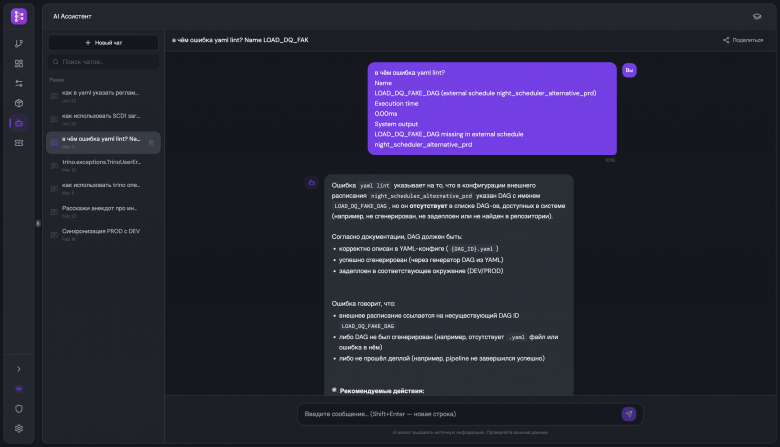
AI-ассистент
Для удобства добавили встроенный чат-бот на базе RAG. Теперь документация из Confluence автоматически индексируется в ChromaDB (векторная БД на pgvector). При вопросе находятся релевантные фрагменты, контекст отправляется в корпоративный LLM, а ответ возвращается со ссылками на источники.
Он подсказывает, как заполнить операторы, помогает генерировать SQL-запросы, объясняет существующие потоки, отвечает на вопросы по внутренним стандартам. Можно поделиться диалогом по публичной ссылке, что помогает онбордить новых инженеров.
Настройки и интеграции
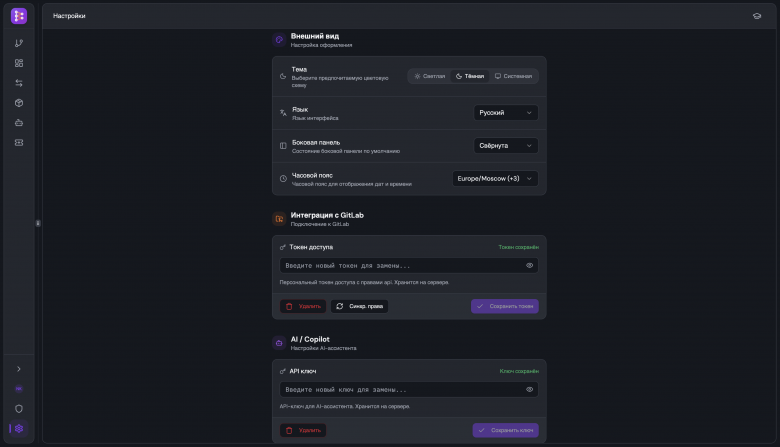
Все пользовательские настройки и интеграции собраны в одном месте. Можно указать GitLab-токен и синхронизировать права доступа. Кнопка «Синхр. права» запрашивает роли пользователя во всех GitLab-проектах и обновляет внутреннюю модель доступа. Также доступны настройки API-ключа для AI-ассистента, темы интерфейса, языка и часового пояса.
Управление миграциями схем данных
Управление DDL-миграциями — отдельная боль. Когда десятки команд создают и модифицируют таблицы в хранилище, конфликты неизбежны. Alembic и аналогичные инструменты заточены под одно приложение с одной БД. У нас же мультидвижковая среда (Trino + ClickHouse) и сотни разработчиков, которые параллельно вносят изменения.
Для решения этой задачи мы разработали DDL Migrator. Это Python-инструмент, который управляет миграциями CREATE/ALTER/DROP в мультидвижковой среде. Миграция – это пара SQL-файлов: up.sql (применение миграции) и down.sql (откат миграции).
Внутри файлов используются специальные комментарии:
-- CH
-- Маршрутизирует выполнение в ClickHouse (по умолчанию — Trino)
-- depend_on: migration_A, migration_B
-- Объявляет зависимости от других миграций
CREATE TABLE schema.my_table (
id BIGINT,
name VARCHAR
);
Управление зависимостями — ключевая фича
Из-за этого мы не стали использовать готовые инструменты, а написали свой.
Сильные зависимости объявляются явно через -- depend_on. Миграция не применится, пока все зависимости не будут в статусе applied. При откате удаление блокируется, если от миграции зависят другие миграции.
Слабые зависимости автоматически обнаруживаются через пересечение объектов. Если две миграции из разных команд модифицируют одну и ту же таблицу, система предупредит о конфликте до того, как кто-то сломает чужие данные.
Метаданные хранятся в трёх PostgreSQL. Уникальность определяется связкой (name, commit_hash), что позволяет повторно применить откатанную миграцию из нового коммита.
Интеграция с CI/CD
DDL Migrator запускается из пайплайна GitLab CI. При push в ветку новые миграции автоматически применяются в dev, при мерже в main — в prod. Атомарность на уровне шагов означает, что при сбое на одном из нескольких шагов не нужно разбираться, что откатить вручную: система сама всё разрулит.
Что дальше
Мы продолжаем развивать Bach и в ближайших планах у нас:
Интеграция DDL Migrator в интерфейс Bach, чтобы миграции тоже создавались из единого окна.
Расширение AI-ассистента: автоматическая генерация конфигураций операторов на основе описания задачи, подсказки при ошибках валидации.
Дашборды с метриками качества данных.
Интеграция стриминга.
miksoft
Добрый день! Где-нибудь можно получить больше подробностей? И, если возможно, хотелось бы больше скриншотов, в т.ч. для случая более-менее сложного потока, а не одного "кирпичика". Спасибо!