

Несколько лет назад мне захотелось заняться составлением своего генеалогического древа. Я опробовал различные существующие инструменты для этого и не могу сказать, что остался в большом восторге. Во-первых, у подавляющего числа из них интерфейс, мягко говоря, оставлял желать лучшего, а во-вторых, большинство из них подразумевало хранение информации о всех своих близких где-то на серверах этих сервисов (причём ряд из них сейчас вовсе недоступен напрямую из России, что удобства не добавляет).
Разумеется, как у любого уважающего себя разработчика, у меня зачесались руки написать собственное решение. Благо в целом задача не выглядела сверхмасштабной, ведь хранилище семейной истории — это по сути небольшая БД с 6-8 типами сущностей и визуализатором связей между ними. Но, как это нередко бывает, идея застряла на стадии раннего прототипа, и только сейчас, благодаря помощи LLM её удалось довести до относительно законченного вида.
Ниже расскажу, что получилось и чем же именно мой сервис — я назвал его Arca — существенно отличается от других подобных решений. Кроме особенностей хранения проектов также затрону несколько других любопытных нюансов — выбранный мной подход к локализуемому представлению имён, а также исторических названий городов и регионов.
Так что там с хранением
Как я уже упомянул, многие генеалогические сервисы, не сильно напрягаясь, хранят информацию о людях у себя в онлайн-базах. Альтернатива для тех, кого беспокоит приватность и сохранность данных, — десктопные приложения и хранение «деревьев» локально, у себя на жёстком диске. Это тоже не идеально: так мы теряем удобство синхронизации и совместной работы над одним проектом. Что же делать, если хочется и сохранить удобство «облачного» хранения, и обеспечить надлежащую защиту личной информации?
Решение, на мой взгляд, очевидное и достаточно простое — хранить проекты в облаке, но только зашифрованными личным ключом пользователя (который никогда не становится известен серверу). Подобным подходом пользуются, к примеру, такие инструменты, как менеджеры паролей. Однако именно среди генеалогического софта я не встречал подобных реализаций.
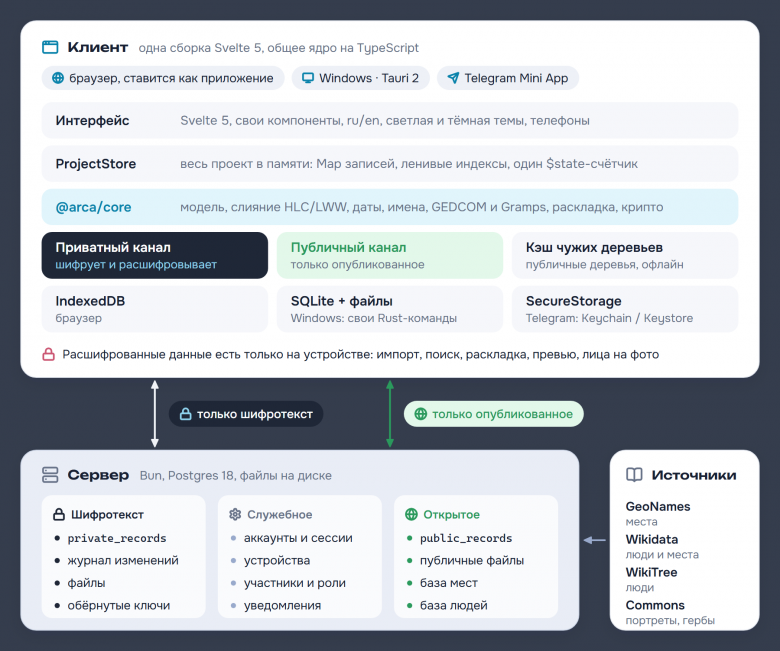
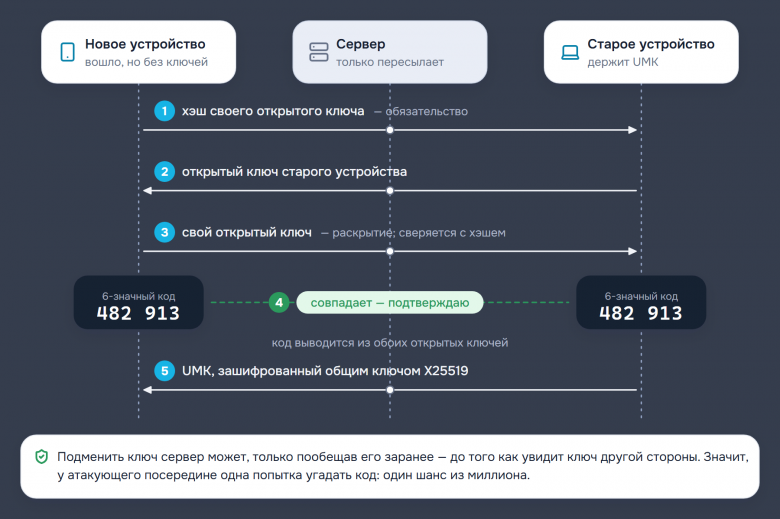
Как это устроено на практике? В Arca пользователь может создать локальный проект (даже без авторизации) — и он будет существовать только в его браузере. А может выбрать облачное хранение — тогда будет создан секретный ключ пользователя, а также отдельные ключи на каждый облачный проект, которым они будут шифроваться перед загрузкой на сервер. Если захотелось авторизоваться на новом устройстве — создаем end-to-end зашифрованный канал со старым устройством (если оно под рукой), и передаем ключ так, либо вручную вводим код восстановления (который позволяет расшифровать мастер-ключ). В любом случае сервер ключи пользователя не видит.
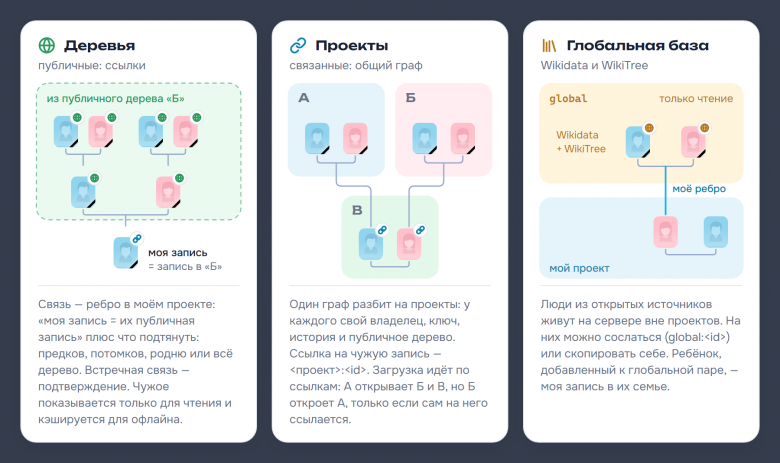
При этом возможность выложить часть своего дерева в публичный доступ тоже остаётся — например, информацию о давно умерших людях. Но это, разумеется, опционально. Если же нужно редактировать один проект с другими членами семьи — достаточно добавить их в участники проекта (т.е. поделиться ключом проекта). При удалении доступа ключ проекта ротируется, и последующие версии прежним участникам становятся не видны. А ещё, кстати, можно связать два проекта друг с другом (т.е. одна семья редактирует своё дерево, другая — другое, и они могут ссылаться на персон из обоих деревьев). Такого функционала я тоже нигде больше не видел.
Несколько слов про визуализацию
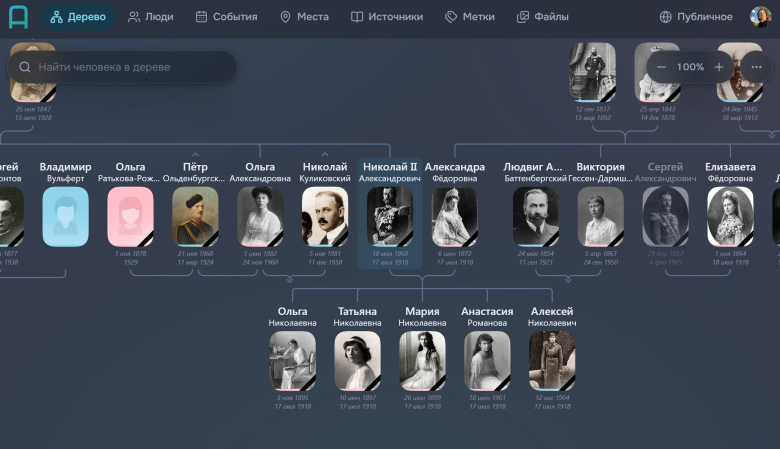
Кроме уникального подхода к хранению данных, мне хотелось добиться эстетичного внешнего вида самого дерева. Здесь я, например, обратил внимание, что в подобных деревьях нередко карточки отображаются горизонтально — слева фото, справа имя и годы жизни. А сами фото, куда ни ткни, либо круглые, либо квадратные.
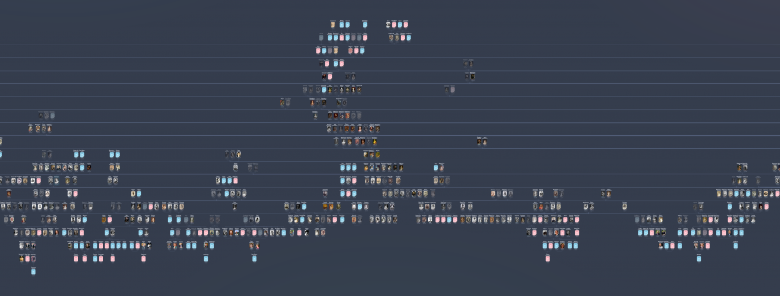
В то же время, если посмотреть на то, как «растут» реальные родовые деревья, видно, что места-то им нужно больше вширь, нежели ввысь. Именно поэтому свои карточки я сразу рисовал вытянутыми вертикально (да и фото у меня, «как в паспорте» — тоже портретные). Сверху имя, посередине фото, внизу годы жизни — ничего лишнего.
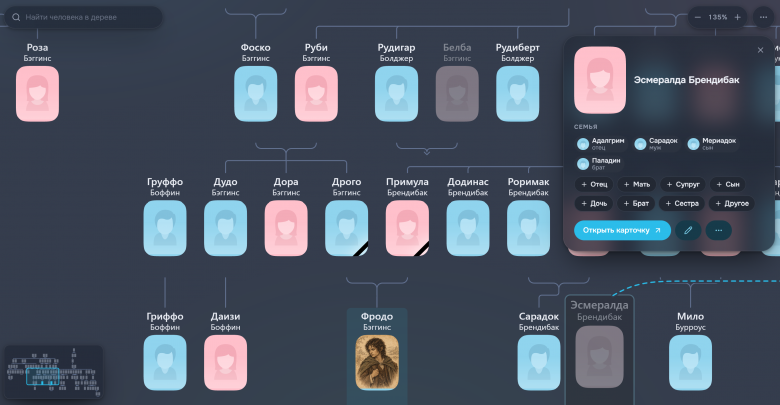
Построенные деревья можно как экспортировать в различные форматы (PNG, SVG, PDF, HTML), так и напечатать.
Раскладываем имена по полочкам
Ещё одна интересная задача, которую мне хотелось решить грамотно, — как одновременно предоставить возможность вводить разнообразную информацию о персонах и не перегрузить интерфейс миллионом полей.
Особенно этот вопрос был актуален для имён, которые в разных культурах и исторических периодах состояли из разного набора частей, и мне уж очень хотелось как-то покрыть это разнообразие (даже если это никому не понадобится), да ещё и адекватно реализовать их отображение на разных языках.
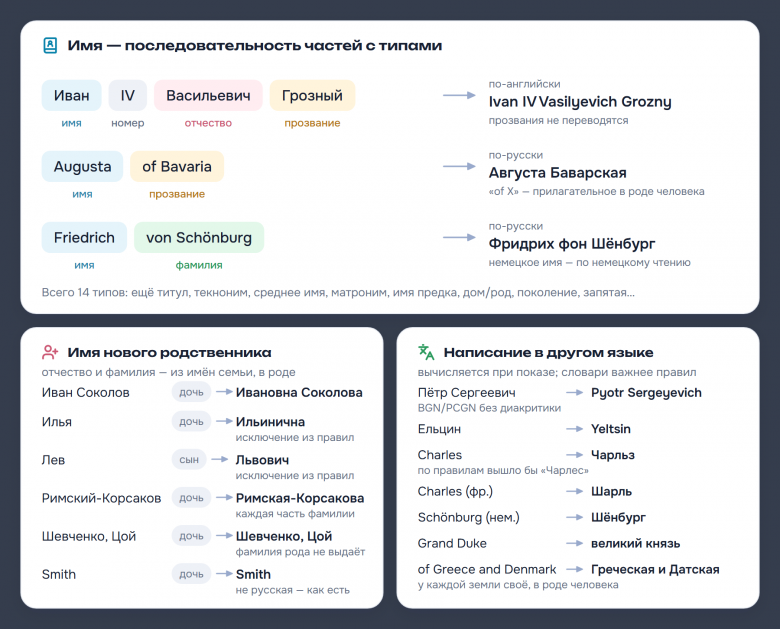
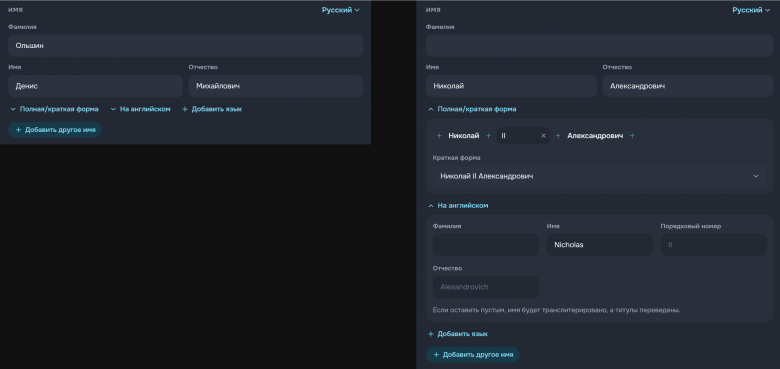
Решением стало хранить имена как произвольные последовательности компонентов — например, для русского это обычно «фамилия, имя, отчество», в ряде стран у людей могут присутствовать вторые имена (или даже вторые фамилии), но в интерфейсе можно создать любую цепочку компонентов и указать, чем каждый является. А чтобы при переключении интерфейса на другой язык имена тоже переключались правильно, для каждого компонента можно вручную задать его перевод.
Другие мелочи
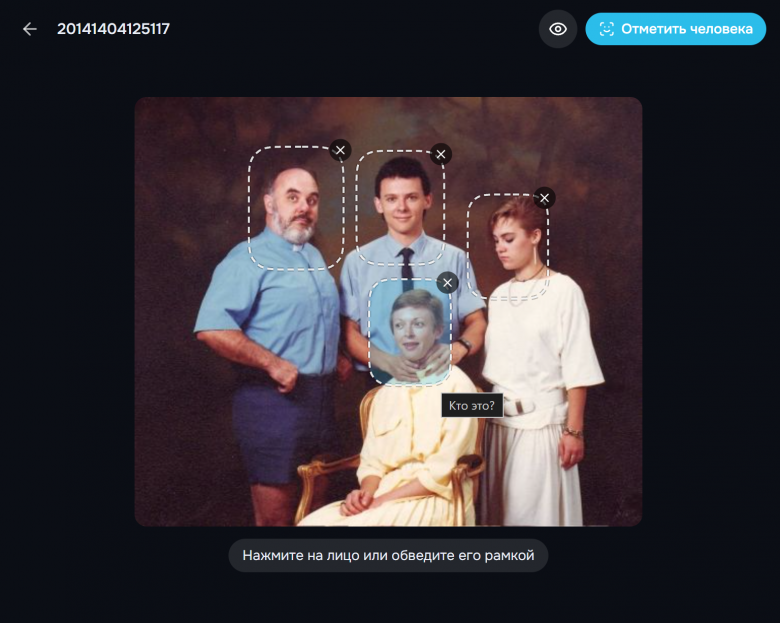
На этом мои личные хотелки не закончились. Например, далеко не в каждой генеалогической софтине удобно загружать семейные фотографии и отмечать на них людей. Я же решил, что это будет классно автоматизировать — по нажатию на «Отметить человека» прямо в браузере запускается небольшая модель через библиотечку face-api, которая довольно точно сама находит лица на фото. Приятный бонус: в дереве лица людей получаются расположенными чётко по центру, ровнее, чем если размечать вручную.
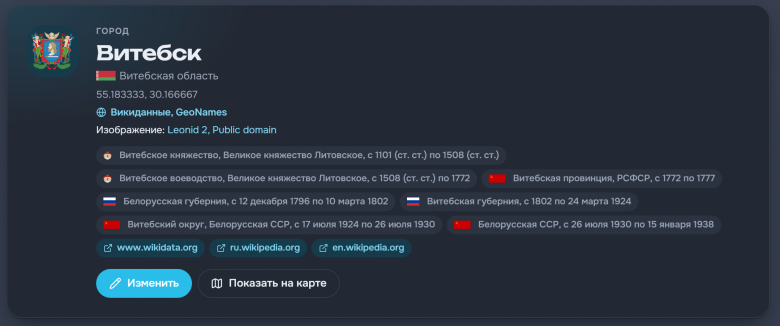
Или вот, скажем, города. Казалось бы, возьми любую стандартную базу городов и всего делов. Но если стоит задача работать с историческими данными, этого недостаточно. Поэтому из Wikidata подгружаются не только текущие названия мест, но и то, как они назывались раньше — а также то, каким территориям раньше принадлежали. Поэтому не удивляйтесь, если, указывая Петербург в качестве места рождения бабушек и дедушек, вы в результате увидите «Петроград» с красным флажком РСФСР.
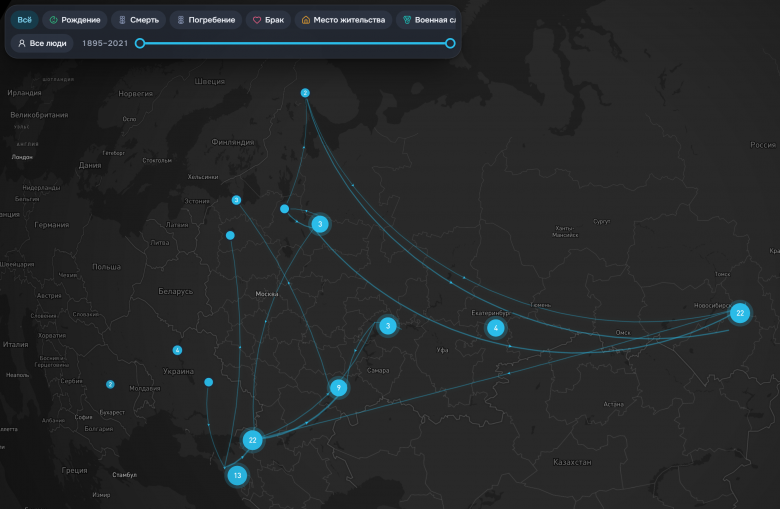
Ещё добавленные к событиям и фото места можно увидеть на карте — а заодно увидеть, как члены вашей семьи переселялись в течение жизни.
Это не всё, что умеет Arca: я добавил и поддержку произвольных меток, источников информации и их хранилищ, и удобный календарь событий (где легко увидеть ближайшие юбилеи), и проверку проекта на ошибки, и даже трекер задач (что вероятно будет полезно тем, кто серьёзно занимается генеалогией). А ещё, кстати, все изменения проекта логируются в истории проекта — с возможностью откатывать ошибочные изменения или добавлять пояснения, почему было внесено то или иное исправление.
Что дальше?
Сейчас Arca существует в виде веб-сервиса (в т.ч. адаптированного под просмотр с мобильных устройств), десктопного клиента для Windows и macOS, а также мини-приложения в Telegram. Возможно, соберу билд и для Linux.
В плане же функциональности мне кажется, что сервис близок к feature-complete продукту. В нём уже есть больше, чем я собирался добавить изначально. Пока что у меня есть идея лишь одного направления, куда можно было бы развиваться дальше — поскольку уже реализована возможность связывания нескольких независимых проектов воедино, то несложно представить поддержку self-hosted инстансов Arca, федерирующихся между собой. Это, с одной стороны, звучит слишком безумно для нишевого генеалогического приложения, а с другой — достаточно безумно, чтобы это действительно заслуживало реализации :)
predpremi
Прекрасно понимаю это жгучее желание написать свой софт, когда существующие решения не устраивают ни по интерфейсу, ни по подходу к хранению данных. Я сам много раз так начинал проекты, когда хотелось сделать «как надо». Вопрос приватности генеалогических данных, которые уходят на чужие серверы, действительно критичен - это боль многих пользователей. Применение LLM для ускорения разработки прототипа до рабочего состояния - это отличный пример того, как AI меняет подходы, я тоже активно использую их в своих проектах.