

Добрый день, меня зовут Петр. Обычно я не пишу статьи про баги и инциденты из своей практики, но сегодня хотелось бы описать изменение в ядре Ubuntu, которое может создать неприятный сюрприз в вашей инфраструктуре, разобрать его механизм, а в конце - немного порассуждать про общую тенденцию безопасности в 2026 году.
Кого касается?
Ubuntu 26.04 (или ядро с бэкпортом из 7.0.0-41+, включая облачные сборки вроде linux-aws и linux-azure);
kernel.apparmor_restrict_unprivileged_unconfined=1 (в 26.04 это значение по умолчанию);
containerd или Docker со стандартным AppArmor-профилем - то есть почти любой Kubernetes, k3s, RKE2 или Docker-хост.
Характерные симптомы
Операция kill: (…) получает Permission denied внутри контейнера при совпадающем uid и выключенном seccomp;
gosu (и любой Go-бинарь, вызывающий setuid) крутится на 100% CPU, но сервис не стартует и логов нет;
PostgreSQL: получает ошибку could not signal for checkpoint: Permission denied;
Сообщения в журнале ядра вида: apparmor="DENIED" operation="signal" … peer="cri-containerd.apparmor.d//&unconfined".
Типовой инцидент
Штатная ситуация: необходимо изменить ресурсы CPU и RAM на нод группе виртуальных машин в Kubernetes кластере. Запуск Terraform кода проходит штатно, машины поднимаются корректно, все замечательно. Однако несколько подов PXC (Percona Operator for MySQL) не могут стартануть. В логах стандартная просьба инициализировать процесс восстановления через команду:
kubectl -n pxc exec pxc-pxc-0 -c pxc -- sh -c 'kill -s USR1 1'
Однако, в ответ при выполнении получаем:
sh: line 1: kill: (1) - Permission denied
command terminated with exit code 1
Чего? Сначала исключаем очевидное. Shell от kubectl exec и PID 1 работают под одним uid 1001 (mysql), capabilities пустые у обоих, Seccomp: 0. По правилам Unix сигнал должен проходить.
kill -0 1 && echo "kill -0 1 OK" # OK
sleep 30 & kill $!               # Permission denied
cat /proc/1/attr/current         # cri-containerd.apparmor.d//&unconfined (enforce)
Чего х2? То есть, процесс получает Permission denied от своего же процесса? Отказ даже для собственного sleep навивает мысли об LSM (Linux Security Module).
Ладно, быстрым решением стало снятие AppArmor в CR PerconaXtraDBCluster:
spec:
  pxc:
    containerSecurityContext:
      appArmorProfile:
        type: Unconfined
Альтернатива без пересоздания пода - послать сигнал с самой ноды от root, найдя host-PID через crictl inspect. Стандартный профиль принимает сигналы от unconfined-отправителей - именно так kubelet и останавливает контейнеры.
Тем не менее, на этом движ не закончился: когда база поднялась, приложение так и не стало Ready, и перезапуск деплоймента не помог. Readiness-проба получала connection refused, kubectl logs был пуст. Первая гипотеза - приложение зависло на подключении к недоступной БД - отпала: после судорожного рестарта приложения на живой базе картина повторилась. Ладно, лезем в контейнер и фиксируем интересную картину:
PID     ELAPSED STAT %CPU COMMAND
      1       02:04 Rsl  95.6 gosu
В контейнере нет ни одного слушающего сокета в /proc/net/tcp, нет дочерних процессов, нет файлов в log/: вообще ничего нет.
Нормальный gosu живёт миллисекунды: он делает setuid и exec в приложение, так что PID 1 с именем gosu через две минуты - уже ненормально. Дальше те же проверки, что и для PXC:
lsm: cri-containerd.apparmor.d//&unconfined (enforce)
Uid:    0  0  0  0
Threads: 6          # один поток в R, остальные в S
sh: 1: kill: Permission denied
Поток в состоянии R - это тот самый цикл sched_yield в рантайме Go. Здесь пришлось переписывать весь Helm чарт, чтобы добавить аналогичные параметры, что и с PXC.
После 30 минут стресса захотелось понять, что произошло. Единственное, что изменилось после перезагрузки нод - это патч версия ядра. В эту сторону и будем копать.
Что произошло?
Регрессию принёсло исправление CVE в AppArmor из stable-патчсета 2026-10-05: оно изменило, когда профиль принудительно стакается. В changelog Ubuntu это строка CVE-2026-90231:
apparmor: fix unconfined user namespace restriction forced stack в блоке Resolute update: upstream stable patchset 2026-10-05 (LP: #2169638).
Примерная хронология событий следующая:
Дата |
Событие |
2025-02-11 |
apparmor 4.1.0~beta4-0ubuntu1 включает kernel.apparmor_restrict_unprivileged_unconfined=1 по умолчанию (containerd#14485) |
2026-10-01 |
Выходит linux 7.0.0-38.38 - последнее незатронутое ядро (ubuntuupdates) |
2026-10-15 |
Загрузка linux 7.0.0-42.42 в Resolute; в него входит changelog 7.0.0-41.41 с бэкпортом 08c2f7c8d4b1 (Launchpad) |
2026-10-28 |
7.0.0-42.42 публикуется в resolute-updates; в тот же день открыты LP #2172422 («Go programs livelock in setuid (gosu)») и containerd#14485 |
2026-10-29 |
Предложен фикс профиля containerd PR #14487 |
2026-11-01 |
Раннеры GitHub ubuntu-26.04 начинают ломать e2e с Postgres, MariaDB, CrowdSec (zeabur#254) |
2026-11-02 |
7.0.0-42.42 попадает в resolute-security — теперь его ставит и unattended-upgrades; первые аварии после перезагрузки нод (seichi_infra#6671) |
2026-11-06 |
7.0.0-43.43 в resolute-security, симптомы сохраняются; 7.0.0-44.44 в proposed |
2026–11-10 |
PR #14487 всё ещё не смержен |
Здесь есть небольшое расхождение в данных: часть отчётов называет первой плохой версией 7.0.0-41, часть проверяла только -42.
Как это работает?
Контейнер получает составную метку AppArmor, а правила стандартного профиля разрешают сигналы только для точного имени. Цепочка выглядит так:
В Ubuntu с февраля 2025 года включён параметр ядра kernel.apparmor_restrict_unprivileged_unconfined=1. Он мешает unconfined-процессу без CAP_MAC_OVERRIDE просто сменить профиль: вместо смены новый профиль накладывается стеком поверх unconfined
Коммит 08c2f7c8d4b1 (CVE-2026-90231) закрыл обход этого ограничения и стал применять принудительный стек и при exec.
runc сначала сбрасывает capabilities, потом делает exec в процесс контейнера. В результате каждый контейнер со стандартным профилем работает под cri-containerd.apparmor.d//&unconfined (в Docker — docker-default//&unconfined).
В шаблоне профиля containerd есть только signal (receive) peer=cri-containerd.apparmor.d и аналогичное правило для ptrace. Составная метка под них не попадает, поэтому ядро отказывает любому сигналу между процессами и даже потоками одного контейнера.
Схематично, механизм работает примерно следующим образом:
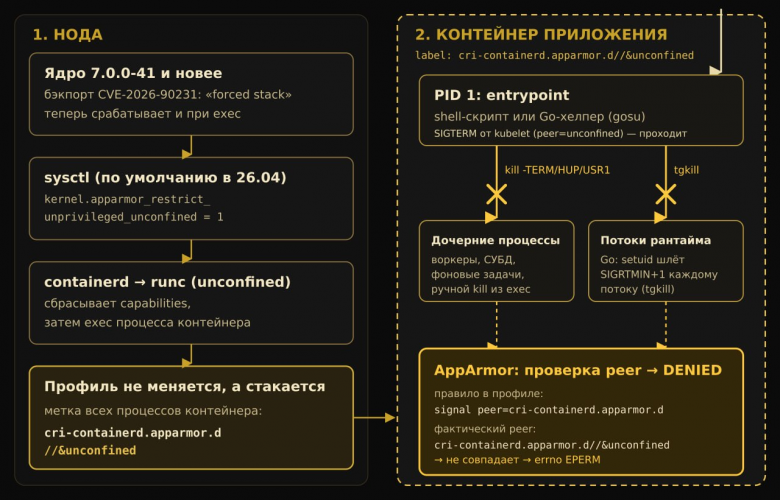
Отказ происходит в одной точке - в проверке peer. А дальше каждое приложение ломается по-своему. Например, Go просто висит: с Go 1.16 syscall.Setuid меняет uid сразу у всех потоков процесса. Рантайм (doAllThreadsSyscall) рассылает каждому потоку сигнал SIGRTMIN+1 через tgkill и ждёт ответа. AppArmor отклоняет tgkill, рантайм ошибку не проверяет и бесконечно вызывает sched_yield. Снаружи это PID 1 с именем gosu, один поток в состоянии R, 100% CPU - и никакого exec в приложение. Визуально в Kubernetes будет бесконечно в статусе 0/1 Running по Readiness пробам и без внятной информации, в чем проблема.
В треде Launchpad и в разборах других команд это считают намеренным изменением поведения, а не багом ядра: в -43 отката нет. Чинить нужно профиль containerd - именно это делает PR #14487, добавляя signal и ptrace для peer={{.Name}}//&unconfined.
Как проверить у себя?
Хватает пяти команд: три на хосте и две внутри любого контейнера.
На ноде:
uname -r                                                # 7.0.0-41 и новее - вы в зоне риска
sysctl kernel.apparmor_restrict_unprivileged_unconfined # = 1 — вы в зоне риска
journalctl -k | grep -i 'apparmor="DENIED".*operation="signal"' | tail
Внутри контейнера (нужен только sh):
cat /proc/self/attr/current        # ...//&unconfined (enforce) — метка составная
sleep 30 & kill $! && echo OK      # Permission denied - вы уже затронуты
Как чинить?
Лучший вариант - исправить профиль containerd на хосте: AppArmor и hardening остаются включены, а приложения не нужно трогать. Остальные способы быстрее, но чем-то жертвуют.
Способ |
Что делает |
Цена |
Где применили |
Профиль на хосте |
Загрузить копию cri-containerd.apparmor.d с правилами для //&unconfined |
Нужно разложить на все ноды и убрать после фикса в containerd |
|
sysctl …unconfined=0 |
Возвращает старое поведение перехода профиля |
Отключает hardening на всём хосте, связанный с CVE-2026-90231 |
|
Откат на 7.0.0-38 + hold |
Убирает саму регрессию |
Нет CVE-фиксов из -41+; легко случайно обновиться обратно |
|
appArmorProfile: Unconfined на под |
Снимает AppArmor с конкретного контейнера |
Поштучно, требует PodSecurity privileged; чарт должен уметь это поле |
Мы (PXC, Redmine), OneUptime |
Выводы
security-обновление ядра изменило поведение так, что ломается не ядро и не контейнерный рантайм, а их стык. Симптомы при этом специфичны для каждого приложения и на общую причину не указывают. Если вам интересно - рекомендую прочитать разборы и аварии других команд:
seichi_infra #6671 - после перезагрузки kured на -42 легли mariadb и игровые серверы, простой около 7 часов (на японском, самый подробный разбор)
zeabur #254 - три условия срабатывания и профиль-копия для K3s/RKE2
stardelt-platform #445 - Postgres и ingress-nginx, кластер лёг
AutomatosAI #1401 - PostgreSQL в k3s, фикс через sysctl
henrybro64 #308 - PostgreSQL и gosu после перезагрузки
runs-on #116 и galaxy PR #24694 - сломанный CI на раннерах Ubuntu 26.04
OneUptime PR #6418 - Unconfined для e2e-ворклоадов
ZetaTwo infrastructure #2 - фиксация ядра на -38
nix-fleet PR #86 - исправленный профиль containerd для k0s
Официальные трекеры:
linux 7.0.0-42.42 на Launchpad - changelog с CVE-2026-90231: apparmor: fix unconfined user namespace restriction forced stack (LP: #2169638)
LP #2172422 - Go-программы зависают в setuid (gosu), статус Confirmed, фикса нет
containerd issue #14485 - открыт 28.10.2026
containerd PR #14487 - фикс профиля, не смержен
moby issue #54099 - то же для docker-default
k3s issue #13625 - ранний отчёт об отказах SIGURG при стекинге профилей
Послесловие: что эта история говорит о безопасности в 2026 году
В конце, в качестве послесловия, хотелось бы немного порассуждать на тему безопасности в целом.
Наш инцидент - маленькая модель всего 2026 года. Исправление CVE было корректным и осмысленным, обновление пришло через все проверки, как и должно. Но в итоге этот патч безопасности превратился в инцидент доступности и чтобы быстро его потушить, мы выключили MAC на базе данных. Замкнутый круг: фикс безопасности → авария → ослабление безопасности. И похоже, такие круги стали нормой. Причина этому - злосчастный ИИ:
Объём перестал быть посильным для людей. За 19–20 июля ядро Linux опубликовало 432 CVE - при обычных пятидесяти в неделю в 2025-м. В апреле NIST официально перестал анализировать в NVD всё, что не входит в KEV и федеральный список, а Торвальдс назвал закрытую security-рассылку ядра «почти полностью неуправляемой» (Noze). Заметная часть потока - находки ИИ-систем, и CSA называет это «точкой перегиба, а не продолжением тренда» (CSA).
Эксплойт стал быстрее патча. По DBIR 2026, эксплуатация уязвимостей впервые стала главным вектором первичного доступа, а медианное время полного устранения выросло до 43 дней (Zafran). M-Trends 2026 оценивает среднее время до эксплуатации в минус семь дней - атаки начинаются до выхода фикса (цитата по CSA).
Сами фиксы стали чаще ломаться. Terra Security посчитала: в 2019–2025 годах лишь 0,2% security-фиксов на GitHub получали в течение 90 дней повторный advisory о нерабочем патче, в 2026-м - 2,3%. В ядре 3,2% CVE внесены исправлением другой CVE, а в горячих подсистемах вроде net/sched — около 10% (The Register). Описаный мной случай формально не "сломанный фикс", но из той же оперы: патч изменил поведение, а экосистема за ним не успела - PR в containerd две недели ждёт ревью.
Можно попытаться найти позитив: удвоение объясняется не только ИИ, но и автоматической выдачей CVE в open source. Из примерно 5 000 CVE ядра за январь-август ни одна не была эксплуатируемым 0-day.
Дает ли это надежду на расслабление? Нет. Разбирать CVE ядра по одной уже невозможно, поэтому ядро берут целиком, потоком stable-обновлений. Но вместе с сотнями никем не эксплуатируемых исправлений в этом потоке приезжают и изменения поведения вроде CVE-2026-90231. Теперь угроза инфраструктуре перешла из категории "ой, не успели запатчить ядро" в "ой, запатчили ядро и не заметили, что уронили прод".
Класс, нагнали жути. А что это все значит для рядового инфраструктурного инженера на практике?
Теперь обновление ядра - это релиз, а не фоновая задача. Автоматизация перезагрузок и накатки обновлений нужна, без неё поток патчей не переварить. Но в ней должны быть канареечные релизы, тесты на dev стендах и поведенческие проверки приложений, а не только то, что ноды поднялись.
При аварии ослаблять защиту точечно и со сроком. sysctl=0 на всём или откат на ядро без CVE-фиксов - это обмен одного риска на другой, просто менее заметный. Каждое исключение - с обоснованием, компенсирующим контролем и датой истечения.
Редкие пути кода ломаются первыми. Работающий сервис может неделями жить на новом ядре, пока не понадобится перезапуск, восстановление или graceful shutdown и тут вас может ждать сюрприз. Такие сервисы нужно прогонять регулярно.
Следить не только за CVE, но и за регрессиями. Первые сигналы про эту историю появились в Launchpad и GitHub за недели до нашей аварии. Если бы мы со своей стороны прочитали статьи на эту тему заранее - избежали бы аварии. Рассылка по ключевым компонентам (ядро, рантайм, операторы БД) дешевле любого простоя.
Безопасность в 2026 году перестала быть вопросом "успели ли мы поставить патч за неделю". Теперь это вопрос того, умеет ли инфраструктура переваривать постоянный поток изменений, иногда ломающих, и при этом не расплачиваться за доступность самой защитой. Теперь скорость обновления без умения быстро заметить и откатить сломанное - это просто быстрая доставка аварий на прод.