Небольшая ретроспектива о том, как менялся мой подход к разработке в 2026 году. Описывается опыт знакомства с harness, его применение в верстке, бекенде и работе с графическим редактором Penpot. Ответ на вопрос — как разрабатывать без нейрослопства используя спецификации.
FOMO
Недоверие
Преодоление непонимания
Перевод контента
Spec-Driven Development
SDD на примере модуля Битрикс24
JS-расширение Vue SPA
Модуль Битрикс24
Дизайн и прототипирование
Сайт генеалогического древа
Заключение
FOMO
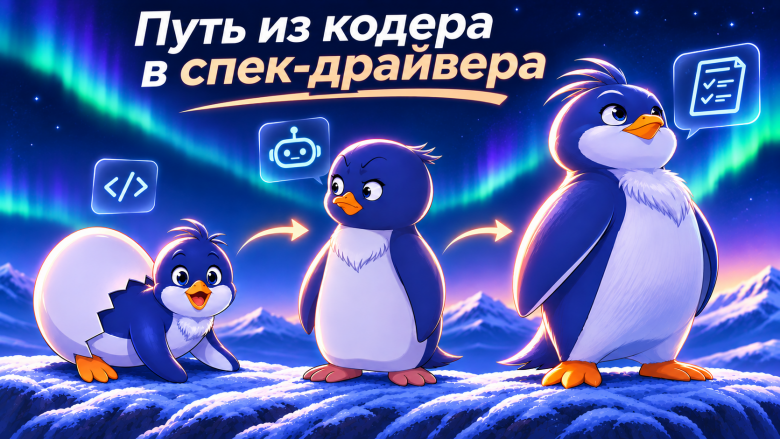
2026 год изменил мой подход к разработке и отношение к ИИ-инструментам на 180 градусов. Хочешь этого или нет, постоянно прорываются сюжеты про использование искусственного интеллекта и попадают прямо в мозг, раздражая и без того неспокойную голову разработчика.
Сомнения в себе, тревожные расстройства и сам инстинкт выживания толкают разработчика на поиск информации о применении искусственного интеллекта. Освободившись от рабочих задач, неизбежно бежишь ставить эксперименты с нейросетью. С этого момента растет ощущение, что упускаешь что-то важное, все уже делают что-то грандиозное, а ты еще не разобрался, как это устроено.
У этого ощущения есть название — FOMO (fear of missing out), страх упустить что-то важное или страх упущенной выгоды. Бесконечные новости о подвигах нейросетей превращают его в борьбу за выживание.
Работая с нейросетями, я безжалостно экономил — можно сказать, жадничал, пользуясь лишь синим чатом добрых китайских товарищей. Иногда поигрывал с триальными версиями Cursor, Trae и прочими, но ничего серьезного. Постоянно утешал себя мыслью, что мне это не нужно. Стремился разбираться во всем сам, не гадать и не вайбкодить, чтобы ни у кого не было сомнений, кем я являюсь.
Недоверие
Появилась задача, от которой заскрипели зубы. Переписать фронтенд своего же приложения с React на ванильный JavaScript. В команде React не использовали, но я рассчитывал, что ради готового результата сделают исключение. Расчёт не оправдался, пришлось переписать на чистый JavaScript. Кажется, ничего сложного, но сам факт существования этой задачи терзал и выводил из себя.
Я написал довольно много кода, используя чистый JavaScript, но признаюсь, это был не лучший код. Переключившись на фронтенд-фреймворки, мне так понравилось ограничение контекста в компонентном подходе и простота динамических шаблонов типа JSX, что возвращаться к императивному стилю построения интерфейса и обвешивания его обработчиками совершенно не хотелось.
Перед стартом кропотливой работы я решил попытать счастья и поставил Cursor. Попросил переписать приложение на чистый JavaScript в одном файле и указал директорию с исходным кодом. После череды правок, постоянно сверяясь с оригиналом, был близок к цели, но закончились бесплатные лимиты.
Стал пытаться доработать самостоятельно. Потратив какое-то время, понял, что я не могу понять код, трудно улавливать взаимосвязи и это точно невозможно поддерживать.
Снова отложил посвящение в адепты вайб-кодинга, размял сведённую челюсть и принялся за работу.
Завершив задачу, стал лучше, опытнее и злее. Однако, опыт с Cursor толкал меня на поиск более эффективного метода разработки. Чтобы быстрее погрузиться в тему искусственного интеллекта, решил посетить конференции, которых на ближайшее время было запланировано немало. Послушав спикеров и остальных, убедился в полном отсутствии понимания организации разработки с ИИ.
О своих впечатлениях от увиденного я написал в отдельных статьях.
Агенты везде. Разработчики в опасности…
AI Dev Day — AI лихорадка продолжается
Преодоление непонимания
Кстати, ко мне обратились с задачей организовать многоязычность и выполнить полный перевод сайта. Звучит как типичная задача, но мне никогда не приходилось выполнять такую работу. Я не переводчик, поэтому задачу по переводу контента сразу запланировал делать через какой-нибудь сервис автоматического перевода и не ожидал возникновения трудностей. Основные усилия направил на расширение существующей схемы данных и разработку автоматизированной системы перевода контента.
Проект на Wagtail. Экосистема расширений CMS Wagtail включает еще более объемную экосистему Django. Решений для многоязычности много, не считая встроенных в Django утилит. Все имеют свои преимущества и недостатки. Самым простым вариантом было добавить поля для переводов прямо в существующие модели. Но мне захотелось решения на любое число локалей, поэтому я решил завести для каждой модели отдельную модель с переводами. Рассчитывал на простую интеграцию в существующий код, чтобы ничего не сломалось. Но просчитался.
Разработка шла уверенно до момента, пока не появилась необходимость переопределить класс из стороннего пакета django-taggit. Стал мудрить, избегать вмешательства в код расширения и получил огромную дозу облучения собственными рассуждениями. К тому времени я уже сильно отставал по срокам, и чувство ответственности стало придавливать к полу.
Ни шагу назад! Когда тело перестало слушаться, мозг подкинул идею: если я не понимаю, как сделать задачу, а каждая новая попытка только усиливает тревогу, но не приносит результата, то почему бы не попробовать решить её с помощью нейросети? И я попробовал. И у меня получилось. За несколько часов я решил то, что занимало все мои вечера и выходные дни последнее время. С этого момента я на системе.
Перевод контента
Я рассмотрел несколько сервисов автоматического перевода и для этой задачи выбрал один из них. В работе столкнулся с двумя проблемами.
Неполный перевод
Контент, который я заворачивал в запрос, содержал HTML-разметку. Выбранный API поддерживал перевод текста с HTML-разметкой. Нужно было указать в объекте запроса опциональный параметр, и система сохраняла теги с атрибутами в исходном состоянии, переводя лишь заключенный в них текст.
Настроив и протестировав систему, запустил перевод всего контента. На перевод порядка 1000 статей потребовалось около 20 минут, и я довольный переключился на другие подзадачи. Когда решил проверить переводы, ужаснулся: в готовом переводе длинных материалов не хватало части текста.
Отсутствие поддержки правил перевода
Пользуясь сервисом, я не нашел инструкций по применению исключений, правил для определенных слов и терминов. Тематика текстов была специфичная и для корректного перевода требовалось применять общепринятые правила для этой темы. Некоторые фразы и названия переводить вообще не требовалось. Сервис переводил весь текст самым банальным образом и напрочь лишал его смысла.
В поиске решения возникших трудностей, уже имея успешный опыт преодоления непреодолимых препятствий, я решил попробовать выполнить перевод через LLM.
У языковых моделей тоже был предел на объём текста. Я добавил в адаптер поле для системного промпта и разбил длинные запросы на части, чтобы укладываться в лимит и сохранять целостность HTML-разметки.
В системном промпте указал тематику текстов, словарь исключений и непереводимых терминов. В процессе тестирования все обнаруженные ошибки обрабатывал и обновлял системный промпт, пока не получил приемлемый результат.
Когда я закончил перевод контента, стало очевидно, что текст требует вычитки профессионалом. Я плохо разбираюсь в тематике подопытного сайта и далек от переводов. Поэтому предложил заказчику самостоятельно выполнить вычитку, а чтобы ему было удобнее, в два приседания сгенерировал интерфейс вычитки. Интерфейс содержал области для редактирования: справа — исходный текст, а слева — перевод. Заказчик был доволен, а мне не потребовалось потратить несколько дней на разработку интерфейса — время, затраченное на задачу, исчислялось минутами.
Задача выполнена, все довольны, всем спасибо.
Пример метода, который объясняет переводчику политику партии.
def _get_html_prompt(
        self,
        html: str,
        source_lang_name: str,
        target_lang_name: str,
    ) -> str:
        """Build prompt for HTML format translation (detailed body translation with full glossary)."""
        if self.custom_prompt:
            return self.custom_prompt.replace('{{TEXT}}', html)
        return (
            f"Переведи HTML-контент с {source_lang_name} на {target_lang_name} для "
            "коллекционного каталога винтажных виниловых проигрывателей.\n\n"
            "⚠️ HTML: теги, атрибуты и их порядок не трогай — меняй только текст внутри тегов.\n\n"
            "? ГЛОССАРИЙ:\n"
            "- Turntable → Проигрыватель винила (НЕ вертушка)\n"
            "- Platter → Диск (НЕ тарелка)\n"
            "- Tonearm → Тонарм\n"
            "- Cartridge → Картридж / звукосниматель\n"
            "- Stylus → Игла (НЕ стилус, НЕ иголка)\n"
            "- Headshell → Шелл\n"
            "- Counterweight → Противовес\n"
            "- Anti-skate → Антискейтинг\n"
            "- Plinth → Плинт / основание\n"
            "- Dust Cover → Пылезащитная крышка\n"
            "- Mat → Мат\n"
            "- Spindle → Шпиндель\n"
            "- Belt → Пассик\n"
            "- Idler Wheel → Ролик\n"
            "- Direct Drive → Прямой привод (НЕ директ-драйв)\n"
            "- Belt Drive → Пассиковый привод\n"
            "- Wow and Flutter → Детонация и плавание скорости\n"
            "- Rumble → Рокот (НЕ гул)\n"
            "- Tracking Force → Прижимная сила\n"
            "- Phono Stage → Фонокорректор\n"
            "- MM / MC → MM / MC (сохраняем)\n"
            "- 33⅓ / 45 / 78 RPM → 33⅓ / 45 / 78 об/мин\n\n"
            "? БРЕНДЫ И МОДЕЛИ (НЕ переводить): Thorens, Garrard, Linn, Rega, Technics, "
            "Pioneer, Dual, Lenco, SME, Ortofon, Shure, Audio-Technica, Denon, Micro Seiki, "
            "Sansui, Transcriptors, Michell, VPI, Clearaudio, Koetsu, Lyra.\n\n"
            "? СТИЛЬ: профессиональный, экспертный, продающий; живой язык без канцеляризмов; "
            "подчёркивай уникальность (ручная сборка, состояние, серийники).\n\n"
            "? ИЗБЕГАЙ: 'вертушка', 'тарелка', 'стилус', 'иголка', 'директ-драйв', "
            "'вау и флаттер', 'гул', 'фоно-стейдж'; не переводи бренды и модели; не теряй HTML-теги.\n\n"
            "HTML для перевода:\n"
            f"{html}"
        )
Spec-Driven Development
Практика показала, что код, над которым я корпел неделями, достаётся из нейросети за несколько минут. Поддержка даже собственного кода не всегда идет легко, особенно спустя время. Поэтому, отступив от архаичных верований, я встал на путь вайб-кодинга, заключив сделку с совестью на 20 условных единиц.
В начале исследования было установлено, что на простой запрос для сложного проекта нейросеть может «нафантазировать» всякого, что не всегда соответствует ожиданиям. Чтобы снизить риск выпадания из требований задачи сообществом активно продвигается концепция Spec-Driven Development (SDD) — разработка на основе спецификации.
Тема актуальная и обсуждаемая, устоявшегося определения концепции не существует. Ещё в октябре 2025 года автор популярных книг по разработке Мартин Фаулер опубликовал в своем блоге статью авторства Биргитты Бёкелер:
Understanding Spec-Driven-Development: Kiro, spec-kit, and Tessl, Birgitta Böckeler
Автор рассматривает три инструмента, реализующих свои интерпретации концепции SDD. До работы над статьей мне данный материал не встречался. Поэтому я просто следовал интуиции. Мой принцип создания спецификации предельно прост. Об этом хочу рассказать на примере следующей задачи.
SDD на примере модуля Битрикс24
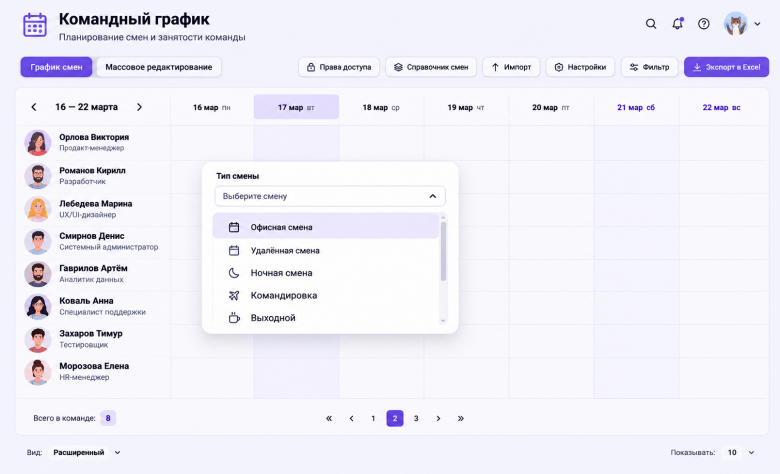
Подвезли задачу — разработать модуль для Битрикс24, чтобы составлять график смен и рассчитывать затраты на оплату труда за выбранный период. Заказчик передал примеры таблиц Excel без данных сотрудников, дизайн-макет компонентов интерфейса и короткие комментарии к основным сценариям.
Главный завет современного разработчика — следить чтобы чувствительные данные не протекали. Поэтому для разработки развернул чистый Битрикс24 на отдельном виртуальном сервере. Агент работал с кодом модуля в отдельном Git-репозитории и запускал проверки на тестовом стенде. А в рабочий проект изменения переносил небольшими Git-патчами.
Проект заказчика, код нейросети, а отвечать за проблемы мне. Поэтому важно было видеть что меняется, и понимать, как работает код.
Открыл в директории проекта harness — программную обвязку, которая даёт языковой модели инструменты для работы с файлами и запуска команд. Попробовал несколько таких инструментов, но фаворита пока не выбрал.
Начал с консультации. По ходу разговора всплыли вопросы, о которых вначале не подумал. Ответы легли в спецификацию вместе с требованиями, ключевыми сценариями и техническими ограничениями.
Для работы с данными использовать D7 ORM.
Бэкенд писать без сторонних библиотек.
Оформить Vue SPA как JS-расширение. Использовать BX.Vue3, без включения Vue в сборку.
Компонент Битрикс использовать только для подключения расширения.
Заодно определили порядок работы. Дизайн уже был, поэтому начал с вёрстки. Дальше ставил задачи по одной. Агент предлагал план или сразу показывал результат, сверяя его со спецификацией. Когда по ходу работы менялось решение, обновляли и спецификацию. Если после проверки всё устраивало — git commit. Если нет, уточнял задачу и пробовал снова.
JS-расширение Vue SPA
Наивно полагал, что со спецификацией получится сделать всё одним запросом. Первые генерации во многом разошлись с ожиданиями, зато подсказали, с чего начать.
Агент не видел дизайн-макет, поэтому я начал описывать его по частям. Сначала взялся за кнопки. Общие компоненты сложил в папку Common, а агент внёс эту договорённость в спецификацию. По описанию он писал код, а детали доводил я сам в погоне за pixel perfect.
После первых нескольких компонентов уже сложился набор CSS-переменных для цветов, шрифтов и тем. На этой основе перешёл к более крупным компонентам, а затем к главному элементу приложения — интерактивной таблице. Описывал её по частям, от шапки и заголовков столбцов до фиксированного первого столбца с именами сотрудников. Когда компонент разрастался, просил вынести отдельные части в свои файлы.
Постепенно интерфейс стал похож на согласованный дизайн. Чем больше готовых компонентов было в Common, тем реже приходилось править внешний вид руками.
Пока бэкенда не было, интерфейс брал данные из JSON-файлов в public. Все запросы шли через одну точку, поэтому для подключения бэкенда хватило заменить заглушку вызовами BX.ajax к тестовому стенду.
Модуль Битрикс24
Каркас модуля агент собрал по образцу другого модуля Битрикс. Код появлялся быстрее, чем его удавалось прочитать, поэтому попросил разнести его по классам и пространствам имён. В lib получилась структура, знакомая многим CRUD-мейкерам.
В Controller — обработчики запросов, в Service — бизнес-логика, в Entity — ORM-сущности, в Agent — классы для фоновых задач. А в Helper — всё, чему пока не нашлось места.
После первых багов понадобились проверки, которые агент мог запускать сам. Для начала хватило небольших наборов тестов под отдельные задачи и загрузочного скрипта, который подключал ядро Битрикс. Так можно было проверять код модуля в окружении, где он будет работать. Если тестов станет больше, можно будет подключить PHPUnit или Pest, но мне это не потребовалось.
По ходу работы пригодился AGENTS.md. В нём удобно указать, где искать спецификацию, какие ограничения учитывать и как запускать проверки. Пусть это будет короткий путеводитель по проекту со ссылками на нужные файлы, так как агент будет заглядывать в него в каждой сессии и занимать драгоценные токены контекста.
Дизайн и прототипирование
Разработка не всегда начинается с кода. Иногда сначала нужно разобраться, как будет устроен интерфейс. Для работы с макетами часто используют Figma. Она работает в браузере, предлагает встроенные ИИ-инструменты и позволяет подключить внешнего агента через MCP. На бесплатном тарифе действуют ограничения на ИИ-функции и часть вызовов MCP. Тарифы Figma, лимиты Figma MCP.
MCP (Model Context Protocol, протокол контекста модели) — открытый протокол, через который ИИ-приложения подключаются к внешним инструментам и источникам данных.
Я люблю экономить и когда-нибудь, наверное, напишу трактат о жадности, но не только экономия заставила искать альтернативу привычному приложению. Я уже был ранее знаком с self-hosted приложением Penpot, который с рассветом ИИ предложил бесплатный MCP сервер без необходимости что либо устанавливать. Достаточно включить в настройках и вставить ссылку в harness. Он сам все подключит.
Сайт генеалогического древа
С генеалогией раньше дела не имел, поэтому, когда ко мне обратились за разработкой сайта об истории семьи, начал со схемы базы данных. Вместе с нейросетью постепенно уточнили таблицы, поля и связи. В итоге получился набор SQL-команд для создания схемы (DDL).
Для разговора с заказчиком нужна была структура будущего сайта. Нейросеть предложила её на основе схемы базы данных. Внёс свои правки, отправил заказчику, а он добавил то, что я упустил.
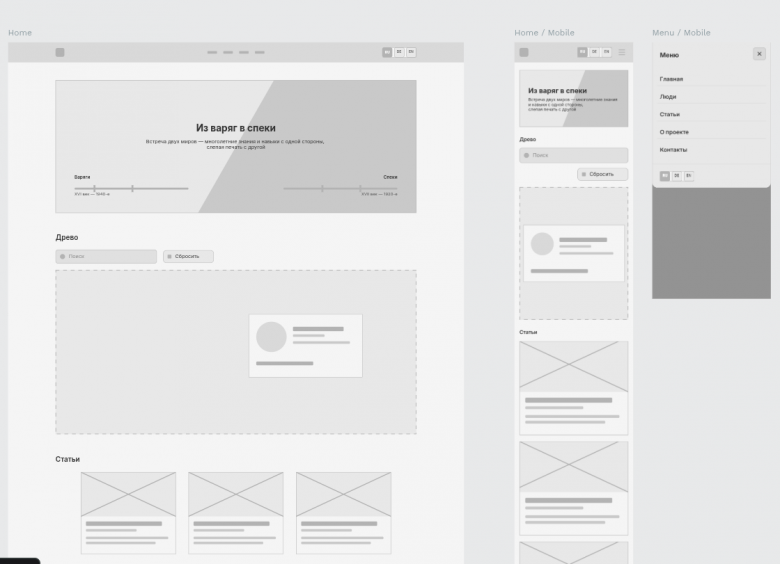
Я перепробовал множество инструментов для прототипирования, но проще и лучше делать рядом с дизайном. Попросил агента сделать прототип главной страницы из серых блоков, а все повторяющиеся элементы вынести в компоненты. Экран за экраном я собрал всю структуру сайта. Сначала версия для ПК, а затем на ее основе — мобильная.
Когда прототипы были готовы попросил сделать скриншоты и вставить в файл со структурой. Так я получил единый проектный документ с описанием и визуализацией каждого экрана. Осталось сконвертировать из Markdown в PDF и отправить на согласование.
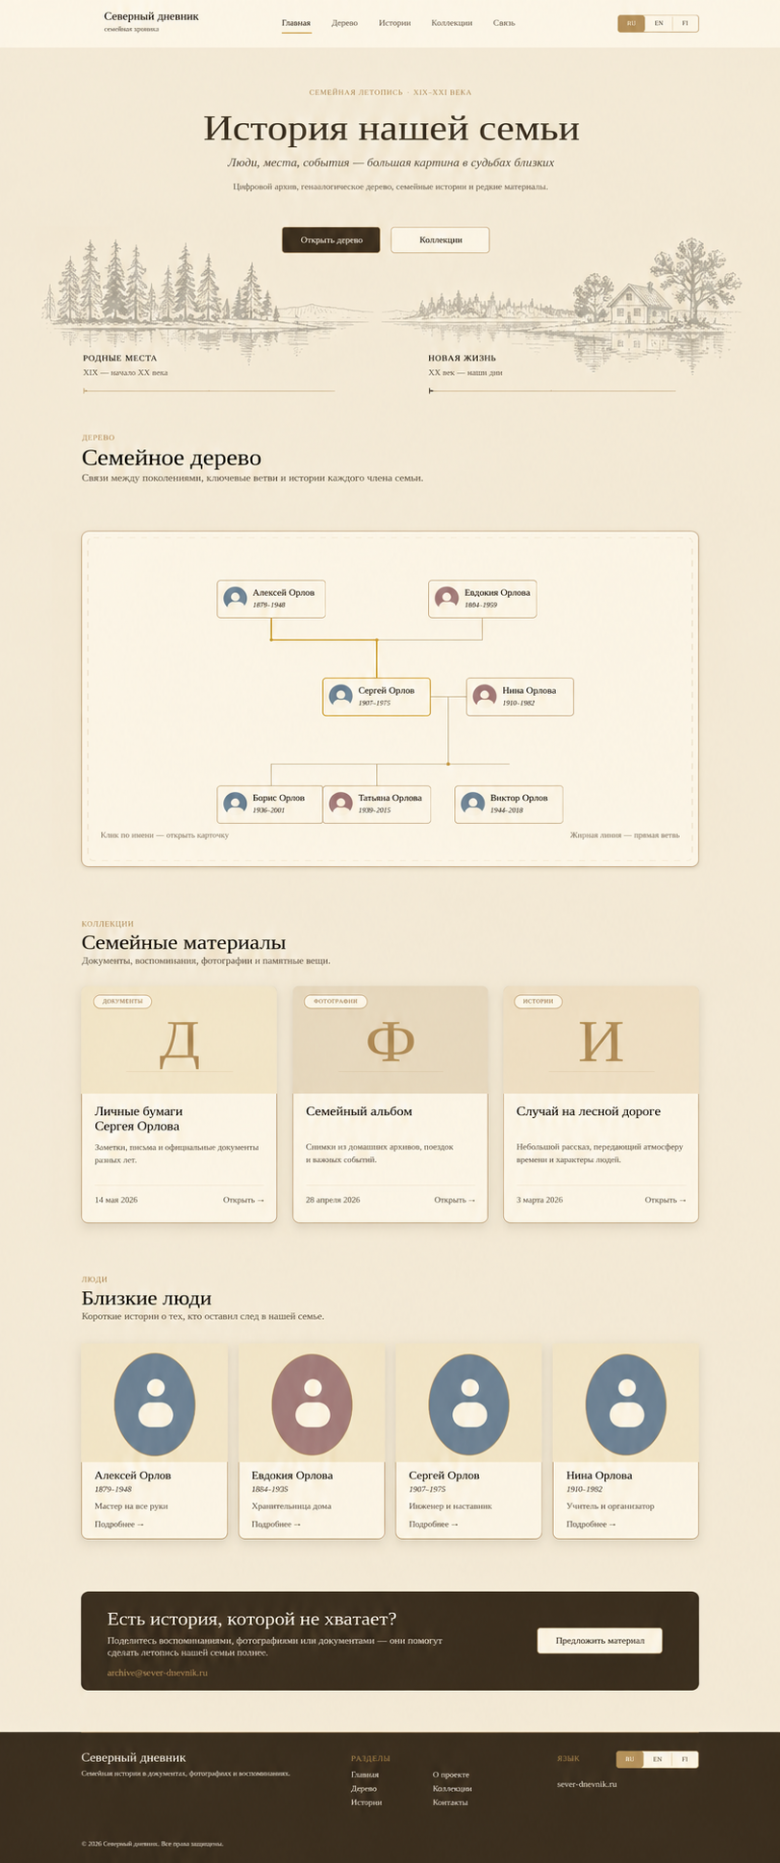
Пришло время поработать с дизайном. Описал какие цвета, шрифты и общее настроение хочется видеть в макете. С палитрой и шрифтами нейросеть справилась по текстовому описанию, а композицию и отступы ещё предстояло доработать. Принятые решения попросил фиксировать в спецификации, чтобы опираться на неё дальше.
Вот так и нагенерировал дизайн-макет — слепой печатью и хриплым голосом, почти не притронувшись к интерфейсу. Шедевра, конечно, не вышло, а нейрослоп ещё придётся вытравливать. Зато первую версию макета удалось собрать через чат, даже с моим скромным знанием программы Penpot.
Заключение
В заключение хочется отметить, что мир разработки перевернулся, но не рухнул. Получить от нейросети готовый результат с первого раза у меня так и не получилось. Вероятно, я отстаю от трендов, но ошибки, неточности и галлюцинации происходят регулярно.
В 2026 году я прошёл путь от тревожного FOMO до Spec-Driven Development в продакшене. Пришло понимание: работа с ИИ-агентом требует отдельного навыка, но не подменяет знаний и накопленного опыта.
Главное, что я вынес: нейросеть не отменяет необходимости разбираться в проекте, а делает её острее. Я по-прежнему отвечаю за проект перед заказчиком, и если я не понимаю сгенерированное, то не смогу ни поддерживать, ни защитить, и главное — мне будет трудно рассуждать о проекте и генерировать новые идеи. Поэтому спецификация, гит и структура важнее скорости: чем яснее задача, тем полезнее ИИ и тем меньше правок.
Экономия на подписках и страх упустить плохо сочетаются. Задачи, от которых скрипели зубы, решились за часы. Я смог направить силы на то, что действительно требует опыта: архитектуру, решения, проверку. FOMO никуда не денется, но теперь я гонюсь не за тем, чтобы успеть за всеми, а за тем, чтобы понимать, что делаю. Я погиб как истинный программист, но надеюсь — родился как инженер.