

Я DevOps‑инженер. В DevOps я перешел незадолго до начала этой истории, а до того год работал в сопровождении с элементами SRE. Еще раньше я сидел в центре мониторинга сетей у телеком‑оператора. Дома у меня мини‑ПК и медиасервер, которым каждый вечер пользуется семья. На этом медиасервере я и учился тому, за чем пришел в профессию: Kubernetes, Istio, Jenkins.
Медиасервер у меня собран из целого arr‑стека. Так называют набор self‑hosted сервисов, которые сами находят, качают и раскладывают по папкам фильмы и сериалы. Смотрим мы все в Jellyfin, это медиасервер, что‑то вроде домашнего КиноПоиска. Заявки принимает Seerr (раньше он назывался Jellyseerr): выбрал фильм на витрине, и заявка ушла дальше. Фильмами занимается Radarr, сериалами Sonarr. Оба спрашивают Prowlarr, а тот ищет раздачи по торрент‑трекерам. Если трекер закрыт капчей Cloudflare, Prowlarr проходит ее через FlareSolverr. Качает qBittorrent, субтитры подбирает Bazarr. Когда все работает, человек нажимает одну кнопку, и через какое‑то время фильм появляется в Jellyfin.
В прошлой статье, «Я даже не пойму, если что‑то сломал», я рассказывал, как бросил учебный демо‑магазин и перенес все на медиасервер. Закончил я ее тем, что фильм играет, а значит, о поломке я узнаю. С дивана, как потом выяснилось, видно далеко не все. Самые неприятные ошибки за следующие месяцы выглядели как успех: джоба писала, что все прошло, кино играло, а того, что должно было случиться, не случалось.
Пишу я это прежде всего для себя. С конца мая по конец октября 2026 года я сделал много отдельных кусков и ни разу не видел путь целиком. Хочу собрать его в одном месте и понять, что вообще произошло. Текста вышло на три статьи. Эта первая, про кластер, хранилище, Istio и платформу вокруг. Во второй будет свой сервис, сборка с проверками безопасности и то, как код у меня начал писать агент. В третьей Helm, фронт, возвращение к Istio, просмотр фильма, пока он качается, и Argo CD.
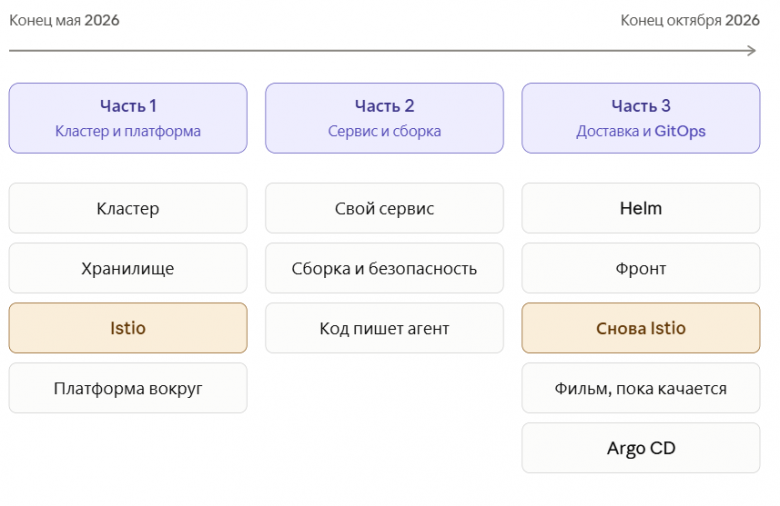
Сразу предупрежу: повествование местами рваное. Внутри одной темы я буду прыгать вперед и назад по датам, потому что многие истории разгадывались только через месяц. Странность я замечал в августе, а причину находил в октябре, и рассказывать эти половинки порознь нет смысла.
Почти все это время я работал в паре с нейросетью. В проекте она была в режиме наставника: объясняла словами, что нужно сделать, а делал я сам, и готовый кусок кода она давала, только когда я застревал. С самого начала мы договорились исходить из того, что проект должен выдержать 300 тысяч пользователей. Таких пользователей у меня, конечно, нет. Это фильтр для решений: вариант «для домашней лабы сойдет» мы не рассматривали. К концу октября роли сильно поменялись. Код моих сервисов теперь пишет агент, а я проверяю его как DevOps. Как так вышло, тоже часть пути.
Что крутится дома сейчас
Все живет на двух мини‑ПК. Основной, Beelink SER8 на Ryzen 7 с 64 GB памяти, работает под Proxmox. Это гипервизор: на одной железке он держит много виртуальных машин и LXC‑контейнеров, то есть легких контейнеров с целой системой внутри. Из трех виртуалок по 8 GB я собрал кластер Kubernetes через kubeadm, а рядом с ним живут служебные машины. Второй мини‑ПК, на N100 с 16 GB, держит мониторинг и DNS. К нему подключен USB‑диск на 1 TB, и он раздает этот диск кластеру по NFS, как сетевую папку.
В кластере работает весь arr‑стек из вступления и еще TorrServer. Он умеет отдавать фильм на просмотр, пока торрент еще качается, и про него будет отдельная история в третьей части.
Рядом стоят три моих сервиса. Первый я зову санитаром медиатеки. Он по API забирает у Radarr, Sonarr и qBittorrent, что они знают о файлах, и сравнивает это с тем, что реально лежит на диске. Расхождения санитар показывает мне и сам ничего не удаляет. Второй сервис дает санитару веб‑интерфейс. Третий, radarr‑java, это Radarr, переписанный на Java. Код всех трех пишет агент, а сборка, проверки и деплой вокруг них остались на мне.
Под всем этим лежит платформа. Ее проще показать списком:
Реестр и секреты. Nexus хранит Docker‑образы и пакеты Maven и npm. Vault хранит пароли и токены и выпускает сертификаты от моего собственного удостоверяющего центра.
Код и сборка. Gitea под репозитории, Jenkins, целиком описанный конфигурационным файлом, SonarQube для анализа кода и Postgres.
Мониторинг. Prometheus собирает метрики, Loki собирает журналы, Grafana их показывает, а Alertmanager рассылает оповещения. Агентов мониторинга на машины раскатывает Ansible.
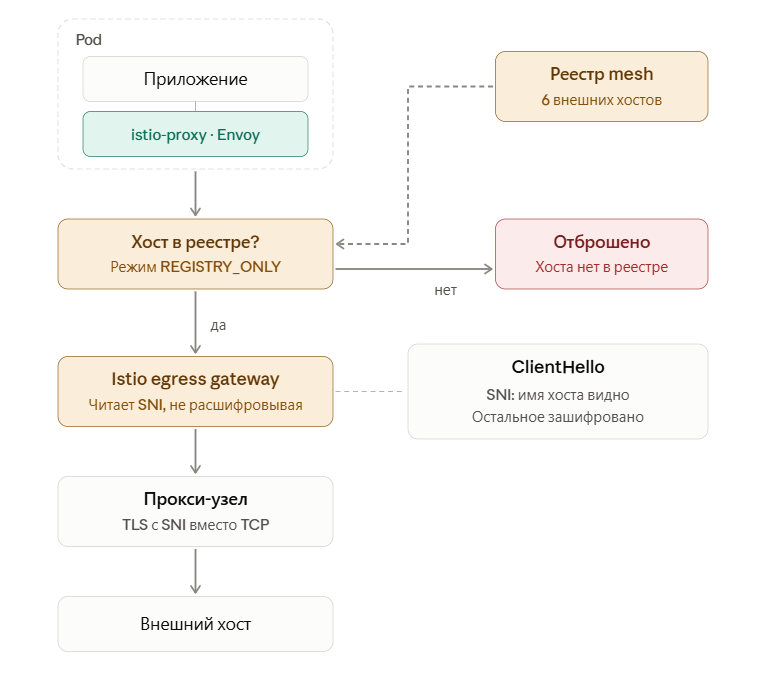
Mesh. Istio строит mesh, сеть сервисов под своим управлением. К каждому поду он добавляет сайдкар, свой прокси‑контейнер рядом с приложением. Между сервисами трафик идет зашифрованным (mTLS), а наружу выходит только через egress gateway, отдельный выходной шлюз, и дальше через прокси‑узел на VPS. Неизвестные хосты сайдкар наружу не выпускает (режим REGISTRY_ONLY), а кому к кому можно обращаться внутри, решают политики доступа с запретом по умолчанию.
Вход в кластер. MetalLB выдает адреса в домашней сети, ingress‑nginx принимает запросы снаружи и передает их Istio Ingress Gateway, входному шлюзу mesh. Уже он разводит запросы по сервисам.
Доставка. Argo CD, который сам приводит кластер к состоянию, описанному в Git. С ним я только начал.
Между кодом и кластером стоит конвейер в Jenkins. Он собирает и тестирует код, прогоняет его через несколько сканеров безопасности и качества и кладет в Nexus образ и дистрибутив, то есть архив со списком точных версий образов. На образ конвейер ссылается по digest. Это хэш содержимого образа, и подменить образ под ним нельзя, тогда как тег можно перевесить на что угодно. Выкатывает все это в кластер отдельная джоба. Почти весь конвейер вырос вместе с первым моим сервисом, и про него будет вторая часть.
Магазин, который молчал
Начинал я с Online Boutique, демо‑магазина от Google на 11 сервисах. Полтора месяца я строил вокруг него платформу: кластер, Nexus, SonarQube, Vault и конвейер из трех стадий. Почему я его бросил, подробно написано в прошлой статье. Если коротко, я им не пользовался и не мог понять, сломал что‑то или нет. В середине июня я переехал на медиасервер, которым дома пользуются каждый вечер. Подход остался прежним, поменялось только то, что крутится на платформе.
Переезд, при котором кино не должно было пропасть
Медиасервер дома был и до кластера. На втором мини‑ПК жили две LXC: в одной Jellyfin, в другой qBittorrent, и к мини‑ПК был подключен тот самый USB‑диск на 1 TB. Этим сетапом семья пользовалась каждый вечер, поэтому разбирать его я не стал. Он остался запасным: если кластер ляжет, кино можно будет смотреть по‑старому.
Сначала я решил, где будут лежать файлы. Диск я пробросил в отдельную виртуалку с NFS и раздал с нее две папки: одну на SSD под конфиги сервисов, другую на HDD под фильмы и сериалы. Новый qBittorrent в кластере писал на тот же HDD по сети. Для торрента это не лучший вариант, и я это понимал. Мне хотелось разобраться, как Kubernetes работает с сетевым хранилищем, а насколько это медленно, я собирался посмотреть по факту. Раскладку по быстрым и медленным дискам мы с нейросетью отложили до тех пор, пока не появится измеренная проблема.
Старые LXC пришлось переподключить к той же раздаче, и тут случилась первая заминка. Jellyfin подключился без вопросов, а контейнер с qBittorrent был непривилегированным. Такой контейнер работает без прав root на хосте и смонтировать NFS внутри себя не может. Я смонтировал раздачу на самом хосте и пробросил папку в контейнер через bind mount, то есть показал ему готовый каталог хоста.
Сам переезд я начал с qBittorrent и шел маленькими шагами. Сначала голый под, потом Deployment, который сам перезапускает под, потом Service с постоянным адресом, ServiceAccount и в конце Helm‑чарт, написанный руками. Где‑то на середине пути до меня дошло неприятное. Все сервисы arr‑стека выходят готовыми образами от linuxserver.io, и собирать мне нечего. Свои сервисы на Python и Go, которые я успел напридумывать, чтобы конвейеру было что собирать, я выбросил, и проект стал чисто про деплой. Я согласился на это сознательно, но позже к этому решению еще вернусь.
Конфиги сервисов должны были пережить пересоздание пода, и для этого в Kubernetes есть PV и PVC. PV описывает кусок хранилища, в моем случае папку на NFS, а PVC это заявка пода на такой кусок. Первую пару я написал руками под qBittorrent:
apiVersion: v1
kind: PersistentVolume
metadata:
  name: qbittorrent
spec:
  capacity:
    storage: 500Mi
  accessModes:
    - ReadWriteMany
  persistentVolumeReclaimPolicy: Retain   # удалили заявку - данные на NFS остаются
  nfs:
    server: <nfs-сервер>
    path: /data/nfs/qbittorrent
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: qbittorrent
  namespace: jellyfin
spec:
  accessModes:
    - ReadWriteMany
  volumeName: qbittorrent
  resources:
    requests:
      storage: 500Mi
Проверил я ее самым простым способом, который нашел: задал пароль в его веб‑интерфейсе, удалил под и зашел в новый. Пароль остался, значит конфиг жил на NFS, а не внутри контейнера.
Порадоваться я успел ненадолго. В тот же вечер все три ноды ушли в NotReady, и кластер лег целиком. Виновником оказался containerd, среда запуска контейнеров на каждой ноде. Kubernetes управляет контейнерами через его плагин CRI, а containerd второй версии этот плагин просто не загрузил. В его конфиге одновременно были старая секция с зеркалами реестров образов и новый параметр config_path, который указывает, где эти зеркала искать. Две настройки конфликтовали. Я убрал старую секцию и оставил в конфиге только путь к каталогу с зеркалами:
[plugins."io.containerd.grpc.v1.cri".registry]
  config_path = "/etc/containerd/certs.d"
А на каждый реестр завел в этом каталоге свой файл hosts.toml. Мой Nexus тогда работал по HTTP, и containerd нужно было явно разрешить ходить к нему без TLS:
# /etc/containerd/certs.d/<адрес реестра>/hosts.toml
server = "http://<адрес реестра>"

[host."http://<адрес реестра>"]
  capabilities = ["pull", "resolve"]
После перезапуска containerd на всех трех нодах кластер вернулся.
Дальше пошло быстрее. Под медиатеку я сделал один большой том на 500Gi с доступом RWX. Так называется режим, в котором том могут одновременно монтировать на запись несколько подов, а медиатеку читают и пишут почти все сервисы стека. Для конфигов я поставил nfs‑subdir‑external‑provisioner. Он сам создает папку на NFS под каждую новую заявку, и руками описывать PV для каждого сервиса больше не пришлось. Через день в кластере работали все восемь сервисов.
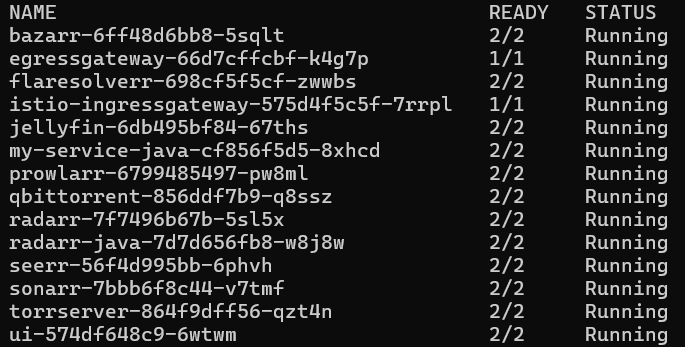
Вместе с сервисами пришли аварии из‑за ресурсов. Ноды начали сообщать DiskPressure, то есть что на диске кончается место. В таком состоянии kubelet выселяет поды с ноды, и кластер выкидывал их пачками. Место съедали журналы и скачанные образы. Я увеличил диски нод с 15 до 30 GB и только после этого заметил, почему их не хватало так быстро. LVM внутри виртуалок отдал корню только половину диска. Следом сервисы стали падать с OOMKilled, когда ядро убивает контейнер, который вышел за свою память, и каждому пришлось подбирать лимиты. Как это было с Prowlarr, я рассказывал в прошлой статье.
Последняя находка той недели к кластеру отношения не имела. Сервисы не могли достучаться до TMDB, базы фильмов, откуда стек берет названия, описания и постеры. Адрес api.themoviedb.org у меня резолвился в 127.0.0.1. Я переключился на DoH, DNS поверх HTTPS, который провайдер подменить не может, и получил тот же 127.0.0.1. Блокировка сидела глубже резолвера, на уровне DNS, который отвечает за сам домен, и смена DNS‑сервера тут не помогала. Сервисам нужен был выход наружу в обход домашней сети.
Как сервисы научились ходить в интернет через VPS
Arr‑стеку интернет нужен постоянно. Radarr и Sonarr берут оттуда метаданные, Seerr тянет постеры, Prowlarr ходит по трекерам. TMDB оказался только первым из внешних адресов, которые из моей сети не открывались. Решение я выбрал простое: если адрес недоступен из дома, запрос к нему идет через мой собственный VPS, арендованный сервер за пределами домашней сети.
В кластере появился прокси‑узел. Он держал туннель до VPS, а сервисам внутри кластера представлялся обычным HTTP‑прокси. Первая мысль была самой ленивой: прописать прокси в переменной окружения HTTP_PROXY у всех контейнеров. Большинство приложений читает эту переменную само, и тогда весь стек пошел бы наружу через узел без единой правки в настройках.
Сломалось на этом приложение, написанное на Node.js. Его HTTP‑клиент не умел работать с прокси для HTTPS. В этом случае клиент должен попросить прокси открыть туннель до сервера методом CONNECT, а этот клиент так не делал, и запросы падали. Переменную я убрал и прописал прокси в веб‑интерфейсе каждого приложения по отдельности. Тогда это выглядело как мелкая настройка: сделал один раз и забыл. В Jellyseerr я заодно включил кэш постеров, чтобы картинки не ходили через VPS при каждом открытии витрины.
Через день весь стек заработал целиком. Я выбрал фильм на витрине Jellyseerr, заявка ушла в Radarr, Radarr через Prowlarr нашел раздачу, и qBittorrent начал ее качать. Всю цепочку внутри кластера я увидел впервые.
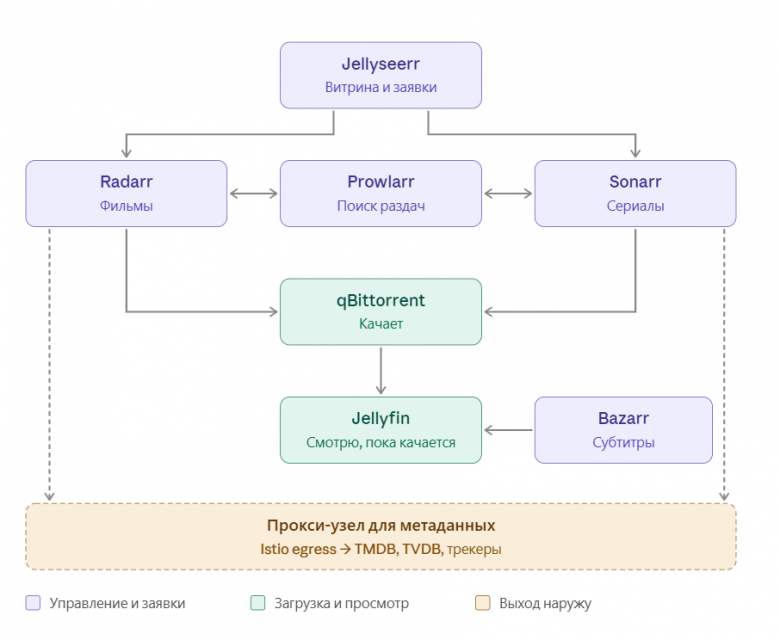
Тут же выяснилось, что через VPS придется ходить не только к заблокированным адресам. Часть трекеров закрыта капчей Cloudflare, и Prowlarr получал от них отказ: Cloudflare забанил мой домашний IP. Prowlarr я тоже отправил наружу через прокси‑узел.
На этом картина казалась мне законченной. Сервисы находили и качали фильмы, заблокированные адреса открывались через VPS, а кто именно ходит через прокси, решала галочка в настройках каждого приложения. Сам кластер об этом ничего не знал, и тогда меня это не беспокоило. Беспокоило другое: сервисы, которые только что работали, начали сами перезапускаться.
Почему кластер убивал здоровые сервисы
Чтобы Kubernetes понимал, жив ли сервис, ему задают пробы. Это периодические проверки, обычно запрос к адресу внутри приложения. Startup‑проба ждет, пока сервис запустится, readiness решает, можно ли уже пускать к нему запросы, а liveness следит, не завис ли он. Если сервис несколько раз подряд не ответил на liveness, kubelet, агент Kubernetes на ноде, перезапускает контейнер. В начале июля я добавил все три пробы всем сервисам стека.
Первым на этом застрял qBittorrent, причем не из‑за проб, а из‑за обновления. По умолчанию Kubernetes обновляет сервис стратегией RollingUpdate: сначала поднимает новый под и только потом гасит старый, чтобы сервис не пропадал ни на секунду. qBittorrent держит в папке конфига lockfile, файл‑замок, который говорит, что qBittorrent уже запущен. Новый под не мог взять замок, пока жив старый, а старый не уходил, пока новый не станет готов. Обновление встало намертво. Помогла стратегия Recreate, при которой старый под уходит первым, а новый поднимается уже после него.
Следом Recreate получили все сервисы, которые хранят данные в SQLite. Это база в одном файле, без отдельного сервера, и рассчитана она на одного хозяина. При RollingUpdate два пода какое‑то время живут вместе и пишут в один и тот же файл, а так базу легко испортить. Короткий простой при обновлении обходится дешевле, чем восстановление базы. В values это одна строка:
strategy:
  type: Recreate
Честно скажу, на 300 тысяч пользователей такое не годится. Один под без запасного и база в файле на сетевом диске это ровно то, от чего в проде уходят. Sonarr и Radarr умеют хранить данные в Postgres, и перенести их туда у меня в планах. Пока все живет в SQLite.
Главная история с пробами началась через неделю. Я заглянул в список подов и увидел, что счетчики рестартов выросли: у jellyseerr 24, у sonarr 21, у radarr 17. При этом кино играло, заявки проходили, и сам я ничего странного не замечал. В причине последнего перезапуска стояли exit 143 и статус Completed. Код 143 значит, что процесс завершился по сигналу SIGTERM, то есть его попросили остановиться. Сервисы не падали сами, их останавливал кластер.
Остановку объяснила liveness‑проба. Время от времени сервисы выполняли фоновые задачи и в эти минуты отвечали на пробу медленнее, чем позволял таймаут. Kubelet видел несколько неотвеченных проверок подряд, считал сервис мертвым и перезапускал его прямо посреди работы. Я поднял timeoutSeconds, время ожидания ответа на пробу, до 10 секунд, и рестарты прекратились. У sonarr проба в values выглядит так:
livenessProbe:
  httpGet:
    path: /ping
    port: 8989
  periodSeconds: 10
  timeoutSeconds: 10     # было 3: во время фоновых задач sonarr не успевал ответить
  failureThreshold: 3
Неприятнее самой ошибки было то, что нашел я ее случайно. Дашборд с node_exporter, который у меня тогда был, показывал нагрузку на ноды: процессор, память, диски. Про поды он не знал ничего. Мне же нужно было видеть, какой под перезапускался, сколько раз и почему. Такие данные отдает kube‑state‑metrics, сервис, который переводит состояние объектов Kubernetes в метрики для Prometheus. Я поставил его и собрал в Grafana панель причин рестартов.
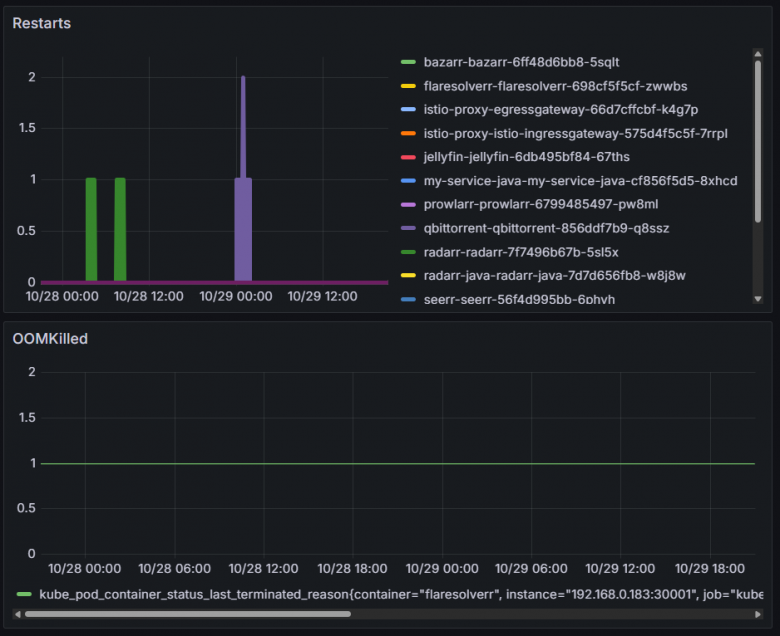
Вторая история тянулась весь июль, и ее героем был FlareSolverr. Внутри у него работает браузер Chromium: в нем FlareSolverr открывает страницу трекера, проходит капчу Cloudflare и отдает результат Prowlarr. Браузер ест много памяти, и первый OOMKilled случился еще в день, когда я впервые прогнал всю цепочку от заявки до загрузки.
Разобрался я с ним только в конце месяца, и начиналось все с другого симптома. В Radarr разом отвалились индексеры, то есть трекеры, через которые он ищет раздачи, а Prowlarr отвечал кодом 429, «слишком много запросов». Это было похоже на срабатывание circuit breaker в Prowlarr. Так называют предохранитель, который на время отключает источник, если тот часто ошибается. Сначала я копал в эту сторону.
Настоящая причина сидела ниже. Запросы к FlareSolverr, которые не прошли с первого раза, копились в очереди повторов, а потом очередь выстрелила разом. FlareSolverr запустил несколько Chromium одновременно, вышел за лимит памяти, и ядро его убило. Я поднял ему лимит до 1536Mi, и такой наплыв запросов его больше не убивал.
Лимиты мешали не только памятью. Однажды вечером Deadpool 2 на телевизоре пошел без звука. Телевизор LG на WebOS не умеет звуковую дорожку DTS, и я включил в Jellyfin перекодирование звука на лету. Тут мешать стал лимит по процессору. Kubernetes выдает контейнеру квоту процессорного времени на каждый короткий отрезок, а когда квота кончается, притормаживает его до следующего. Перекодированием в Jellyfin занимается ffmpeg, и он все время упирался в эту квоту. Лимит по процессору у Jellyfin я снял.
Каждую такую правку я вносил руками: менял values чарта и запускал helm upgrade из консоли. Параллельно я начал переносить это в Jenkins.
Деплой через Jenkins и теги, которые врали
Хотелось, чтобы чарты в кластер накатывала джоба, как на работе, а не я из консоли. Логику деплоя я вынес в shared library. Так в Jenkins называют общую библиотеку кода на Groovy, которую подключают в разные джобы, чтобы не копировать одно и то же. В самой джобе появились галочки с названиями сервисов: отметил нужные, и катятся только они.
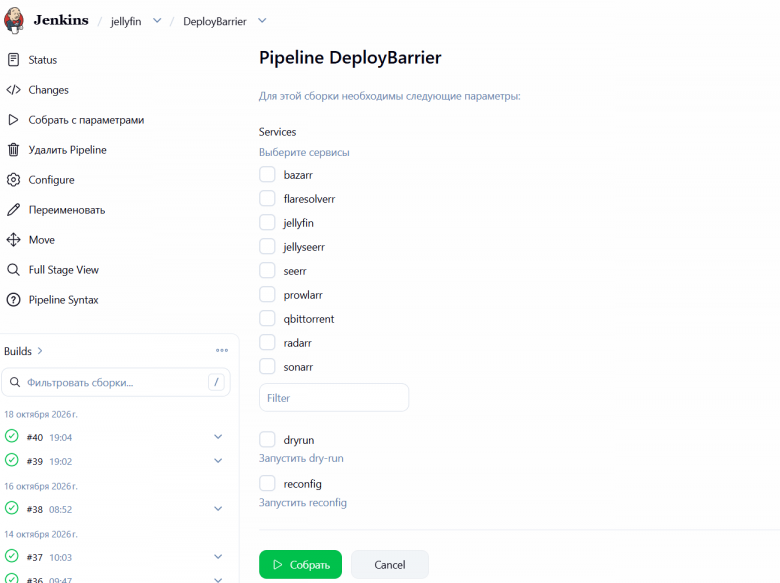
Примерно тогда же сервисы получили имена. Я поставил MetalLB и ingress‑nginx, и в Jellyfin стало можно зайти по имени, а не по IP и порту.
Главной частью деплоя стала схема из трех тегов. Собирать образы arr‑стека было не нужно, они выходят готовыми. Я перекладывал их в свой Nexus и вешал там на каждый образ три тега. Тег new получал свежий образ, work указывал на последний образ, который точно работает, а oldwork на предыдущий рабочий. Джоба катила new, и если сервис поднимался, указатели сдвигались. Если не поднимался, rollout падал по таймауту и джоба возвращала work.
Двигать теги можно без пересборки и даже без скачивания образа. В реестре тег только указывает на манифест, небольшой JSON‑файл со списком слоев образа. Джоба через Registry API, HTTP‑интерфейс реестра, забирала манифест под одним тегом и отправляла его обратно под другим.
Первая ошибка нашлась сразу. По невнимательности я залил манифест qBittorrent под именем jellyfin:new, и реестр принял его без вопросов, потому что ему все равно, что лежит под тегом. Вторую проблему подкинул сам Kubernetes. Если тег в чарте не менялся, Kubernetes не видел разницы и поды не пересоздавал, даже когда под тегом уже лежал другой образ. Поэтому джоба стала ставить на под аннотацию, служебную метку со временем деплоя. В шаблоне чарта она выглядит так:
spec:
  template:
    metadata:
      annotations:
        deployTimestamp: "{{ .Values.deployTimestamp }}"
А джоба передает туда текущее время:
helm upgrade sonarr . -f values_sonarr.yaml -n jellyfin \
  --set tag=new --set deployTimestamp=$(date +%s)
kubectl rollout status deployment/sonarr -n jellyfin --timeout=60s
Аннотация меняется при каждом запуске, спека пода становится другой, и Kubernetes пересоздает поды. Если rollout status не дождался готовности за 60 секунд, джоба возвращает тег work.
Перед перекладкой джоба проверяла свежесть образов. Она сравнивала digest образа у источника с digest того же образа в моем Nexus. Разные digest означали, что у источника вышла новая сборка и образ пора обновить. Отчет у проверки всегда был одинаковый: «8 из 8 требуют обновления». Так продолжалось месяц.
В середине августа я все‑таки задумался, как такое возможно при каждом запуске. Восемь разных проектов вряд ли выпускают новую сборку каждый день. Нейросеть предположила, что docker push пересобирает манифест и поэтому digest всегда получается новым. Звучало правдоподобно, но эксперимент эту версию не подтвердил.
Тогда мы скачали оба манифеста, из источника и из Nexus, и сравнили их. Один весил 2190 байт, другой 2130, а diff показал разницу только в переводах строк. Digest считается как sha256 от байтов манифеста, поэтому даже пропавший перевод строки дает совсем другой хэш. Пропадали переводы строк в моей же перекладке тегов. Манифест уходил в Nexus через curl с ключом -d:
curl -u "$USERNAME:$PASSWORD" -X PUT \
  -H "Content-Type: $MEDIA_TYPE" \
  -d @manifest.json \
  https://<реестр>/v2/jellyfin/manifests/work
Ключ -d выкидывает из файла переводы строк. В Nexus уезжал другой набор байт с другим sha256, и проверка свежести сравнивала два digest, которые не могли совпасть ни при каком раскладе. Ключ --data-binary отправляет файл байт в байт:
curl -u "$USERNAME:$PASSWORD" -X PUT \
  -H "Content-Type: $MEDIA_TYPE" \
  --data-binary @manifest.json \
  https://<реестр>/v2/jellyfin/manifests/work
После правки из восьми образов актуальными оказались шесть, и только у двух действительно вышли новые сборки. Целый месяц джоба перекладывала все подряд и каждый раз сообщала, что обновляет.
Рядом нашлась вторая ошибка. Успех перекладки джоба определяла по коду выхода curl, а curl возвращает 0 даже тогда, когда сервер ответил 401 или 500. Поэтому джоба писала «Тег изменен» и в тех случаях, когда реестр запрос отклонил.
В тот же день тег подвел меня еще раз, теперь в чарте. В values по умолчанию стоял тег test. Я запустил helm upgrade руками, не указал тег явно, и Helm откатил bazarr на старый образ. База bazarr к этому моменту была новее кода. Миграции, то есть скрипты, которые подгоняют схему базы под версию приложения, не нашли свою ревизию, и приложение так и не начало слушать порт. Пробы это заметили, и liveness стала перезапускать его по кругу.
За одно лето под тегом jellyfin:new у меня полежал qBittorrent, а под test лежал старый bazarr. Имя тега говорило только о том, как я его назвал, а о содержимом говорил digest. Поэтому позже конвейер стал ссылаться на образы по digest, а теги остались для людей.
Неделя с socket hang up
Istio я поставил во второй половине июля, когда деплой через Jenkins уже заработал. Как и на работе, я хотел, чтобы сервисы общались между собой только по mTLS. Это взаимный TLS: обе стороны соединения предъявляют сертификаты, и каждая знает, с кем говорит. В Istio шифрованием занимается сайдкар. Внутри него работает Envoy, прокси‑сервер, через который проходит весь трафик пода, а сертификаты сайдкарам выпускает и сам обновляет istiod, управляющий компонент Istio.
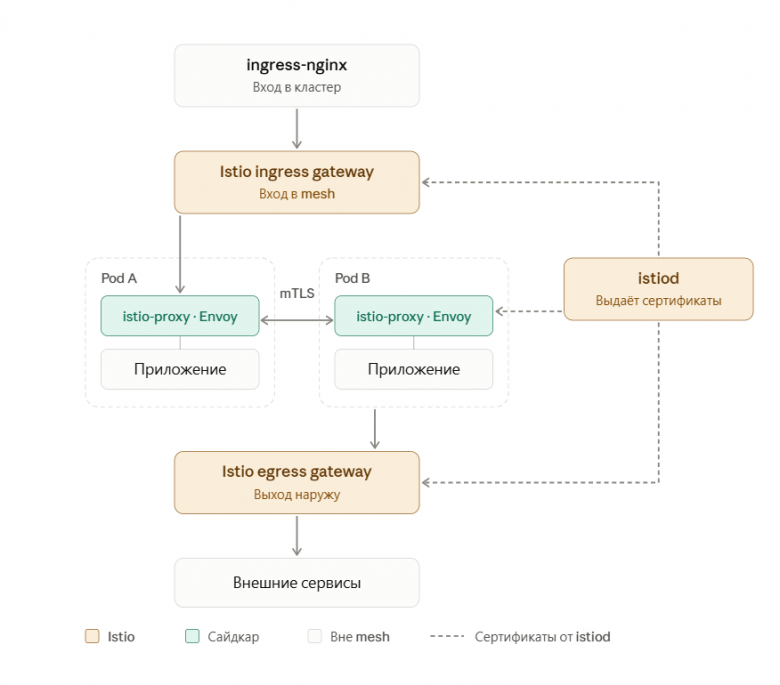
Сначала пришлось решить, как в кластер попадут запросы из домашней сети. В режиме STRICT поды принимают только зашифрованный трафик от участников mesh. ingress‑nginx в mesh не входил, и STRICT отрезал бы его от сервисов. Поэтому между ними я поставил Istio Ingress Gateway, входной шлюз Istio. Nginx отдает запрос шлюзу, а шлюз идет к подам уже по mTLS.
С выходом наружу все оказалось интереснее. В Istio внешние хосты описывают записями ServiceEntry, чтобы mesh знала, куда ходят сервисы. Мне эти записи почти не понадобились, и сначала я не понял почему. Потом дошло: сервисы ходили наружу через прокси‑узел, прописанный у каждого в настройках. Envoy видел только соединения с этим узлом, а куда трафик шел дальше, mesh не знала. Я решил выпускать трафик через egress gateway, чтобы весь выход шел через одну точку под управлением Istio.
Участок от egress gateway до прокси‑узла я хотел зашифровать, причем на своих сертификатах. Для этого я написал DestinationRule, правило Istio о том, как подключаться к конкретному сервису, с режимом MUTUAL. В этом режиме Istio предъявляет те сертификаты, которые ему дали, а не свои. Прокси‑узел должен был снимать это шифрование на входе своим сертификатом и отправлять запрос дальше, к VPS.
К концу июля запросы наружу начали падать с ошибкой socket hang up. Так клиент сообщает, что соединение оборвалось, а ответ так и не пришел. Чтобы посмотреть на трафик изнутри, я подключился к поду через kubectl debug. Эта команда добавляет в работающий под временный контейнер с нужными утилитами, и сам под при этом не перезапускается:
kubectl debug -it <под jellyseerr> -n jellyfin \
  --image=curlimages/curl -- sh
# дальше изнутри пода:
curl -v https://api.themoviedb.org/3
В самом контейнере jellyseerr curl нет, а из контейнера сайдкара проверять бесполезно: его трафик Istio специально не перехватывает, и запрос ушел бы мимо всей цепочки.
Первая находка выглядела как ответ. У Istio есть фильтр, через который сайдкары обмениваются метаданными, служебными сведениями о себе. Этот фильтр вставлял свои байты в TLS‑соединение до прокси‑узла. Узел получал поток, который не мог расшифровать, и отвечал ошибкой BAD_DECRYPT. Я временно выключил mTLS и попробовал убрать фильтр через EnvoyFilter, ручную правку конфигурации Envoy.
Через день стало ясно, что причина глубже. Прокси‑узел снимал TLS на входе, как я его и настроил. Но дальше, чтобы отправить трафик к VPS, ему нужен был исходный поток целиком, а расшифрованное соединение для этого не годилось. Схема со своими сертификатами и MUTUAL ломала узлу ровно то, что ему было нужно. Фильтр метаданных оказался настоящей ошибкой, но не главной.
Тогда я отказался от своих сертификатов и пустил в mesh сам прокси‑узел. Я поставил на него сайдкар Istio и перевел участок до узла на ISTIO_MUTUAL:
apiVersion: networking.istio.io/v1
kind: DestinationRule
metadata:
  name: egress-to-proxy
spec:
  host: <прокси-узел>.jellyfin.svc.cluster.local
  trafficPolicy:
    tls:
      mode: ISTIO_MUTUAL   # сертификаты выдает и обновляет сам Istio
В этом режиме шифрование между сайдкарами Istio и ставит, и снимает сам, а узел получает от своего сайдкара исходный поток целым. Собственный трафик до VPS узел отправляет мимо сайдкара. Для этого на под узла я повесил аннотацию, которая исключает адрес VPS из перехвата:
traffic.sidecar.istio.io/excludeOutboundIPRanges: "<IP VPS>/32"
Оставался вопрос, который меня не отпускал. В журнале прокси‑узла у каждого соединения стояло имя хоста, и я хотел понять, откуда узел его берет. Ради эксперимента я подставил в его настройку выдуманное имя faketmdb. Все продолжало работать. Значит, настоящее имя узел читал из ClientHello, первого сообщения TLS, в котором клиент открытым текстом называет сервер, к которому идет. А в журнал попадало имя из моей настройки, и увиденное узлом там не отражалось. Это знание пригодилось почти сразу: дальше egress предстояло учить различать хосты как раз по этому имени.
Почему запрет неизвестных хостов пришлось отложить
Трафик до прокси‑узла теперь шел через mesh, и я взялся за то, ради чего все затевалось. Цель называлась REGISTRY_ONLY. В этом режиме сайдкар выпускает под только к внешним хостам из реестра mesh, а все остальное отбрасывает. Для этого egress должен был различать хосты по имени, а не только по порту.
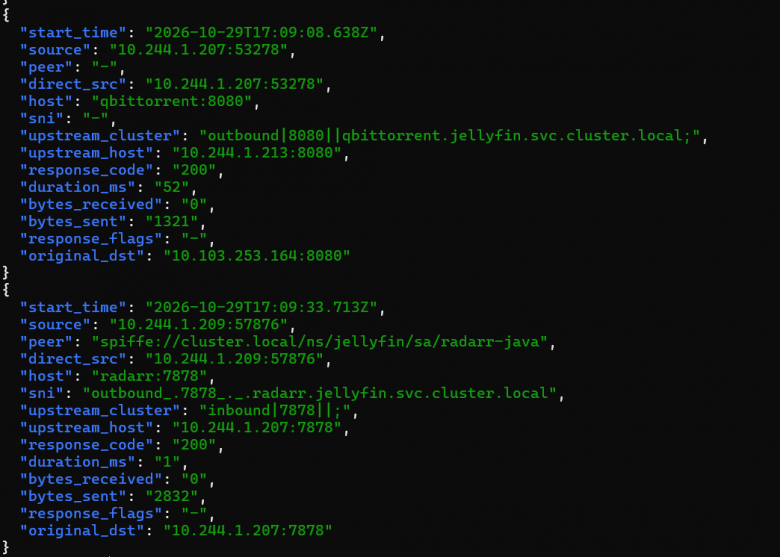
Имя хоста, которое клиент передает в ClientHello, называется SNI. По нему egress gateway понимает, куда идет соединение, и расшифровывать трафик ему для этого не нужно. Я перевел выход наружу с голого TCP на TLS с SNI и завел первые шесть хостов. Первая же ошибка случилась в имени. radarr.video и api.radarr.video оказались разными хостами, и правило для одного не пускало к другому. С тех пор имя хоста я брал из реального трафика, а не из своих представлений о том, как он должен называться.
Реальный трафик я тогда смотрел в журнале прокси‑узла. В тот же день его под пересоздался, и журнал пропал вместе с ним. Kubernetes хранит логи контейнера, только пока жив сам под, и мне понадобилось хранилище логов, которое живет отдельно от подов. Так в планах появился Loki.
Скоро выяснилось, что каждый новый хост приходится вписывать дважды. Egress и прокси‑узел жили в разных чартах, и список внешних хостов лежал и в values чарта egress, то есть в его файле с параметрами, и в values прокси‑узла. Синхронизировал я эти списки руками, и рано или поздно они бы разошлись. Поэтому я собрал оба чарта в umbrella‑чарт. Так называют чарт, который подключает другие чарты как зависимости и передает им общие параметры. Список хостов теперь лежит в нем один раз, в секции global, которую видят оба вложенных чарта:
global:
  base: 9000        # новые хосты добавлять строго в конец
  egressHosts:
    - host: api.themoviedb.org
      nameIstio: themoviedb
    - host: image.tmdb.org
      nameIstio: imagemoviedb
Порт для каждого хоста чарт вычисляет сам, от базового номера и места хоста в списке. Первый хост получает 9001, второй 9002. Поэтому новые хосты можно добавлять только в конец: вставишь в середину, и у всех следующих сдвинутся порты.
Шаблоны Helm пишутся на Go templates, и на них я споткнулся почти сразу. Формулу порта я вынес в отдельный шаблон и вызывал его из шести мест:
{{- define "egressHosts.port.base" -}}
{{ add .index (add1 .base) }}
{{- end }}

# вызов
{{ include "egressHosts.port.base" (dict "index" $index "base" $.Values.global.base) }}
В первой версии ключи словаря в dict я написал без кавычек, index вместо "index". Go templates поняли это как обращение к полю, которого нет, получили пустоту, и после рендера у всех портов оказалось значение 1. Ошибки при этом не было. Поймал я это, когда сравнил рендер, то есть готовые манифесты, которые Helm собирает из шаблонов и values, до переделки и после. Я менял устройство чарта, а не результат, поэтому разница между ними должна была выйти пустой. Так я с тех пор и переделываю чарты: по одному изменению, и после каждого сравниваю рендер.
Потом я включил журналы доступа Envoy. В них попадает каждое соединение, прошедшее через сайдкар: откуда, куда и чем оно закончилось. По этим журналам я собрал реестр из 16 внешних хостов, к которым ходили сервисы.
С реестром на руках стало видно главное. Пока прокси прописан в настройках приложения, REGISTRY_ONLY ничего не ограничит. Приложение открывает соединение к прокси‑узлу, а прокси‑узел для mesh обычный сервис внутри кластера. Сайдкар видит разрешенное внутреннее соединение и пропускает его, а куда узел отправит запрос дальше, mesh не знает. Настройка, которую в начале июля я поставил в каждом приложении за пару минут, прятала от Istio весь трафик через прокси.
Подстраховать Istio на уровне сети тоже было нечем. За сеть между подами в Kubernetes отвечает CNI‑плагин, и у меня это Flannel. Сетевые ограничения описывают объектами NetworkPolicy, а Flannel их молча игнорирует: кластер политику принимает, но трафик она не режет. К тому же Istio перехватывает только TCP, и все остальное шло мимо него.
В тех же журналах я заметил странность во FlareSolverr. Chromium внутри него ходил наружу с пустым SNI, то есть без того самого имени, по которому egress различал внешние адреса. Почему так, я тогда не понял, и вопрос провисел открытым два месяца.
Работа с нейросетью в эти дни тоже буксовала. В режиме наставника она начала засыпать меня вопросами вместо дела. Вечер уходил на перебор вариантов, а до решения мы так и не доходили. Пришлось договориться: когда данных для решения хватает, она дает план и больше не спрашивает. Примерно тогда же она предложила оставить прокси в Prowlarr как компромисс. Я назвал это упрощением, и мы условились, что обходных путей попроще она мне не предлагает.
В начале августа я поставил Istio на паузу. REGISTRY_ONLY оказался не ненужным, а неготовым: пока прокси живет в приложениях, включать его не имело смысла. Вернулся я к нему только в октябре, а до этого нужно было привести в порядок саму платформу.
Корень на 32 дня и Jenkins, собранный из файлов
Пока Istio стоял на паузе, я взялся за то, на чем держится вся платформа: сертификаты, реестр и Jenkins. Все это я поднимал еще под магазин, и теперь хотел пересобрать начисто.
Начал я с сертификатов. Сервисы в домашней сети общаются по HTTPS, и сертификаты для них выпускает мой собственный удостоверяющий центр в Vault. Во главе у него стоит корневой сертификат, корень доверия. Машина, которая доверяет корню, доверяет и всем сертификатам, выпущенным от его имени. Поэтому корень выпускают надолго: когда он истекает, перестают открываться сразу все сервисы.
Корень я выпустил через веб‑интерфейс Vault и выставил ему срок. Корень все равно получился на 32 дня. Нейросеть сказала, что в интерфейсе срок корня не задать. Я не поверил, и мы проверили: интерфейс действительно не передавал срок, и Vault брал значение по умолчанию, 768 часов. Корень на 10 лет я выпустил уже из командной строки:
vault secrets tune -max-lease-ttl=87600h pki
vault write pki/root/generate/internal \
  common_name=<имя корня> \
  ttl=87600h \
  key_bits=4096
Первая команда поднимает потолок срока для движка PKI, вторая выпускает сам корень. Приватный ключ корня при этом не покидает Vault.
Через несколько дней Jenkins перестал получать секреты из Vault. Плагин писал «key not found», и выглядело это так, будто секрет пропал. Секрет лежал на месте, а протух токен, с которым Jenkins заходил в Vault. Срок у токена был тот же самый, 768 часов, и значение по умолчанию ударило по мне второй раз.
Доверие к новому корню пришлось раздать пяти машинам, и по дороге набралась целая цепочка мелких ошибок. Утилита jq без флага -r отдала сертификат одной строкой, с буквальными \n вместо переводов строк, и nginx его не прочитал. Переменная VAULT_CACERT, в которой я указал свой корень, заменила системный список доверенных корней целиком, хотя я думал, что она его дополняет. А при вставке команды в терминал потерялась одна строка. Ключ репозитория пакетов не добавился, и экран заполнился ошибками NO_PUBKEY. Ошибок на экране было много, но причина у них была одна, и сидела она в самой первой.
Потом все чарты и джобы переехали на Nexus по HTTPS. В прошлой статье я писал, что реестр работает по HTTP без TLS и это записано в техдолге. Этот долг я закрыл.
С Jenkins я решил не возиться и пересоздать его с нуля, а настройки описать файлами. Для этого есть плагин JCasC, Jenkins Configuration as Code. При старте он читает YAML‑файл и настраивает по нему Jenkins: пользователей, права, агентов. Начало моего файла выглядит так:
jenkins:
  systemMessage: "Managed by JCasC"
  numExecutors: 0          # на контроллере ничего не собирается, только на агентах
  securityRealm:
    local:
      allowsSignup: false
      users:
        - id: "${JENKINS_ADMIN_ID}"
          password: "${JENKINS_ADMIN_PASSWORD}"
Сам Jenkins, контроллер, ничего не собирает. Сборки идут на агенте, отдельной машине, которая сама подключается к контроллеру, а запускает агент у меня systemd. Одну вещь JCasC описать не смог. Агент подключается с секретом, а этот секрет Jenkins вычисляет из своего ключа secret.key. Поэтому сохранить пришлось сам ключ, и тогда после пересоздания Jenkins секрет агента остается прежним.
Новый Jenkins я запустил в Docker внутри LXC, а образ прибил по digest. Через пару дней файлы с настройками мне пригодились. Я хотел очистить каталог /var/lib/jenkins, а набрал rm -rf /var/lib/*. Вместе с данными Jenkins ушли dpkg и apt, systemd и containerd, то есть система потеряла менеджер пакетов, систему запуска служб и среду для контейнеров. LXC пришлось пересоздать с нуля. Jenkins поднялся из тех же файлов, и вспоминать, что и где я когда‑то настраивал, не понадобилось. Теперь перед rm -rf я делаю ls на том же пути и снимаю снапшот контейнера в Proxmox, чтобы было к чему откатиться.
Раз уж пересоздавать, я собрал свой образ Jenkins:
FROM <реестр>/jenkins/jenkins@sha256:<digest>

USER root
COPY homelab-ca.crt /usr/local/share/ca-certificates/homelab-ca.crt
RUN update-ca-certificates && \
    keytool -importcert -noprompt -trustcacerts -alias homelab-ca \
      -file /usr/local/share/ca-certificates/homelab-ca.crt \
      -cacerts -storepass changeit
USER jenkins

COPY --chown=jenkins:jenkins plugins.txt /usr/share/jenkins/ref/plugins.txt
RUN jenkins-plugin-cli -f /usr/share/jenkins/ref/plugins.txt

ENV JAVA_OPTS="-Djenkins.install.runSetupWizard=false"
Запускается он через Docker Compose:
services:
  jenkins:
    image: <реестр>/jenkins/jenkins-lab:3
    container_name: jenkins
    restart: unless-stopped
    ports:
      - "8080:8080"
    env_file: .env                     # логин и пароль админа, в git не попадает
    environment:
      TZ: "Europe/Moscow"
      CASC_JENKINS_CONFIG: /var/jenkins_home/casc
    volumes:
      - /var/lib/jenkins:/var/jenkins_home
      - ./casc:/var/jenkins_home/casc:ro
      - ./secret.key:/usr/share/jenkins/ref/secret.key:ro
    dns:
      - <домашний DNS>
Каталог с файлами JCasC смонтирован только на чтение: настройки меняются в git, а не в интерфейсе. Отдельно смонтирован secret.key, тот самый ключ, из которого Jenkins вычисляет секрет агента. DNS указан явно, потому что с публичными серверами внутренние имена реестра и Gitea из контейнера не резолвились бы.
Плагины перечислены в plugins.txt и ставятся при сборке образа. Поэтому Jenkins стартует без интернета, как в закрытом контуре, где выхода наружу нет. Мастер первоначальной настройки выключен, потому что все настройки приходят из JCasC. Мой корень доверия образ кладет дважды. Команда update-ca-certificates добавляет его в системный список, которым пользуются curl и git. Java этот список не читает, у нее свое хранилище, и туда корень добавляет keytool. Если положить корень только в одно место, вторая половина инструментов его не увидит.
В Vault Jenkins теперь заходит через AppRole. Так в Vault устроен вход для сервисов и скриптов: у роли есть постоянный идентификатор и секрет к нему, secret_id. Секрет я выпустил без срока, а менять его решил по процедуре, руками, без таймера.
В эти же дни нейросеть дважды ошиблась. Сначала она увидела в выводе строку «Request CERT» и решила, что Vault требует от клиентов сертификат, то есть работает по mTLS. На деле так выглядит обычное рукопожатие TLS 1.3. Потом она предложила, чтобы Jenkins ходил в Vault через внешний домен. Jenkins и Vault стоят в одной домашней сети, а с таким адресом Jenkins за каждым секретом ходил бы через интернет. Это я поймал сразу.
К концу той недели сертификаты, реестр и Jenkins описывались файлами, которые можно прочитать и применить заново. Следующим на очереди стоял мониторинг.
Логи, которые живут дольше пода
Когда журнал прокси‑узла пропал вместе с подом, мне стало ясно, что логи должны храниться отдельно от подов. Loki у меня к тому времени уже стоял. Это хранилище логов, по которому умеет искать Grafana. Но версия у него была старая, 2.9, а собирал для него логи Promtail, который к тому времени забросили. Я обновил Loki до 3.7.6, а заодно поднял Prometheus с 2.53 до 3.13.2. Перед обновлением Prometheus я снял бэкап, потому что вернуться с третьей версии на вторую уже нельзя. Образы всего стека я прибил по digest манифест‑листа. Под одним тегом часто лежат сборки для разных процессоров, и манифест‑лист перечисляет их все, так что его digest закрепляет весь набор.
Вместо Promtail я поставил Grafana Alloy. Он работает как DaemonSet, то есть Kubernetes запускает по одной его копии на каждой ноде. Каждая копия читает логи подов своей ноды из каталога /var/log/pods и помнит, где остановилась, даже после рестарта. Чтобы копия собирала только свою ноду, ей нужно имя этой ноды. Я хотел взять его из переменной HOSTNAME, но внутри пода в ней лежит имя пода. Имя ноды пришлось передать отдельно, через Downward API, механизм, который пробрасывает в под сведения о нем самом:
extraEnv:
  - name: NODE_NAME
    valueFrom:
      fieldRef:
        fieldPath: spec.nodeName
С HOSTNAME селектор нашел бы ноль подов, и Alloy работал бы без единой ошибки, ничего не собирая. Еще я убрал из логов метку с путем к файлу: в этом пути сидит UID пода, а он у каждого нового пода свой.
Логов вышло немного, 6.9 MB за 25 часов. Зато в первый же день они показали то, чего я раньше не видел. Jellyseerr каждые две секунды стучался в api.github.com и каждый раз получал 403.
Вторая дыра была в самих машинах. Сервисы у меня время от времени зависали, и я подозревал NFS, с которого они читают конфиги и медиатеку. Проверить это было нечем, потому что с NFS‑сервера не приходило ни одной метрики. Метрики машины, то есть процессор, память, диски и сеть, отдает Prometheus экспортер node_exporter. Его я и решил поставить на NFS‑сервер и на остальные машины вне кластера.
Ставил я ее через Ansible. Это инструмент, который по SSH приводит машины к состоянию, описанному в файлах, плейбуках. node_exporter я ставил бинарником, без контейнера. Он работает как пользовательская служба systemd под отдельной учеткой без прав root. Плейбуков получилось два. Первый от root готовит машину, а второй уже от этой учетки ставит экспортер.
Плейбук должен быть идемпотентным. Так называют задачу, которую можно запускать сколько угодно раз с тем же результатом: если все уже сделано, повторный запуск ничего не меняет. Модули Ansible обычно сами проверяют, сделано ли дело. Голая команда так не умеет, и ей надо подсказать признак. Вот задача, которая включает linger, чтобы пользовательские службы жили, даже когда пользователь не залогинен:
- name: Enable linger for monitoring
  ansible.builtin.command:
    cmd: loginctl enable-linger monitoring
    creates: /var/lib/systemd/linger/monitoring
Параметр creates говорит Ansible: если такой файл уже есть, команду запускать не нужно. Тогда второй прогон плейбука показывает changed=0, и по этому видно, что плейбук идемпотентный. Часто вместо признака пишут changed_when: false. Этот флаг заставляет задачу всегда отвечать, что ничего не поменялось, даже когда она поменяла. После него changed=0 выходит при любом раскладе и уже ничего не говорит.
Еще одна ловушка сидела в inventory, списке машин и групп, с которыми работает Ansible. Плейбук перебирал машины группы через groups['x']. Если в inventory этой группы не оказывалось, цикл проходил ноль раз, и плейбук заканчивался зеленым, ничего не сделав.
Схема заработала на трех типах машин: на виртуалке с NFS, на LXC с Postgres и на управляющей ноде кластера. Метку с именем машины я заменил меткой role, назначением машины: у NFS‑сервера в ней стоит nfs. По метрикам NFS‑сервера я собрал для него отдельный дашборд.
Теперь метрики шли со всех машин, а логи жили дольше подов. Алертов при этом еще не было, и о проблемах я по‑прежнему узнавал, только когда сам открывал графики. А в Jenkins, который я только что собрал заново, все так же нечего было собирать.
За это я и взялся дальше: написал свой сервис, чтобы конвейеру было что собирать, и обвесил сборку проверками безопасности. Через месяц код этого сервиса уже писал агент, а я проверял его как DevOps. Об этом вторая часть.