

?Это часть 20 серии “Управление уязвимостями для самых маленьких” - практического руководства по VM с нуля. Главы самостоятельны, но если хочется по порядку, оглавление и все части серии тут.
“Что не измеряется, тем нельзя управлять” - старая управленческая мудрость, которая в управлении уязвимостями работает на сто процентов. Можно купить лучший сканер, нанять умных людей и все равно не понимать, работает процесс или буксует. Эта глава - про то, как измерить свой VM, доказать его эффективность руководству и понять, на каком уровне зрелости вы находитесь.
Зачем вообще измерять
Причин три. Первая - управление. Помните цикл Деминга из главы про контроль процесса? Планируем, выполняем, контролируем, корректируем. Контроль невозможен без метрик. Если вы не знаете, сколько уязвимостей в инфраструктуре и как быстро они закрываются, вы не управляете процессом - вы просто надеетесь, что все хорошо.
Вторая - доказательство. Рано или поздно руководство спросит: “Мы вложили в безопасность кучу денег. Стало лучше?” Без метрик вы ответите “ну, вроде да” - и это плохой ответ. С метриками вы покажете: время устранения критических уязвимостей сократилось с 45 дней до 5, покрытие выросло с 60% до 95%. Это язык, который понимает бизнес.
Третья - обнаружение проблем. Метрики подсвечивают, где процесс ломается. Растет число просроченных уязвимостей? Значит, ИТ не справляется или SLA нереалистичен. Покрытие не растет? Значит, есть слепые зоны. Метрики - это приборная панель, без которой вы летите вслепую.
MTTR - главная метрика современного VM
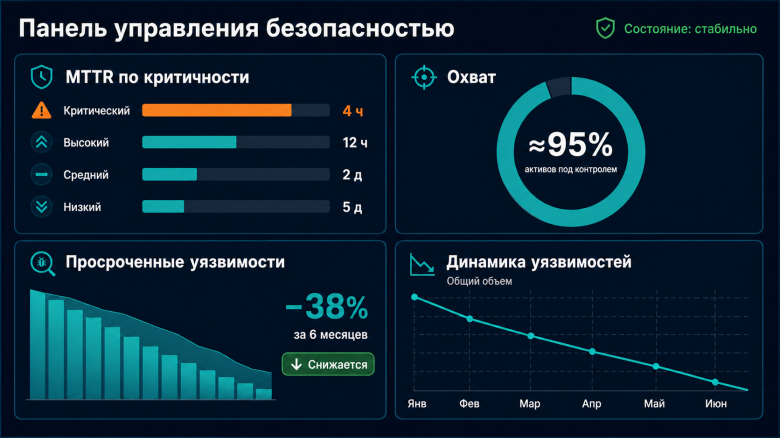
Полный набор показателей по этапам процесса - покрытие, активы с SLA, просроченные уязвимости, повторно появившиеся, плотность на актив - я подробно разобрал в главе про этапы процесса VM: там таблицы с формулами, пороговыми значениями и разбором того, какие из этих метрик легче всего накрутить. Там же - про дашборды и про то, как подавать данные разным аудиториям. Повторяться не буду.
Здесь речь об одной метрике, которая важнее остальных, когда вы разговариваете с руководством. MTTR (Mean Time To Remediate) - среднее время от обнаружения уязвимости до ее устранения. Почему именно она главная? Потому что в мире, где среднее время до появления рабочего эксплойта измеряется днями, а для пограничных устройств массовая эксплуатация начинается в день раскрытия, скорость решает все. Уязвимость, закрытая за 3 дня, и та же уязвимость, закрытая за 3 месяца, - две разные истории с разным финалом.
Три правила, без которых метрика бесполезна:
Считайте раздельно по уровням критичности. Среднее “по больнице” врет: если вы пачками закрываете низкие уязвимости, но месяцами тянете с критическими, общий MTTR будет выглядеть прилично при провальной реальной защищенности.
Считайте от обнаружения, а не от создания задачи. Между этими двумя точками нередко лежат недели, и именно там прячется самая интересная часть вашего процесса.
Смотрите MTTR только вместе с покрытием. Быстрый MTTR по трети инфраструктуры не значит ничего - и это самый популярный способ незаметно улучшить показатель.
И сравнивайте с требованиями. Для российских госсистем приказ ФСТЭК № 117 задает планку: критические - 24 часа, высокие - 7 дней [1]. Ваш MTTR для критических укладывается в сутки? Если нет - у вас проблема и с безопасностью, и с комплаенсом.
Как выглядит отрасль: цифры для разговора с руководством
Это самая полезная часть главы для тех, кому надо защитить бюджет или объяснить, почему за квартал не закрыли все. Отраслевые цифры отрезвляют - и, что важно, они на вашей стороне.
Что измеряли |
Значение |
Источник |
|---|---|---|
Медиана полного устранения уязвимости |
43 дня |
Verizon DBIR 2026 [2] |
Доля уязвимостей из каталога KEV, устраненных полностью |
около 26% |
Verizon DBIR 2026 [2] |
MTTR критических и высоких на сетевом и периметровом оборудовании |
около 39 дней |
Edgescan 2025 [3] |
MTTR критических и высоких в веб-приложениях и API |
около 55 дней |
Edgescan 2025 [3] |
Средний срок устранения критических KEV |
137 дней |
Bitsight 2024 [4] |
Средний срок устранения высоких KEV |
238 дней |
Bitsight 2024 [4] |
Доля KEV, оставшихся неустраненными после дедлайна |
более 60% |
Bitsight 2024 [4] |
“Период полураспада” дефектов в ПО (время устранения половины) |
252 дня в 2025-м, 243 в 2026-м |
Veracode [5] |
Читается это так: между нормативным идеалом в 24 часа и тем, как работает отрасль, лежит пропасть в месяцы. Причем даже для уязвимостей, про которые официально известно, что их эксплуатируют прямо сейчас: 137 дней на критическую KEV - это четыре с половиной месяца жизни с открытой дверью, о которой предупредили публично.
Есть и совсем неприятная динамика. Qualys в 2026 году разобрал более миллиарда записей об устранении по десяти тысячам с лишним организаций и обнаружил, что доля критических уязвимостей, остающихся открытыми через 7 дней, за четыре года не упала, а выросла - с 56% в 2022-м до 63% в 2025-м [6]. Это другой срез, чем медиана Verizon выше (там - полное закрытие по всей базе CVE, здесь - доля непогашенных именно из каталога KEV на седьмой день), но тренд тот же. При том что абсолютное число закрытых уязвимостей за тот же период выросло примерно в шесть с половиной раз. Мир стал закрывать в разы больше и при этом отстает сильнее.
Российская картина не выбивается из общей. По данным “Информзащиты” за первый квартал 2025 года, компании своевременно устраняют лишь 56% уязвимостей, найденных по итогам пентестов, а средние уязвимости при рекомендованных 14 днях закрываются в среднем за 35 [7]. Подробнее эти цифры разобраны в главе про этапы процесса.
В разговоре с руководством эти цифры нельзя использовать как оправдание: “у всех плохо, значит, и нам можно” - худший вывод из таблицы выше, атакующему безразличны отраслевые медианы. Используйте их как систему координат. Фраза “наш MTTR по критическим - 12 дней” ничего не говорит руководителю. Фраза “наш MTTR по критическим - 12 дней при отраслевой медиане в районе 40 и нормативе в 24 часа: мы существенно быстрее рынка и все еще не соответствуем приказу, вот что нужно, чтобы закрыть разрыв” - это уже разговор о бюджете, а не о самочувствии.
Метрики нужно подавать под аудиторию
Об этом подробно - в главе про этапы процесса VM, там же примеры конкретных дашбордов для руководства, для VM-инженера и для расследования. Здесь одна мысль, которую полезно держать в голове перед любой встречей. Руководителю (CISO, CEO, правление) не нужны технические детали. Ему нужен ответ на вопрос “у нас все хорошо и что делать дальше”: уровень защищенности, динамика, соответствие требованиям регуляторов, связь с бизнес-рисками. “Мы соответствуем приказу ФСТЭК № 117 по срокам устранения” - вот что он хочет услышать, а не “у нас 14 732 уязвимости средней критичности”.
Инженеру нужно ровно противоположное - что чинить сегодня. Одни и те же данные, разная подача. Универсальный отчет “для всех” не работает ни для кого.
Модель зрелости VM
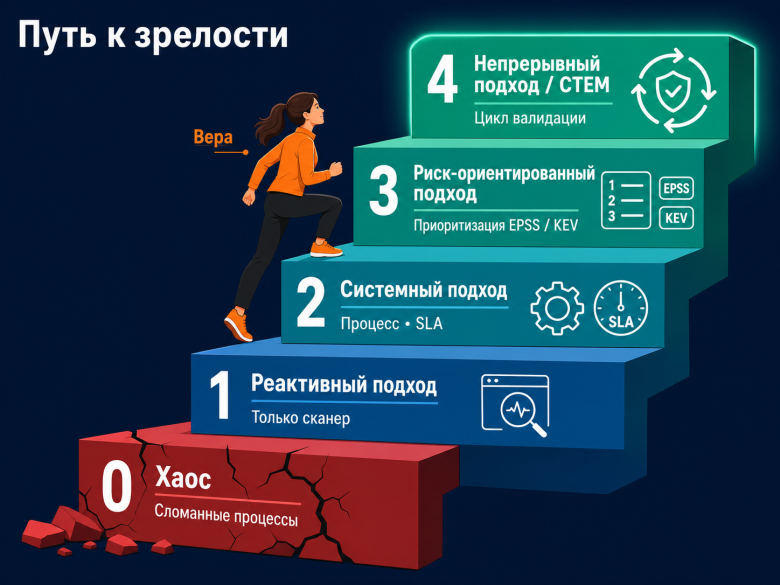
Метрики показывают текущее состояние. А чтобы понять, куда расти, полезна модель зрелости - лестница из пяти ступеней, по которой развивается процесс.
Уровень 0, хаос. Управления уязвимостями нет. Иногда что-то сканируют, когда грянет гром или придет проверка. Уязвимости живут годами (помните периметровые уязвимости возрастом 11 лет?). Реакция - только на инциденты.
Уровень 1, реактивный. Есть сканер, его иногда запускают. Отчеты передаются в ИТ, но контроля устранения нет. Это та самая ситуация из главы про построение процесса: “получаем отчет, отдаем в ИТ” - и все. Процесса как такового нет, есть инструмент.
Уровень 2, системный. Появился настоящий процесс: есть владелец, регламент, SLA, регулярное сканирование, контроль устранения. ИТ и ИБ договорились. Метрики собираются. Это уже хороший рабочий уровень, к которому стоит стремиться большинству компаний - и которому, по сути, посвящена основная часть этой книги.
Уровень 3, риск-ориентированный. Приоритизация строится не на голом CVSS, а на реальном риске: эксплуатируемость (EPSS, KEV, трендовые БДУ), значимость активов, контекст инфраструктуры. Уязвимости связаны с недопустимыми событиями. Активно используется автоматизация. Это уровень, к которому подводят главы про приоритизацию и категоризацию активов.
Уровень 4, непрерывный (CTEM). Высшая ступень. Защита охватывает все типы экспозиции, а не одни CVE, процесс непрерывный, есть проверка боем (автопентест, BAS), все интегрировано в единую программу с фокусом на бизнес-критичном. Это та самая концепция CTEM из отдельной главы.
Лестница нужна, чтобы честно оценить, где вы сейчас, и наметить следующий шаг. Не нужно прыгать с нулевого уровня сразу на четвертый - это нереально. Нужно методично подниматься: сначала наладить базовый процесс (уровень 2), потом добавить риск-ориентированность (уровень 3), потом двигаться к непрерывности (уровень 4). Каждая ступень опирается на предыдущую.
Самая честная метрика
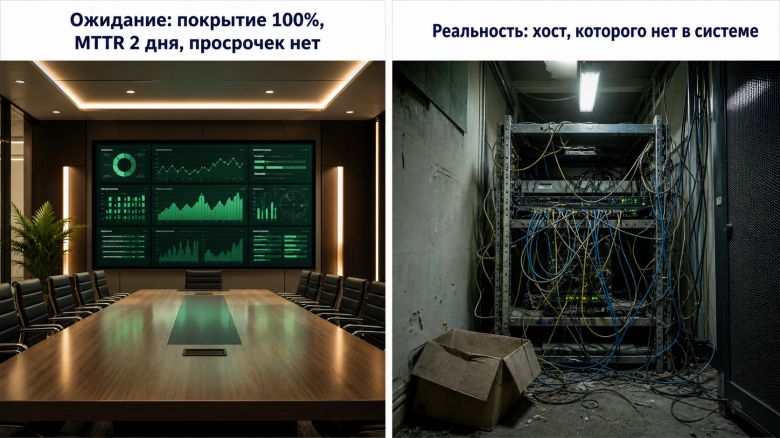
Все цифры на дашбордах - это косвенные показатели, и любую из них можно натянуть: сузить периметр, поднять порог критичности, играть со знаменателем. Это и есть закон Гудхарта в чистом виде - метрика, ставшая целью, рано или поздно перестает быть хорошей метрикой. А самая честная, прямая метрика эффективности вашего VM - это киберучения и проверка боем, о чем я говорил еще в главе про этапы процесса. Когда реальный атакующий (своя red team, внешний пентестер или исследователь на багбаунти) пытается дойти до недопустимого события и не может - вот это и есть доказательство, что процесс работает. Зеленые циферки могут врать, успешно отраженная атака - нет.
Поэтому стройте метрики, показывайте их руководству, поднимайтесь по лестнице зрелости - но периодически устраивайте себе настоящую проверку боем. Это лучший детектор самообмана.
А как у вас?
Какой у вас MTTR для критических уязвимостей - укладываетесь в сутки или это пока мечта? И на какой ступени зрелости вы себя видите: реактивный, системный, риск-ориентированный, непрерывный? Только честно.
Источники и ссылки
Источники главы
Приказ ФСТЭК России от 11.04.2025 № 117 (сроки устранения как ориентир для MTTR: критические - 24 часа, высокие - 7 дней).
Verizon Data Breach Investigations Report 2026 (медиана полного устранения - 43 дня, доля полностью закрытых уязвимостей из каталога KEV - около 26%).
Edgescan Vulnerability Statistics Report 2025 (MTTR критических и высоких: около 39 дней для сетевого и периметрового оборудования, около 55 дней для веб-приложений и API).
Bitsight, “A Global View of the CISA KEV Catalog: Prevalence and Remediation”, 2024 (средний срок устранения критических KEV - 137 дней, высоких - 238 дней; более 60% KEV остаются неустраненными после дедлайнов).
Veracode, State of Software Security (период полураспада дефектов: 252 дня в издании 2025 года, 243 дня в издании 2026 года; данные относятся к разработке ПО, а не ко всей инфраструктуре).
Qualys Threat Research Unit, “The Broken Physics of Remediation”, март 2026 (доля критических уязвимостей, открытых через 7 дней, выросла с 56% в 2022 г. до 63% в 2025 г.).
“Информзащита”, данные по итогам пентестов за I квартал 2025 года (своевременно устраняется 56% уязвимостей; средние уязвимости при рекомендованных 14 днях - в среднем за 35 дней).
Навигация по серии: ⬅️ Предыдущая: Гл. 19. AI в управлении уязвимостями · ?Оглавление серии · Следующая: Заключение➡️
Если у вас в инфраструктуре что-то устроено иначе - расскажите в комментариях. Зашло - подписывайтесь, чтобы не пропустить следующую часть.
orki
Сокращать Vulnerability Management до VM - это безбожно на сайте где не одни безопасники.