

В статье расскажу о том, как командная встреча, возражение руководителя разработки и три года комментариев к PR (пул-реквестам) привели к появлению инструмента, которого никто не планировал, но которым теперь пользуются все. И как вашей команде сделать такой же (шаблон прилагается).
Три недели назад я решил сделать для нашей команды в HoneyBook универсальный чек-лист перед отправкой PR. В итоге у нас появился ИИ-ревьюер, который анализирует комментарии к PR за последние три года и формулирует замечания в характерной манере каждого разработчика. Хотя ничего подобного мы изначально не планировали.
Теперь он проверяет PR так, как это делают участники нашей команды.
Он знает, что Лиэль считает нарушения правил сокращённой записи булевых пропсов в JSX несущественными, Игги не пропустит ни одной зависимости от MobX, а Идан воспринимает любой комментарий TODO как причину заблокировать PR. Хаим обязательно заметит асинхронные методы, в которых на самом деле нет ни одного await, а Дана поймает вас на использовании тегов <br> для создания отступов. Он знает, что Ади обнаружит мёртвый код, Амит точно подсчитает, сколько запросов к БД выполняется внутри вашего цикла, и укажет это число в комментарии. А я однажды даже составил таблицу истинности прямо в комментарии к PR, чтобы доказать свою правоту. И теперь при проверке каждого PR инструмент учитывает предпочтения всех участников команды.
Теперь мы без него никуда. Ирония в том, что появился он совершенно случайно.
Расскажу, как всё получилось и как по пути нам удалось снизить затраты почти в семь раз без потери точности.
Проблема: ИИ не ускорил ревью кода
Наша команда уже давно активно использует искусственный интеллект в разработке. Каждый день мы работаем с Claude Code и другими ИИ-инструментами. За последний год писать код стало гораздо быстрее, а вот скорость ревью практически не изменилась.
В итоге ревью превратилось в узкое место. PR ждали своей очереди, а разработчикам приходилось постоянно переключаться между задачами, требующими глубокой концентрации, и проверкой чужого кода. Чем быстрее мы выпускали код, тем больше времени вся команда тратила на ревью.
В прошлом месяце мы собрались, чтобы вместе разобраться с этой проблемой. Все сошлись во мнении: главное узкое место – код-ревью. Под конец встречи наш техлид Алон задал вопрос, который оказался гораздо важнее, чем я тогда думал: «Какой инструмент мы могли бы сделать, чтобы сократить время на ревью?»
v0: универсальный чек-лист (не продержался и суток)
На следующее утро я выложил первую версию. Идея была простой: создать скилл (skill) для Claude Code под названием /t2a-review – в честь нашей команды T2A. Любой разработчик мог бы запускать его перед отправкой PR на ревью.
Скилл должен был проверять дифф по чек-листу в Markdown-файле checklist.md. Тот, в свою очередь, обращался к папке с отдельными чек-листами участников команды, чтобы каждый мог легко добавлять и обновлять свои правила. Всё это дополнялось внутренними соглашениями HoneyBook и общими рекомендациями по React.
Никакой сложности: обычный Markdown, живой документ, открытый для редактирования.
Я поделился инструментом в командном канале:
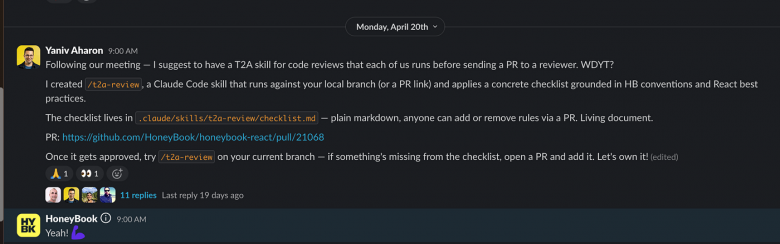
Команда отреагировала положительно, но несколько человек заметили, что поддерживать чек-лист вручную будет довольно хлопотно. А потом наш руководитель разработки Амит оставил комментарий, который изменил весь проект: «Слишком универсально. Здесь нет ничего специфичного для нашей команды».
И он был прав. По сути, я сделал ESLint с чат-интерфейсом. Возможно, полезно. Но ничего особенного. Стоит ли запускать его перед каждым PR? Пожалуй, нет. Большинство проблем, которые он мог обнаружить, и так выявлялись линтером. А остальные были настолько типичными, что их заметил бы любой разработчик с годовым опытом работы с React.
Более того, опасения команды тоже были обоснованными: никто не стал бы регулярно обновлять универсальный чек-лист, и уже через несколько недель он бы устарел. Документ остаётся живым, только пока людям не всё равно, что в нём написано. А универсальные правила особого желания поддерживать их актуальность не вызывают.
Команде нужен был не просто универсальный ревьюер. Ей нужен был наш собственный.
Меняем подход
Амит оставил свой комментарий ближе к середине дня. Готового ответа у меня не было, поэтому до самого вечера я продолжал обдумывать его слова: между встречами, за обедом и просто фоном, пока занимался другими задачами.
Логика была простой: универсальный ревьюер нам не нужен. Но сделать инструмент, заточенный именно под нашу команду, казалось трудоёмкой задачей. Если составлять отдельный чек-лист для каждого разработчика вручную, придётся поговорить со всеми, формализовать их предпочтения, а потом рассчитывать, что они будут поддерживать эти документы в актуальном состоянии. То есть мы снова столкнёмся с той же проблемой, которую уже обнаружили. Только теперь документов будет ещё больше.
Где-то после обеда меня осенило: разработчики обращают внимание на разные вещи при ревью кода.
У каждого есть свои закономерности.
Кто-то особенно придирчив к производительности.
Кто-то помешан на тестах.
Кто-то с первого взгляда замечает архитектурные проблемы.
А у кого-то есть твёрдые убеждения насчёт читаемости кода, доступности интерфейсов или использования фреймворков.
За последние годы каждый разработчик нашей команды оставил тысячи комментариев к PR. Настоящих комментариев к настоящему коду. В них отражено, к чему люди действительно придираются при ревью. Не то, что они думают о своих предпочтениях, и не то, что написали бы в анкете, а конкретные проблемы, на которые они обращали внимание, проверяя код коллег.
Вот они, данные о повторяющихся закономерностях. И все эти данные у нас уже были.
Как мы это сделали
Когда эта мысль окончательно сложилась в голове, план стал понятен:
Через GitHub API собрать все комментарии, которые каждый участник команды оставлял к PR в наших репозиториях.
Передать весь массив комментариев Claude и попросить найти повторяющиеся закономерности. К чему этот разработчик регулярно придирается? Какие замечания оставляет снова и снова?
Создать для каждого ревьюера отдельный Markdown-профиль: adi.md, amit.md, idan.md, dana.md и так далее. В каждом файле зафиксировать характерные замечания разработчика и подкрепить их ссылками на реальные PR.
Структура каталога выглядела так:
При запуске /t2a-review скилл читал все профили и проверял дифф с учётом каждого из них. В результате за один проход мы получали ревью, учитывающее замечания всех участников команды, ещё до того, как кто-либо из них открывал PR.
В тот же день, в 22:26, я написал об этом в командном канале:
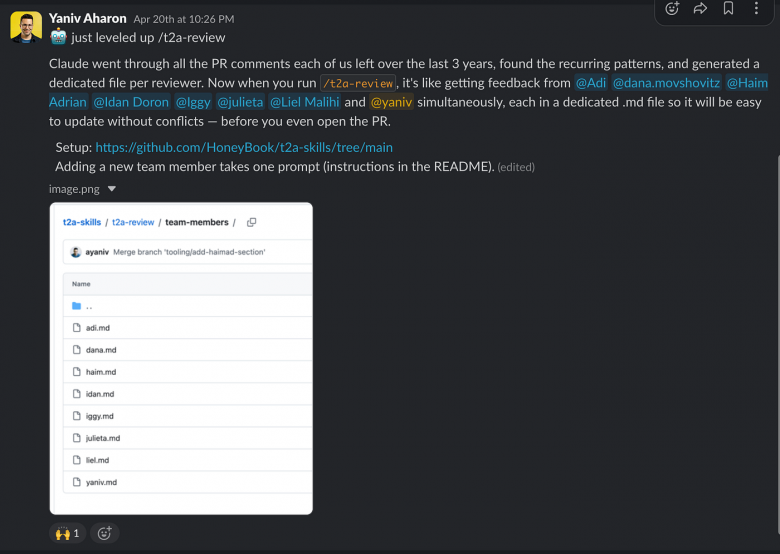
Момент, когда система перестала быть универсальной.
Реакция команды не заставила себя ждать. Уже в тот же день разработчики начали запускать инструмент на собственных PR. Замечания были конкретными, с указанием источников: для каждого было понятно, из чьего профиля оно взялось и на основе какого исторического PR сформировалось правило. А главное, в результатах узнавался наш собственный стиль ревью. Разработчики читали вывод и говорили: «Ага, именно это Амит и написал бы».
Решение хранить профили в отдельных файлах для каждого разработчика было не случайным. Оно напрямую решало проблему первой версии. Если Ади не согласна с чем-то в собственном профиле, она просто создаёт PR с правками в adi.md. Никаких конфликтов с профилями других разработчиков. Никакого общего документа, изменения в котором нужно согласовывать всей командой. Поддержка сводится к простой схеме: один человек – один файл. На практике только такой подход и позволяет поддерживать документы в актуальном состоянии.
Ещё несколько дней на доработку
Не хватало принятых в проекте правил и соглашений. Поэтому мы подключили файл cursor-rules.md из каталога .cursor/rules: правила навигации, работы с хуками, стилями, интернационализацией (i18n), тестами и формами. Это стало ещё одним важным этапом развития инструмента. Теперь скилл автоматически учитывает и эти правила.
Добавление нового участника команды свелось к одному промпту: достаточно указать Claude имя пользователя на GitHub, попросить проанализировать историю его PR и сохранить сгенерированный профиль в нужную папку.
К концу первой недели каждый разработчик в команде запускал /t2a-review перед отправкой PR на ревью. Качество кода, попадавшего на проверку, заметно выросло. Разработчики заранее устраняли проблемы, на которые коллеги действительно обратили бы внимание при ревью, ещё до того, как кто-либо из них успевал открыть дифф.
И тут мы вошли во вкус
Затем Хаим предложил изменить архитектуру: перестать объединять все профили в один запрос к Claude. Вместо этого запускать параллельно по одному агенту на каждого ревьюера, чтобы каждый работал только со своим профилем. А в конце добавить агента-скептика, который будет проверять замечания остальных, отсеивать ложноположительные срабатывания и слишком широкие совпадения с шаблонами.
И это сработало. Команде очень понравился новый результат. Теперь для каждого замечания было чётко видно, из профиля какого ревьюера оно взялось. Параллельная архитектура позволила находить закономерности, которые версия с одним запросом раньше объединяла или упускала. А агент-скептик убирал лишний шум.
Но потом мы увидели счёт.
На PR объёмом 469 строк мультиагентная версия потратила около миллиона токенов. Один запуск обошёлся примерно в 20 долларов. Тринадцать агентов на Opus работали параллельно: одиннадцать агентов с профилями ревьюеров, агент CursorRules для проверки принятых в проекте правил и соглашений, универсальный ревьюер от Anthropic и агент-скептик. Каждый имел полный доступ к диффу и собственный набор контекстных данных.
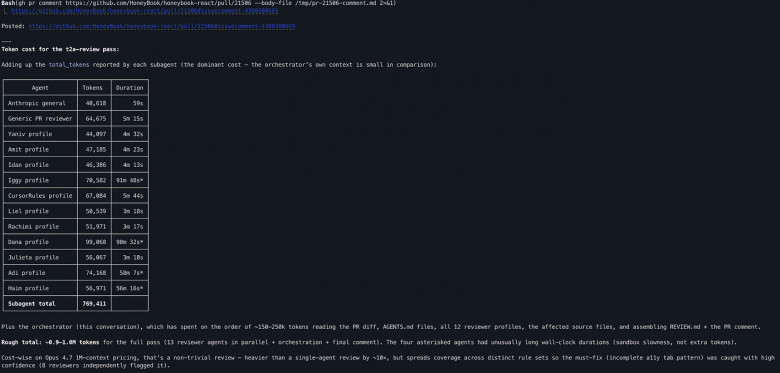
Это примерно в десять раз дороже ревью с одним агентом. Качество действительно выросло: например, восемь ревьюеров независимо друг от друга обнаружили одну и ту же ошибку доступности (a11y), что серьёзно повысило нашу уверенность в значимости замечания. Но затраты оказались слишком высокими. Если каждый разработчик запускает /t2a-review перед отправкой PR, на каждую предварительную проверку уходит по 20 долларов. Такие расходы мы уже не могли себе позволить.
Переработка архитектуры: распределяем задачи между моделями разных классов
Решение заключалось не в отказе от мультиагентной архитектуры. Нужно было просто перестать использовать Ferrari для каждой поездки.
В новой версии (v2.1) два этапа:
Детерминированный этап предварительной обработки. Прежде чем запускать какую-либо модель, обычный код анализирует пути изменённых файлов и определяет тип PR: frontend-ts, backend-ruby или mixed. На втором этапе система обращается к профилям ревьюеров и удаляет разделы, которые не относятся к текущим изменениям. Например, если PR затрагивает только файлы .tsx, правила Амита для Ruby/Mongoid и правила Ади для бэкенда на Rails отбрасываются ещё до того, как их увидит какой-либо агент. Отфильтрованные профили объединяются в один файл с сохранением заголовков разделов с именами ревьюеров. Благодаря этому по-прежнему можно определить источник каждого замечания.
Этот этап вообще не требует затрат на инференс. Он полностью детерминированный, выполняется за несколько сотен миллисекунд и существенно сокращает объём текста, который приходится обрабатывать моделям.
Три агента-ревьюера работают параллельно, плюс один агент-скептик.
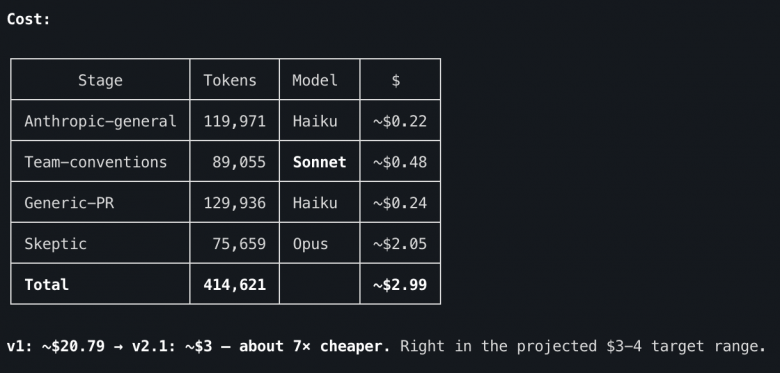
Выбор модели для обработки объединённых профилей оказался критически важным. Haiku, получив за один запрос одиннадцать профилей ревьюеров, выдала всего 3 замечания. Sonnet 4.6 на тех же данных нашла 14. Агенту, который работает с объединёнными правилами команды, нужен не столько широкий поиск, сколько способность анализировать и обобщать информацию. И Sonnet оказалась самой лёгкой моделью, которая хорошо с этим справляется. А вот для широкого поиска потенциальных проблем отлично подходит Haiku. За Opus мы платим как за модель фронтирного уровня, но используем её только там, где действительно нужны такие возможности: для критической проверки выводов остальных агентов.
Тот же PR на 469 строк, проверка которого в v1 стоила $20,79, в версии v2.1 обошёлся всего в $2,99. Почти в семь раз дешевле.
При этом новая версия нашла даже больше проблем. Из 12 замечаний, которые выдала v1, версия v2.1 обнаружила 10 и добавила ещё 7 новых, пропущенных первой версией: неудачное именование булевой переменной, магические строки в тестах, необоснованное использование useMemo, отсутствие теста для противоположного случая и другие. Более полная проверка при гораздо меньших затратах.
Шесть выводов, которые пригодятся любой команде
Вот что я посоветовал бы любой команде, которая захочет создать похожий инструмент:
История PR вашей команды – это обучающие данные. Не нужно объяснять ИИ-ревьюеру, каким должен быть хороший код. Лучше покажите ему, на какие проблемы ваша команда обращала внимание последние три года. Результат будет принципиально отличаться от того, что можно получить с помощью универсального промпта.
Один файл на ревьюера лучше одного большого конфига. Никаких конфликтов при обновлении. Каждый профиль – живой документ, за который отвечает один человек. Поддержка сводится к простой схеме: один человек – один файл. Только такой подход и работает в долгосрочной перспективе.
Мультиагентная архитектура повышает качество, но у неё есть предел по стоимости. Рост затрат с $0,20 до $20 за одно ревью – непозволительная роскошь. Распределение задач между моделями разных классов (model tiering) нужно закладывать в архитектуру с самого начала, а не внедрять потом, когда расходы станут проблемой.
Детерминированная предварительная обработка эффективнее умных промптов. Обычный код, который определяет тип PR и отбрасывает нерелевантные правила, работает быстрее, дешевле и надёжнее, чем модель, которой приходится самостоятельно решать, какие правила применимы. Всё, что можно сделать без инференса, лучше делать без него.
Подбирайте модель под конкретную задачу. Haiku – для широкого поиска проблем и обработки больших объёмов текста. Sonnet – для анализа и обобщения результатов. Opus – только для финальной проверки агентом-скептиком. Платите за возможности моделей фронтирного уровня лишь там, где без них действительно не обойтись.
Агент-скептик на Opus справляется с галлюцинациями лучше, чем ужесточение промптов. Проще отбросить пять ошибочных замечаний, чем добиться, чтобы все десять изначально были безупречными. Пусть более дешёвые агенты находят как можно больше потенциальных проблем, а самая умная модель отсекает лишнее.
Что дальше
/t2a-review продолжает развиваться. Добавить нового участника команды можно одним промптом. Изменить профиль – одним PR. Архитектура выдержала семикратное снижение затрат и увеличение числа ревьюеров в пять раз по сравнению с тем, на что изначально была рассчитана. Насколько мне известно, это первый ИИ-ревьюер кода, который перенимает характерную манеру ревью команды, изучая её собственную историю. А благодаря архитектуре с отдельным файлом для каждого участника он одинаково легко масштабируется как на команды из 8 человек, так и на команды из 50.
Я также публикую открытый репозиторий с шаблоном, чтобы другие команды могли сделать на его основе собственный инструмент. В репозитории есть структура каталогов, классификатор для предварительной обработки, оркестратор и промпт для генерации профиля нового ревьюера по имени пользователя на GitHub. На создание версии для своей команды должно хватить одного дня.
Но главный вывод, к которому я постоянно возвращаюсь, гораздо шире. Искусственный интеллект не сделал код-ревью ненужным. Он лишь наглядно показал, где находится узкое место. И решить проблему помог не очередной универсальный инструмент. Мы просто собрали знания, которые наша команда уже накопила за годы проверки кода друг друга, и научились автоматически применять их на практике.
Если у вас та же ситуация – ИИ ускоряет написание кода, а ревью по-прежнему тормозит процесс, – вспомните о комментариях к PR за последние три года. Все эти данные уже у вас под рукой. Осталось заставить их работать.
Собрать ИИ-ревьюера — только часть задачи. Дальше нужно встроить его в процесс разработки, распределить работу между агентами и автоматизировать запуск проверок. Подходы к решению этих задач можно изучить на бесплатных уроках с преподавателями курсов OTUS:
22 октября, 20:00. «От промта к автоматизации: как встроить LLM в рабочий процесс». Записаться
28 октября, 18:00. «ИИ-агенты на основе LLM и мультиагентные системы». Записаться
11 ноября, 20:00. «ИИ-агент по расписанию: как заставить Claude Code работать, пока вы заняты другим». Записаться
Комментарии (2)

balamutang
21.10.2026 14:07Что пишет автор: "Мы скормили Claude три года комментариев к PR. Теперь он ревьюит код как наша команда"
Что читаю я: "Мы за свои деньги обучили чужой GPT и теперь он может недорого заменить нашу команду"
hohlov06