

Привет, Хабр!
Принято считать, что с медианой спорить не о чем. Отсортировал значения, взял середину. С p90 то же самое, только не середина, а ближе к краю. Когда цифра в ноутбуке аналитика не совпадает с дашбордом, ошибку ищут в фильтрах, часовых поясах, дублях после джойна — где угодно, кроме самой функции.
На больших таблицах так и надо искать: там все способы посчитать перцентиль дают одно и то же с точностью до рубля.
Расхождения начинаются в сегментах. Новый город, премиальный тариф, заказы одного курьера за неделю — десяток строк, и p90 из одного и того же набора получается от 3900 до 12 500 в зависимости от того, какой функцией его считали.
И ни один инструмент не врёт. Перцентиль маленькой выборки однозначно не определён, каждая библиотека выбрала своё определение, а называются функции почти одинаково.
Десять заказов и тринадцать ответов
Возьмём сегмент из десяти заказов: 450, 520, 610, 700, 980, 1200, 1350, 2100, 3900 и 12 500 рублей.
Я посчитал по нему медиану и p90 в шести инструментах, теми функциями, до которых рука тянется первой: pandas 3.0.6, Polars 2.0.0, DuckDB 1.5.6, PostgreSQL 16, ClickHouse 26.9 во встроенном виде через chdb и LibreOffice Calc.
Вывод собирает один скрипт:
            функция                       p50     p90
pandas      quantile(q)                  1090    4760
Polars      quantile(q)                  1200    3900
Polars      median()                     1090       —
DuckDB      quantile(x, q)                980    3900
DuckDB      quantile_cont(x, q)          1090    4760
DuckDB      approx_quantile(x, q)        1090    8200
PostgreSQL  percentile_cont(q)           1090    4760
PostgreSQL  percentile_disc(q)            980    3900
ClickHouse  quantile(q)                  1090    4760
ClickHouse  quantileExact(q)             1200   12500
ClickHouse  quantileTDigest(q)            980    3900
LibreOffice PERCENTILE.INC                  —    4760
LibreOffice PERCENTILE.EXC                  —   11640
Медиан получилось три разных, p90 — пять. Функция с именем quantile встречается в четырёх инструментах, и в каждом считает по‑своему.
В pandas она интерполирует между соседними значениями.
В Polars берёт ближайшее значение.
В DuckDB
quantile— псевдоним для дискретногоquantile_disc, который не интерполирует вовсе.В ClickHouse это вообще приближённый алгоритм с выборкой, просто на десяти строках он успевает увидеть все значения и выдаёт то же, что pandas.
Отдельно хороша строка Polars. Внутри одной библиотеки median() возвращает 1090, а quantile(0.5) — 1200.
Метод quantile по умолчанию работает с interpolation="nearest", а median считает классическую медиану как среднее двух центральных.
Аналитик, который в одной ячейке ноутбука посчитал медиану, а в соседней «для единообразия» перешёл на quantile(0.5), получит разницу в 10% без всяких изменений в данных.
Ошибки в Polars нет: значение по умолчанию написано в сигнатуре метода. Просто туда никто не смотрит.
Что вообще такое p90 из десяти чисел
Если выстроить десять заказов по возрастанию, p90 должен оказаться где‑то между девятым и десятым. Где конкретно, решает метод.
Самый распространённый способ — его используют pandas, quantile_cont в DuckDB, percentile_cont в PostgreSQL и PERCENTILE.INC в таблицах — ставит точки на позиции от 0 до n−1.
Позиция p90 тогда:
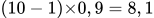
Это десятая часть пути от девятого значения к десятому:
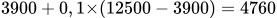
Этот же метод в numpy называется linear и выбран там по умолчанию.
Дискретные функции значения не придумывают, а выбирают из имеющихся.
percentile_disc в PostgreSQL возвращает первое значение, на котором накопленная доля строк достигла 90%. Это девятый заказ, 3900.
quantileExact в ClickHouse берёт элемент с номером  , считая с нуля. Это десятый заказ и заодно максимум сегмента.
«Точный» перцентиль в ClickHouse на маленьких выборках систематически смещён вверх, и p90 из десяти строк у него всегда совпадает с максимумом.
PERCENTILE.EXC раскладывает точки иначе, на позиции от 1 до n с запасом по краям, и позиция p90 оказывается 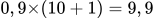 .
Получается
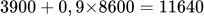
Число 8200 у approx_quantile в DuckDB — это середина между 3900 и 12 500: приближённый алгоритм на десяти точках ведёт себя примерно так же, как метод midpoint из numpy.
Таких определений в статистике девять стандартных, и с версии 1.22 numpy умеет все девять через параметр method, плюс четыре старых варианта для обратной совместимости.
Прогон по всем девяти на наших десяти заказах:
methods = ["inverted_cdf", "averaged_inverted_cdf", "closest_observation",
           "interpolated_inverted_cdf", "hazen", "weibull", "linear",
           "median_unbiased", "normal_unbiased"]
for m in methods:
    print(f"{m:<26} {np.quantile(orders, 0.9, method=m):>7.0f}")
inverted_cdf                  3900
averaged_inverted_cdf         8200
closest_observation           3900
interpolated_inverted_cdf     3900
hazen                         8200
weibull                      11640
linear                        4760
median_unbiased               9347
normal_unbiased               9060
Шесть разных чисел из девяти методов, и у каждого есть учебник, где он назван правильным.
weibull совпадает с PERCENTILE.EXC, inverted_cdf — с percentile_disc, linear — с pandas и PostgreSQL.
Выбор между ними — договорённость, а не поиск истины.
Зачем тогда столько способов?
Интерполяция хороша для денег и времени ответа. Между 3900 и 12 500 рублей есть все промежуточные суммы, и чек на 4760 выглядит обычным чеком.
Для данных, где промежуточных значений не бывает, она даёт странное. Медиана четырёх дат доставки — 1, 2, 4 и 5 октября — в DuckDB получается 3 октября 00:00. В этот день ничего не доставляли, и времени у дат не было.
PostgreSQL такой запрос не выполнит вовсе: percentile_cont принимает только числа и интервалы.
Для дат, оценок от 1 до 5 и номеров версий нужен дискретный метод. Он вернёт значение, которое в данных есть.
Даже одинаковые названия не гарантируют одинаковый результат. Метод nearest в numpy на медиане этих десяти заказов даёт 980, а в Polars — 1200. Позиция медианы 4,5 стоит посередине между двумя заказами, и библиотеки округляют её в разные стороны.
Насколько это важно на реальных сегментах
Сказать «на маленьких выборках методы расходятся» легко, полезнее понять, где кончается «маленькая».
Я сгенерировал миллион заказов с логнормальным распределением чека, похожим на настоящий интернет‑магазин, и много раз вынимал из него случайные сегменты разного размера.
Для каждого сегмента считал p90 всеми девятью методами numpy и смотрел, насколько самый большой ответ отличается от самого маленького:
n=    10  разброс p90 между методами: медиана  46.7%, худший случай 423.1%
n=    30  разброс p90 между методами: медиана  12.8%, худший случай 141.4%
n=   100  разброс p90 между методами: медиана   3.7%, худший случай  50.1%
n=   300  разброс p90 между методами: медиана   1.4%, худший случай   9.4%
n=  1000  разброс p90 между методами: медиана   0.4%, худший случай   2.9%
n= 10000  разброс p90 между методами: медиана   0.0%, худший случай   0.3%
До сотни строк методы расходятся на проценты и десятки процентов, а худшие случаи вообще не про статистику, а про лотерею.
Примерно с тысячи строк разница опускается ниже процента.
Для p99 граница отодвигается: в хвосте лежит меньше точек, и я повторил прогон для него отдельно. Разброс в 2,6% p99 даёт на тысяче строк, в 1% — на трёх тысячах, и та же картина держится на сегментах примерно в десять раз крупнее.
Практическое правило из этого:
Если в дашборде есть фильтр, после которого в выборке остаётся меньше пары сотен строк, метод расчёта перцентиля становится частью определения метрики. Его надо записать рядом с метрикой так же, как записывают, считается ли выручка с НДС.
Медиана, которая меняется при обновлении дашборда
На миллионе строк расхождения методов исчезают, но у ClickHouse появляется своё.
Функция quantile и её псевдоним median используют выборку из резервуара до 8192 значений со случайным генератором, и документация предупреждает, что результат недетерминирован.
Я трижды выполнил один и тот же запрос к одному и тому же файлу:
select quantile(0.5)(x), quantile(0.99)(x) from file('orders.parquet')
1111,10932.89
1098,11407.64
1077,11090.89
Медиана гуляет на 3%, p99 — на 4%. Точный p99 по этим данным — 11 249.
Для дашборда это значит, что цифра меняется при каждом обновлении страницы. Вопрос «почему p99 вырос на 400 рублей за пять минут» приходит раньше, чем кто‑нибудь посмотрит, какой функцией его считают.
Выбор ClickHouse понятен. Выборка из 8192 значений занимает постоянную память и считается быстро на любом объёме. На миллиардах строк это разумный размен, если цифра на дашборде округляется до сотен рублей.
Хуже, когда её показывают с копейками и сравнивают с прошлым часом.
Для стабильного результата в ClickHouse есть три пути:
quantileExactсортирует всё и тратит память пропорционально числу строк, но на маленьких выборках смещён вверх, как мы видели.quantileTDigest— приближённый, но почти стабильный: два запуска дали 11 244,8 и 11 247,0.quantileDeterministicиспользует ту же выборку, только вместо генератора случайных чисел берёт хеш второго аргумента.
Документация просит передавать туда что‑то уникальное вроде идентификатора заказа и предупреждает, что при частых повторах функция «работает неправильно».
Я проверил формулировку буквально и передал хеш самой суммы заказа, которая в миллионе строк повторяется постоянно.
Результат стал стабильным и стабильно неверным: 12 126 при точном значении 11 249.
Перцентили не складываются
Последняя ошибка выглядит как обычная оптимизация. Дневные перцентили посчитали один раз и сохранили в витрину, а недельные и месячные строят уже из неё. Средним, медианой, иногда максимумом.
Я собрал месяц заказов, где будни нагружены, а выходные тихие и с другим средним чеком: 20 000 заказов в будний день и 400 в выходной.
Месячный p95 я посчитал тремя способами:
p95 за месяц по сырым данным         4848
среднее дневных p95                  6171
медиана дневных p95                  4861
Среднее дневных p95 завысило месячный на 27%.
Каждый тихий выходной весит в нём столько же, сколько будний день с объёмом в 50 раз больше, а чек в выходные разбросан сильнее.
Медиана дневных случайно оказалась рядом, но на другой форме недели промахнётся так же легко: у неё нет никакой связи с распределением всех заказов месяца.
То же касается p90 по городу, собранного из p90 по районам, и p95 времени ответа сервиса, сложенного из p95 отдельных подов.
Механизм один.
Перцентиль не помнит, сколько строк за ним стоит. Усреднить его можно только вместе с этой потерей.
Если хранить сырые значения дорого, хранить надо не перцентиль, а состояние алгоритма, из которого его можно получить.
В ClickHouse для этого есть комбинаторы State и Merge:
with daily as (
  select day, quantileTDigestState(0.95)(x) as st
  from file('month.parquet') group by day
)
select quantileTDigestMerge(0.95)(st) from daily
Дневное состояние t‑digest на этих данных занимает около 4 КБ, сливается с состояниями других дней и даёт 4849 при точном 4848.
В PostgreSQL то же самое умеют расширения вроде tdigest, а без них проще хранить сырые значения и считать месячные метрики по ним.
Как договориться о перцентиле
Всё перечисленное лечится одним решением: метод расчёта становится частью определения метрики, а не деталью реализации.
Умение получать результат — только часть работы аналитика. Не менее важно понимать, откуда он взялся и насколько ему можно доверять. Оценить свои знания и увидеть пробелы поможет вступительный тест.
«p90 чека по сегменту» превращается в:
«p90 чека, линейная интерполяция, по сырым заказам, не меньше 200 заказов в сегменте».
Такое описание однозначно переводится в любой инструмент из таблицы в начале:
pandas       s.quantile(0.9)                               # linear по умолчанию
Polars       s.quantile(0.9, interpolation="linear")
DuckDB       quantile_cont(amount, 0.9)
PostgreSQL   percentile_cont(0.9) within group (order by amount)
ClickHouse   quantileExactInclusive(0.9)(amount)
Все пять на наших десяти заказах дают 4760, а quantileExactInclusive(0.5) в ClickHouse — те же 1090, что и pandas.
Порог по размеру сегмента удобно вшить в запрос витрины, чтобы маленькие сегменты не получали цифру вовсе:
select city, count(*) as orders,
       case when count(*) >= 200
            then round(quantile_cont(amount, 0.9)) end as p90
from orders group by city
На тестовых данных с тремя городами Москва с 5000 заказами получила p90 4061, Казань с 900 — 3722, а у Тюмени с 12 заказами в колонке пусто.
Для сегмента из десятка заказов любая из пяти цифр p90 одинаково мало говорит о клиентах, и пустая ячейка тут полезнее любой из них.
Когда метод и порог записаны рядом с метрикой, ноутбук и дашборд начинают сходиться, и расхождение снова означает ошибку в фильтрах или джойнах, а не в том, кто как понимает слово «перцентиль».
Когда одни и те же данные дают разные результаты, важно понимать, что происходит за привычными вызовами функций. Чем лучше разбираешься в инструментах обработки данных, тем проще замечать такие расхождения и находить их причины.
Попрактиковаться в работе с pandas можно на бесплатном открытом уроке:
25 ноября в 20:00. «Освойте искусство обработки Excel‑таблиц с Pandas». Записаться
Другие темы и даты бесплатных вебинаров можно найти в календаре открытых уроков OTUS.