

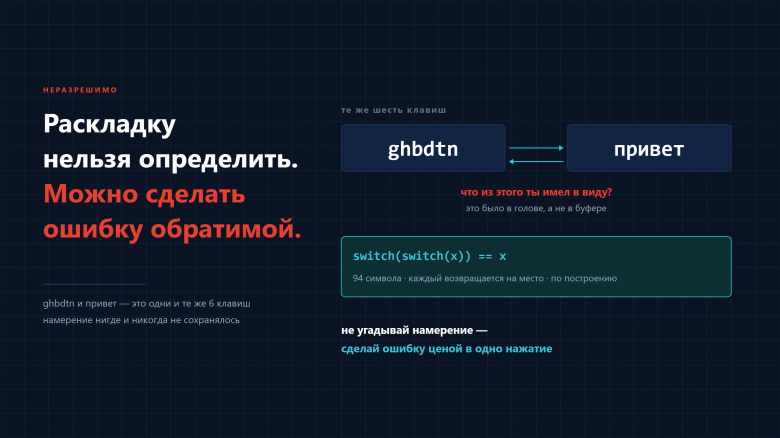
Каждый русскоязычный разработчик когда-нибудь набирал ghbdtn. Это привет с неверной раскладкой — те же шесть физических клавиш, прочитанные другой таблицей. Задача выглядит на один вечер, и часть про конвертацию действительно такая: собрать таблицу символов, применить, готово.
Интересное — в вопросе, на который нужно ответить до конвертации. И ответа у него нет:
Была ли это ошибка?
Потому что ghbdtn — ещё и совершенно валидный идентификатор. Это может быть плохо названная переменная, префикс хеша, ветка в гите, кусок пароля, колонка в легаси-схеме. Ничто в тексте не отличает «я имел в виду привет, и у меня была не та раскладка» от «я имел в виду ровно эти буквы». Нажатия клавиш идентичны. Нужная информация никогда не лежала в буфере — она была в голове у человека в момент набора и не сохранилась.
Я написал под это плагин для IntelliJ (keyboard-magic), и решение, которое сделало его пригодным к использованию, — то самое, которое я бы экспортировал в другие задачи:
Когда намерение восстановить нельзя — перестань его выводить. Сделай операцию инволюцией, гарантированно обратной самой себе, чтобы неверная догадка стоила ровно одно нажатие.
Уверенность недостижима. Дешёвый откат — вполне.
Почему очевидные решения хуже, чем ничего
Инстинкт — поумнеть в детекции. Я прошёл по вариантам; каждый ломается в одну и ту же сторону.
Словарь. Сконвертировать, проверить, получилось ли настоящее слово, конвертировать только если да. В IDE — а плагин живёт именно там — ломается сразу: большая часть текста не является словами ни на одном языке. ghbdtn вполне может быть переменной. А end превращается в утв, которое не слово, — и словарная проверка откажется конвертировать ровно тот случай, когда ты нажал хоткей осознанно.
Частоты биграмм. Посчитать статистику пар букв для обеих интерпретаций, выбрать вероятнейшую. Хорошо работает на абзаце, бесполезно на фрагменте в 4–6 символов, а это и есть реальная единица. У коротких строк почти нет сигнала, и режим отказа молчаливый: оно просто выбирает одно из двух и иногда ошибается, а ты не можешь понять, когда именно.
Порог уверенности. Конвертировать, только когда детектор уверен. Теперь хоткей иногда работает, а иногда молча не делает ничего — худший возможный дизайн взаимодействия для клавиатурного сокращения. Инструмент, отвечающий на один и тот же жест по-разному, отучает собой пользоваться.
Все три ломаются одинаково: они превращают неразрешимый вопрос в догадку, а потом эту догадку прячут. Это та же семья отказов, что и пустой список, читающийся как валидный ответ: система уверенно что-то делает, а увидеть, что она выбрала, нельзя.
Дизайн: определять алфавит, гарантировать инволюцию
Плагин вообще не спрашивает «была ли ошибка?». Он задаёт вопрос, у которого ответ есть — «каким алфавитом написан этот текст?» — и дальше гарантирует обратимость.
/** Converts [text] to the other layout, guessing the source layout from the text itself. */
fun switchLayout(text: String): String = convert(text, detectLayout(text))
А детектор нарочито, почти агрессивно туп:
fun detectLayout(text: String): KeyboardLayout {
    var cyrillic = 0
    var latin = 0
    for (ch in text) {
        when {
            isCyrillic(ch) -> cyrillic++
            isLatin(ch) -> latin++
        }
    }
    return if (cyrillic > latin) KeyboardLayout.RU else KeyboardLayout.EN
}
Посчитать кириллицу, посчитать латиницу, победило большинство, EN при ничьей и на пустом множестве. Это всё.
Два решения здесь несущие.
Пунктуация и цифры игнорируются. Они есть в обеих раскладках, значит не несут информации о том, в каком ты алфавите, — учитывать их означало бы подмешивать шум в единственный имеющийся сигнал. В doc-комментарии сказано прямо: «Punctuation and digits are ignored: they exist in both layouts and would only add noise.»
EN — фолбэк, поэтому функция тотальна. Фрагмент вообще без букв всё равно конвертируется, и конвертируется детерминированно. Ветки «я не знаю» нет, а значит нет и пути, на котором хоткей не делает ничего. Это важнее правильности: предсказуемый инструмент лучше точного, когда цена ошибки — одно нажатие.
Обрати внимание, чего эта функция не делает. Она не определяет ошибку. Она определяет алфавит. Выделишь корректно набранное привет и нажмёшь хоткей — получишь ghbdtn, и это корректное поведение, а не баг: ты сам попросил. У плагина нет мнения о том, стоило ли.
Инволюция — свойство таблицы, а не алгоритма
Чтобы «нажми ещё раз и откатится» было гарантией, а не надеждой, switch(switch(x)) == x должно выполняться для каждого символа. Это нельзя утверждать в месте вызова — это должно быть структурным. Поэтому таблица строится от физической клавиатуры:
private val KEY_ROWS: List<Pair<String, String>> = listOf(
    "`1234567890-="   to "ё1234567890-=",
    "~!@#\$%^&*()_+"  to "Ё!\"№;%:?*()_+",
    "qwertyuiop[]\\"  to "йцукенгшщзхъ\\",
    "QWERTYUIOP{}|"   to "ЙЦУКЕНГШЩЗХЪ/",
    "asdfghjkl;'"     to "фывапролджэ",
    "ASDFGHJKL:\""    to "ФЫВАПРОЛДЖЭ",
    "zxcvbnm,./"      to "ячсмитьбю.",
    "ZXCVBNM<>?"      to "ЯЧСМИТЬБЮ,",
)
Четыре ряда клавиш, каждый выписан дважды — без шифта и с шифтом. Каждая физическая клавиша даёт две пары, и поскольку источник правды — клавиши, а не символы, получающиеся таблицы являются биекцией по построению. Обе стороны собираются одним циклом из одних и тех же рядов, поэтому разъехаться не могут.
Я пересобрал эту таблицу из исходника и проверил: 94 символа в каждую сторону, и каждый round-trip-ится. Без исключений и особых случаев.
И есть охранная строка, которую хочется выделить отдельно, — из тех, что экономят отладочную сессию, от которой никто не получил бы удовольствия:
require(enRow.length == ruRow.length) { "Misaligned layout row: '$enRow' / '$ruRow'" }
Ряды сопоставляются по индексу. Если кто-то добавит клавишу в одну сторону и забудет про другую, каждый символ после этой позиции молча сопоставится не с тем партнёром: таблица останется валидной мапой, код продолжит работать, плагин продолжит «работать» — и тихо портить текст. require превращает это в падение на инициализации класса, с печатью виноватого ряда. Когда корректность структуры данных держится на инварианте, который не выражается типами, проверяй его там, где структура строится.
Та самая штука с пунктуацией, из-за которой будет спор
Самое интересное следствие поклавишного отображения:
"ghbdtn, vbh!"  ->  "приветб мир!"
"ghbdtn? vbh!"  ->  "привет, мир!"
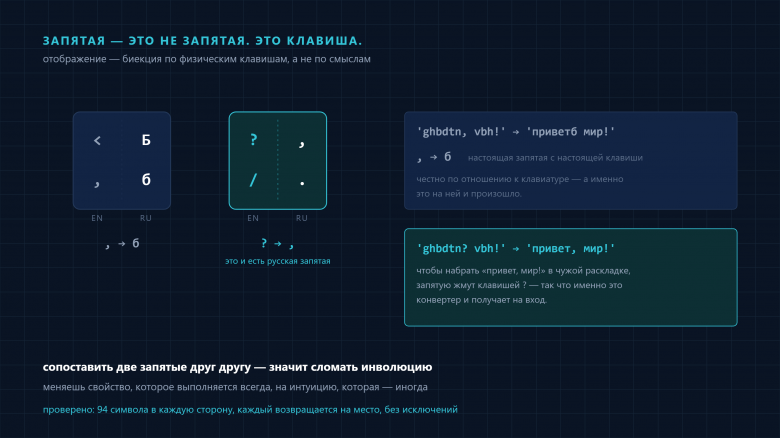
, отображается в б, а запятая в русском набирается клавишей, на которой в английском живёт ?. То есть запятая — не запятая. Это клавиша, и в двух раскладках она значит разное.
Из-за чего важна вторая строка — она и показывает, что дизайн верен: когда ты реально набираешь «привет, мир!» с включённой не той раскладкой, запятую ты жмёшь клавишей ?. На экране оказывается ghbdtn? vbh!, и конвертация даёт привет, мир! — вместе с пунктуацией, идеально.
Первая строка тоже не баг. В ghbdtn, vbh! лежит настоящая ,, пришедшая с настоящей клавиши, а эта клавиша — б. Отображение верно клавиатуре, а клавиатура — это то, что на самом деле произошло.
На этом стоит задержаться, потому что именно эту разницу путают, когда пытаются «починить»:
Таблица — биекция над клавишами, а не над смыслами. Запятая одной раскладки не является запятой другой, и сопоставление двух запятых друг другу сломало бы инволюцию — то самое свойство, на котором держится весь дизайн.
Любой частный случай, отображающий , → ,, отнимает гарантию round-trip у ? и б. Ты меняешь свойство, которое выполняется всегда, на интуицию, которая выполняется иногда. Плохой обмен.
Где были настоящие баги: в редакторе, а не в отображении
Таблица заняла вечер. Экшен — существенно больше, и каждая проблема была про редактор, а не про раскладки.
Какой текст конвертировать
При выделении — очевидно, выделение. Без выделения — слово под кареткой, и «слово под кареткой» надо определить, потому что жмёшь ты это прямо посреди набора:
fun findWordRange(text: CharSequence, offset: Int): TextRange? {
    if (text.isEmpty()) return null
    val caret = offset.coerceIn(0, text.length)

    var start = caret
    while (start > 0 && isWordChar(text[start - 1])) start--

    var end = caret
    while (end < text.length && isWordChar(text[end])) end++

    return if (start == end) null else TextRange(start, end)
}

private fun isWordChar(ch: Char): Boolean = ch.isLetterOrDigit() || ch == '_'
Расширение в обе стороны от каретки означает, что каретка, касающаяся любого края слова, это слово выбирает: работает и когда ты только что дописал (каретка после слова), и когда кликнул перед ним. Два разных пользовательских жеста обслужены одним правилом, а альтернатива — требовать каретку строго внутри — ломается ровно в частом случае, то есть в момент, когда ты замечаешь ошибку, — сразу после набора.
Символы слова исключают пунктуацию намеренно, и компромисс записан в самом комментарии кода: end; конвертируется как end и сохраняет точку с запятой, что в исходниках правильно. Цена — ,jkm (это боль) от голой каретки конвертируется только в оль, потому что ведущая запятая в слово не входит. Такое выделяют руками. Дефолт, верный в коде и слегка неверный в прозе, — правильный дефолт для плагина, живущего в IDE.
Две каретки в одном слове гасят друг друга
В IntelliJ есть мультикаретка, и вот это по-настоящему забавный баг. Две каретки внутри одного слова обе разрешаются в один и тот же TextRange. Конвертируем дважды — и, поскольку операция является инволюцией, получаем исходный текст. Экшен как будто не делает ничего, и не делает он ничего ровно по той причине, которая делает дизайн хорошим.
val seen = HashSet<TextRange>()
return carets.mapNotNull { caret ->
    val range = when {
        caret.hasSelection() -> TextRange(caret.selectionStart, caret.selectionEnd)
        else -> WordFinder.findWordRange(text, caret.offset)
    }
    // Two carets inside the same word would otherwise convert it twice and undo themselves.
    if (range == null || range.isEmpty || !seen.add(range)) null
    else Edit(caret, range, caret.hasSelection())
}
Правки применять справа налево
// Right to left, so the offsets of the ranges not processed yet stay valid.
for (edit in edits.sortedByDescending { it.range.startOffset }) {
    val converted = layoutService.switchLayout(document.getText(edit.range))
    document.replaceString(edit.range.startOffset, edit.range.endOffset, converted)
    ...
}
Вот это универсально и стоит украсть независимо от того, что ты пишешь. Любой пакет правок, посчитанный по снимку, применяется с конца документа назад, потому что правка на смещении 100 инвалидирует все смещения после неё. Здесь замены случайно одинаковой длины, так что сработало бы и так, — и именно поэтому делать правильно стоит всё равно: это корректно по построению, а не по совпадению, а совпадение живёт ровно до следующей фичи.
Рядом: диапазоны собираются до входа в write action, потому что каретки надо читать из документа, который под тобой не изменяется.
Один Ctrl+Z, иначе инструмент бесполезен
WriteCommandAction.runWriteCommandAction(e.project, COMMAND_NAME, null, { ... })
Всё происходит внутри одной команды, поэтому Ctrl+Z откатывает целиком за один шаг. Это не деталь. Инструмент-исправлялка, откат которого занимает пять нажатий, — это инструмент, которому ты перестаёшь доверять, причём перестаёшь сразу после первого раза, когда откатил три конвертации из пяти и сидишь выясняешь, в каком ты состоянии.
И последний штрих, благодаря которому «нажми ещё раз» реально работает:
// Re-selecting keeps the fragment under the caret, so the next press converts it back.
if (edit.hadSelection) {
    edit.caret.setSelection(edit.range.startOffset, edit.range.endOffset)
}
Инволюция — свойство функции. Восстановление выделения — то, что делает её свойством взаимодействия. Без него математическая гарантия существует, а пользователь до неё не дотягивается.
Три вещи про платформу IntelliJ, стоившие мне времени
Не про это статья, но такого нигде не написано, и оно само по себе окупает вход.
Версия Kotlin API должна совпадать с той, что везёт IDE, а не с той, что стоит у тебя. IDEA 2022.2 поставляется со стандартной библиотекой Kotlin 1.6, поэтому в сборке стоит apiVersion = 1.6. Без этого компилятор радостно примет вызовы из более новой stdlib, а плагин умрёт в рантайме внутри IDE, где такого метода нет. Пиннинг версии API превращает NoSuchMethodError в чужой IDE в ошибку компиляции на твоей машине — обмен, который нужен всегда.
platformLocalPath падает под C:\Program Files. Указать сборке на установленную IDE вместо скачивания SDK можно, только если каталог установки доступен на запись: gradle-intellij-plugin кладёт рядом с IDE Ivy-дескриптор. Под Program Files это «Could not write to file», и формулировка ошибки на причину не указывает. В репозитории SDK по умолчанию скачивается именно поэтому.
Твой дефолтный хоткей уже занят. Ctrl+Shift+R — это Replace in Files, Cmd+Shift+R на macOS — это Run…. IDEA не отказывает, она показывает диалог выбора — то есть первое впечатление от плагина — модалка с просьбой выбрать. По-настоящему свободных сочетаний в современной IDE нет, поэтому честный ход — задокументировать конфликт и объяснить, как перевесить, что README и делает.
Обобщение
То, к чему я с тех пор постоянно возвращаюсь, — вообще не про клавиатуры:
Когда вход по-настоящему неоднозначен, вариантов два. Угадывать хорошо и прятать это — или угадывать дёшево и сделать исправление бесплатным. Второе почти всегда лучше и почти никогда не строится.
Угадывать хорошо — интересная инженерная задача. Там живут словарь, частотная модель и порог. И получается инструмент, который прав в 95% случаев и молча неправ в 5%, причём пользователь не может предсказать, в каких.
Угадывать дёшево — большинство букв, EN при ничьей — даёт инструмент, который прав чаще всего и тривиально поправим в остальных случаях, потому что поправка — то же самое нажатие, которое всё и вызвало. Пользователю вообще не нужно знать, как сделана догадка. Он просто жмёт ещё раз.
Решение на 95% оптимизирует не ту переменную. Оно оптимизирует, как часто ты прав, — тогда как приятность инструмента определяется тем, сколько стоит быть неправым.
Где я искренне хочу возражений: я объявил детекцию неразрешимой и остановился на подсчёте букв. Кто-нибудь справедливо заметит, что IDE знает сильно больше, чем буфер, — PSI-дерево, находится ли каретка в строковом литерале или в идентификаторе, язык проекта, во что резолвится символ. Исправлялка, конвертирующая внутри строк и комментариев и никогда — внутри идентификаторов, была бы права чаще, и платформа ровно для такого и сделана.
По-моему, это меняет свойство на эвристику: оно перестаёт быть инволюцией, на которую можно опереться, и становится инструментом, ведущим себя по-разному в зависимости от того, где каретка, — той самой непредсказуемостью, от которой я и уходил. Но держусь я за это некрепко.
Вы бы взяли контекстно-зависимую версию, если бы она была права в 99% и непредсказуема в остальном, — или «всегда делает одно и то же, всегда откатывается одним нажатием» здесь стоит дороже точности?
Комментарии (6)

aleksandy
31.10.2026 19:58Вопрос на мульён: а как часто требуется этот функционал в IDE? Вот во всяких чятиках - вопросов нет, а в IDE - как будто бы и незачем.

AndrewBond
31.10.2026 19:58у меня идешки всякие стоят в исключениях punto. Запариваюсь отменять ложные срабатывания.


iSvet
31.10.2026 19:58Интересная статья, спасибо
Читаю и радуюсь, что перестал пользоваться авто переключателем, когда научился слепой печати
tema_rebel
кто-то изобрел punto switcher?
datacompboy
который вполне себе угадывал в 99% практических случаев :) и да, частотый анализ позволял встарь отлично “угадывать” и кодировку, и язык, и даже каскадные кодировки…