

Казалось, что для голосового заказа достаточно добавить в платёжный терминал распознавание речи. Так мы думали в Эвоторе, когда начинали проект EvoPoint.
На деле разработка голосового пинпада не ограничилась подключением готовой библиотеки. Пришлось решить несколько задач:
➡️ борьба за каждый мегабайт оперативной памяти;
➡️ война с шумом профессиональной кофемашины;
➡️ кастомная оркестрация платёжных сценариев;
➡️ поиск компромисса между «умным» и «холодным» железом;
➡️ ну и как-то успокоить кассира-бариста.
Владимир Графсков, техлид интеграционных проектов Эвотора, делится, как мы разрабатывали пинпад, который принимает заказы голосом. Первый материал на Хабре про EvoPoint здесь.
Как выглядит архитектура EvoPoint
Если голос распознается быстро, но экран клиента зависает на отрисовке подтверждения, быстрое распознавание уже не помогает пользователю. Поэтому нам нужно было согласовать работу распознавания, интерфейса и оплаты. EvoPoint - это не одно приложение с нейросетью, а несколько взаимодействующих компонентов. Нам пришлось построить архитектуру, в которой они должны работать согласованно. Чем больше компонентов нужно синхронизировать между собой, тем выше риск ошибок при их взаимодействии.
Мы разделили систему на несколько независимых контуров:
Voice Recognition. Локальный модуль распознавания, который превращает звук в текст.
Customer Screen. Интерфейс, который показывает состояние обработки и выводит варианты заказа.
Orchestrator. Мозг системы. Он держит контекст, матчит распознанные слова с меню и решает, когда пора переходить к оплате.
Payment Engine. Изолированный и защищённый слой для проведения транзакций.
Чтобы отслеживать работу компонентов, мы добавили подробное логирование. Голосовой интерфейс - штука капризная, одной обработки исключений оказалось недостаточно. Важно сходу понимать, почему система не поняла клиента: она его не услышала? Услышала, но не нашла товар в базе? Или нашла, но сломалась на этапе фискализации?
Для этого мы настроили логирование каждого шага по oper_uid. Каждое событие, например, VOICE_MATCHED или PAYMENT_STARTED, падает в локальную базу, которую затем можно обработать. Именно событийность стала киллерфичей, которая и позволила разрушить все сложности разработки. Если бы нельзя было прокрутить назад любой неудачный сценарий и понять, где именно возник затык, мы бы никогда не выпустили команду прогеров из мягкой комнаты.
Проблема 1️⃣. Умному ИИ не хватает места
На старте разработки мы рассчитывали использовать готовую модель без существенных доработок. В реальности embedded-разработка накладывает жёсткие ограничения.
Ключевое - терминал должен работать автономно. Мы не можем позволить себе роскошь отправлять каждый аудиопоток в облако: это долго, дорого и требует идеального Wi-Fi, которого в малом бизнесе часто не бывает. На борту железа всё разрулить тоже трудновыполнимо, процессор на плате - это не десктопный i7 и уж тем более не серверная GPU.
По итогу получаем задачу со звёздочкой на решение нескольких переменных. Нужно создать ASR-решение (Automatic Speech Recognition), работающее:
Локально. Минимизация зависимости от интернета. Терминал должен принимать заказы даже в подвале с отвалившимся LTE.
Быстро. Инференс должен происходить в реальном времени, чтобы поддерживать естественный темп диалога.
Стабильно. Модель не должна занимать всю оперативную память и нарушать работу других процессов.
С предсказуемым SLA. Нам нужно понимать время распознавания при заданной длине фразы и нагрузке на устройство.
Для решения этого уравнения мы устроили внутренний бенчмарк, сравнивая несколько популярных голосовых модулей: Vosk, T-1, Whisper, включая версию Tiny и ещё пару не популярных моделей.
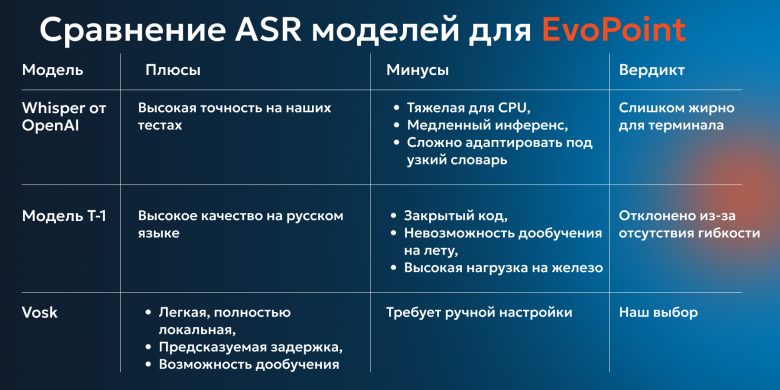
Вот к каким выводам мы пришли в процессе тестирования.
Whisper от OpenAI. Несмотря на хайп и действительно любопытные результаты в точности на синтетических тестах, реальность оказалась суровой. Модель слишком тяжёлая и даже тесты версии Tiny показали, что нагрузка на процессор превышала наш допустимый уровень, а время инференса не вписывается в наши лимиты для edge-устройства. Сложность интеграции также стала дополнительным ограничением.
Модель Т-1. Показала обнадёживающие результаты по качеству распознавания в специфичных кассовых сценариях. Однако она тоже плохо уживалась с аппаратными ограничениями терминала. Плюс могли возникнуть нюансы с дообучением модели в боевых условиях.
Vosk. Сходу вписался в парадигму edge-вычислений, где ресурсы CPU и RAM строго лимитированы. Жирным плюсом стала возможность расширения модели (Fine-Tuning). Мы можем подкладывать графовые файлы прямо в рантайме, адаптируя словарь под конкретное меню кофейни или ассортимент магазина, что критически важно для точности мэтчинга товаров.
Ситуация оказалась как в меме, когда отличник хорошо учится, чтобы затем устроиться на работу к середняку-троечнику. Одного качества распознавания было недостаточно для выбора модели. Для нашего терминала также были важны расход ресурсов и возможность адаптации под ассортимент.
В итоге мы остановились на Vosk как на наиболее подходящем для ограничений нашего терминала. Мы можем адаптировать распознавание под названия товаров, и он будет работать молниеносно даже на скромном процессоре терминала.
Проблема 2️⃣. Распознавание речи рядом с шумным оборудованием.
Лабораторные тесты не показали всех проблем. В тихом офисе EvoPoint понимал шёпот. Но как только мы дошли до альфа-тестов в боевых условиях, реальность больно щёлкнула по носу.
Что делать когда аудио такого качества?
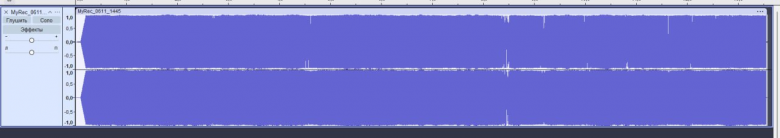
В кафе на микрофон обрушивается спектральный хаос.
➡️ Шипение капучинатора - практически белый шум идеальной плотности, который вырезает целые частотные диапазоны человеческого голоса.
➡️ Громкая фоновая музыка, особенно с выраженными басами.
➡️ Разговоры людей в очереди, которые ASR упорно пытается превратить в позиции чека.
➡️ Стеклянные витрины и кафельный пол создают реверберацию голоса.
Для решения сразу на ум приходит гипотеза двух микрофонов. Один пишет голос, второй - окружающий шум, мы вычитаем одно из другого и получаем чистый сигнал. В теории - да. На практике - микрофоны в терминале стоят слишком близко друг к другу, и фазовые искажения превращают результат в нечто, напоминающее голос робота из 80-х.
Конечно, можно было бы поставить в EvoPoint студийный микрофон-пушку с активным меховым фильтром, но тогда стоимость терминала выросла бы в 1,5–2 раза. А наша задача - сделать устройство массовым, а не продавать его по цене подержанного автомобиля.
Проблема 3️⃣. Постоянное распознавание: нагрузка и ложные срабатывания.
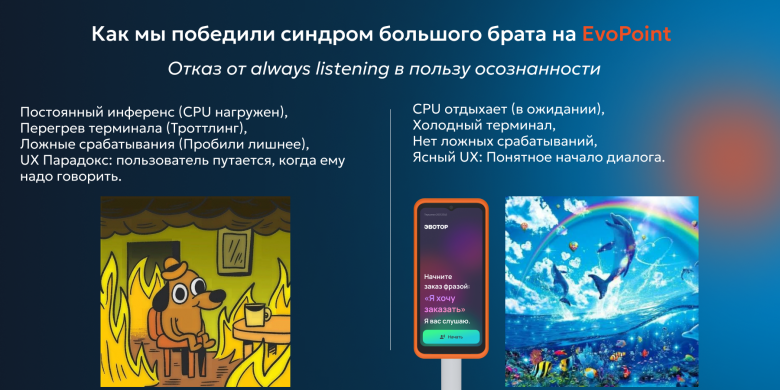
Сначала казалось удобным, чтобы терминал постоянно был готов принять заказ. На практике постоянное распознавание создало несколько проблем.
Перегрев. Терминал превращался в обогреватель. Постоянная работа ASR-модуля грузила CPU на 70–80%. При этом работа 24/7 просто избыточна: когда в кофейне нет очереди, микрофоны пишут фоновую музыку, а процессор судорожно пытается разобрать слова. А вы знаете, насколько разборчивы современные треки.
Ложные срабатывания. Терминал пытался пробить «латте» каждый раз, когда бариста обсуждал заказ с коллегой ("ладно"). Два латте! Латте? Да, латте!
Приватность. Отсутствие чёткой границы «а уже можно говорить?» убивало доверие к интерфейсу. Клиенты нервничают, когда видят устройство, которое постоянно бдит аки око Саурона.
Мы перешли к явной активации. У пользователя есть два пути: нажать кнопку или произнести стартовую фразу. Как только срабатывает один из триггеров, интерфейс меняется, показывая пользователю: «слушаю, Господин!».
Проблема 4️⃣. Проклятие «латте» и лингвистическая неопределённость.
Распознать слово «латте» недостаточно. Затем нужно сопоставить его с ассортиментом конкретной точки. У одной кофейни в базе может быть пять видов латте разного объёма и с разными сиропами.
Мы поняли, что голосовой интерфейс в ритейле - это не монолог, а диалог. Голосовой сценарий в EvoPoint должен прогонять заказ через многоуровневый фильтр:
Словарь алиасов. Клиенты не говорят названиями из 1С. Они говорят «чёрный кофе», «американо побольше» или «тот самый холодный чай». Поэтому нужна система синонимов, которая связывает разговорную речь с жёсткой номенклатурой.
Если клиент говорит «кофе с молоком», система должна понимать, что в данной конкретной точке это соответствует позиции «капучино 0.3». Это требует сложной логики сопоставления с меню, текущим состоянием корзины и модификаторами. В противном случае толку-то от неё?
Логика модификаторов. Самое сложное - это добавки и топпинги. «Латте без сахара, но с двойным сиропом на альтернативе» - для нейронки это набор токенов, а для нас это сложная древовидная структура, где модификаторы должны приклеиться к правильному родительскому объекту.
Проблема 5️⃣. Троттлинг и NPU
Отказ от постоянного распознавания снизил нагрев, но во время приема заказов пинпад все еще нагревался. В час-пик при серии заказов подряд, процессор из-за перегрева, мог снизить рабочую частоту троттлингом. Снижение частоты ограничивало нагрев, но увеличивало задержку ответа.
Задержка распознавания растёт с 200 мс до 2 секунд. Пользователь не понимает, что происходит, начинает повторять фразу, создавая ещё большую нагрузку. Как итог, виноватым окажется бариста, который стоит возле кофемашины и не видит, как пользователи уже пинают терминал ногами.
При попытке перенести нагрузку на NPU (Neural Processing Unit), выяснилось, что это требует преобразование модели под RNNT формат, что в свою очередь убирало возможность Fine-Tuning для конкретной модели, а это было одним из главных аспектов выбора Vosk как голосового модуля распознавания.
Писать свою версию - это отдельный R&D проект на полгода по пересборке, квантованию и адаптации модели под конкретный SDK производителя чипа
В итоге мы пошли по пути оптимизации софта:
Ограничили частоту дискретизации аудио.
Оптимизировали библиотеку инференса под ARM-инструкции.
Настроили агрессивный менеджмент фоновых процессов во время работы голосового сценария.
Так сказать, выбрали путь инженерного реализма и начали подрезать хвосты везде, где это возможно. Голосовой модуль получает приоритет только в момент активного диалога - когда пинпад слушает. Провели оптимизацию всех фоновых процессов, для того чтобы терминал оставался в допустимом температурном режиме.
Проблема 6️⃣. Согласовать голосовой заказ и оплату
Отдельной задачей стал переход от голосового заказа к оплате. Технически оплата предполагает целую цепочку синхронных и асинхронных событий: от инициализации терминала до получения ответа от эквайера и фискализации в облаке или на ФН.
Голосовой модуль не может напрямую общаться с банком, поэтому нужен посредник, который возьмёт на себя роль дирижёра. Нам нужен собственный слой оркестрации под ряд задач.
Заморозка контекста. Состав и сумма заказа должны быть зафиксированы. Во время оплаты голосовые команды не должны менять оплачиваемый заказ.
Диспетчеризация команд. Отправка чёткой структуры данных в платёжный шлюз.
Обработка прерываний. Что делать, если во время прикладывания карты клиент передумал? Или если банк вернул отказ? Оркестратор должен корректно вернуть пользователя в голосовой сценарий или предложить другой способ оплаты.
Фискализация. Передача данных в облачную кассу и печать или отправка чека.
Телеметрия. Запись событий платежного сценария.
Для разбора платежных ошибок нужна последовательность событий. Мы внедрили жёсткую событийную модель, где у каждой транзакции есть свой идентификатор - oper_uid.
Благодаря сквозному логированию по oper_uid, мы можем восстановить всю цепочку событий: от первого «Привет, Эвотор» до финального сигнала об успешной печати чека. Мы видим, на каком именно этапе произошел сбой.
Проблема 7️⃣. Добавить больше смысла
Мы проектировали EvoPoint с прицелом на голосовой модуль. Мы ориентировались на кофейни, АЗС и фудтраки, где голос экономит секунды бариста и кассиру, но позже поняли, что бизнес-потребности не покрываются только приёмом заказов голосом
Так в EvoPoint начали появились дополнительные сценарии на основе существующей архитектуры.
Интерактивная оценка качества. После оплаты терминал предлагает оставить обратную связь. Клиент может оценить качество обслуживания, а оценка привяжется к чеку.
Речевая аналитика (Speech Analytics). Раз уж у нас есть микрофоны и локальный ASR , почему бы не анализировать работу самого персонала? Мы заложили основу для проверки стандартов обслуживания по диалогам: поздоровался ли кассир, предложил ли дополнительный товар, соблюдал ли вежливость. Это чёрный ящик для бизнеса, который работает 24/7 без участия проверяющих.
Open API. В перспективе хотим дать сторонним разработчикам возможность создавать приложения и настраивать пинпад под свои сценарии: Кафе, СТО, такси.
Так EvoPoint прошёл путь от нишевого эксперимента до универсального хаба, который слышит, понимает и помогает бизнесу расти.
Когда простота - самая сложная инженерная задача
Мы разрабатывали EvoPoint для самостоятельного голосового заказа. Это инструмент, который должен увеличить пропускную способность точки. Пока бариста готовит кофе, терминал сам принимает следующий заказ, уточняет детали и проводит оплату.
Ключевые выводы проекта:
Система важнее модели. Качества распознавания недостаточно, если у вас плохая акустика или перегретое железо.
Embedded - мир компромиссов. Для нашего терминала стабильность и низкая задержка были важнее выбора более ресурсоемкой модели.
Голос - это платформа будущего. Сегодня это приём заказов, а завтра - речевая аналитика, оценка качества обслуживания и интерактивная реклама.
Как всегда, самый сложным оказалось собрать всё так, чтобы на выходе это выглядело просто для пользователя. Но, кажется, всё получилось.