

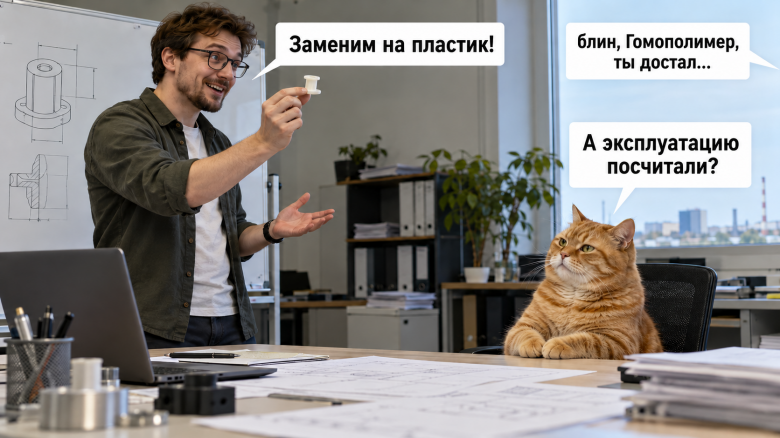
Любой команде нужен человек, который вовремя испортит всем удовольствие. Идея почти согласована, а он спрашивает: «А откуда эти цифры?», «А это точно разрешено?», «А у похожего бренда ведь не получилось...»
Просить его помолчать не стоит, особенно перед запуском большого и дорогого проекта.
В СИБУРе мы поняли ценность такого коллеги, когда делали систему для оценки идей замены материалов: модели нужен оппонент, который проверит, на чём держится её убедительный ответ. Так среди агентов появился критик.
Меня зовут Елена Солдатова, я старший менеджер ключевых проектов развития рынка и электронной коммерции. Более 14 лет я работаю в ИТ как владелец продуктов и руководитель программ цифровизации. В этой статье расскажу, как наша система оценила медицинскую упаковку по строительным нормам и что пришлось переделать, чтобы сервисом захотели пользоваться эксперты. Деталями о технической стороне проекта поделится Дмитрий Твердохлебов, основатель Omnius.team.
Зачем нам это вообще было нужно?
Немного вводных: СИБУР производит нефтехимическое сырьё, а наши клиенты делают из него готовые изделия для десятка отраслей — пищевую упаковку, плёнку и пакеты, медицинские шприцы, ящики для фруктов, трубы, окна и многое другое.
Чтобы расширять применение полимеров, мы постоянно задаём себе вопрос: какие ещё изделия можно сделать полимерными? Это субституция — замена одного материала другим. Но между идеей и решением — большое исследование: свойства материалов, условия работы изделия, потребность рынка, нормативные требования и экономика замены. По каждой гипотезе сведения собирают из разных источников, сопоставляют и проверяют, применимы ли они к конкретному изделию.
Допустим, условную металлическую деталь предлагают сделать полимерной, чтобы уменьшить вес. Выдержит ли она нагрузку и рабочую температуру? Допустима ли замена по нормам? Сколько изделие будет стоить за всё время использования?
И главное, нужна ли она кому-то, даже если на все вопросы выше мы ответили «да»?
Поэтому каждую идею проверяем сразу с нескольких сторон.
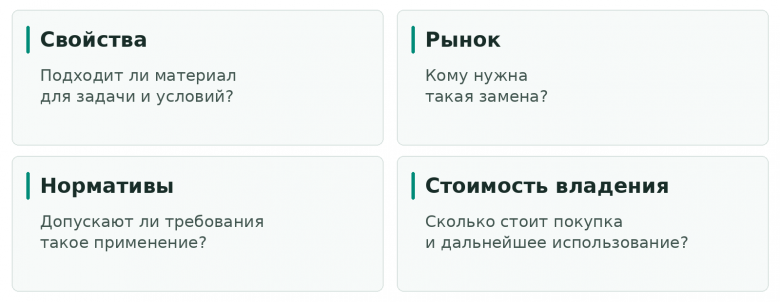
Сойтись должно всё сразу: материал с подходящими свойствами может упереться в ограничения, а технически интересная замена — не иметь никакого экономического смысла.
Для этой исследовательской работы мы и собрали мультиагентную систему. Человек задаёт идею замены, агенты собирают сведения, оценивают её по разным направлениям и проверяют аргументы друг друга. Результат изучает эксперт и решает, достаточно ли оснований двигаться дальше, или нужны дополнительные данные.
Раньше оценка идеи занимала в среднем 88 рабочих дней: собрать информацию, разобраться в ней, проверить выводы, пройти согласования. Теперь с системой — до двух недель вместе с проверками и согласованиями.
Впечатляет? Ещё бы. Правда, далось это непросто.
Как выстроить архитектуру правильно?
Наша система прошла несколько этапов. В марте этого года мы тестировали первую версию. Затем вместе с экспертами дорабатывали исследовательскую логику, архитектуру и настройку под разные отрасли. За следующие месяцы проект прошёл три глубоких рефакторинга и два ускорения.
Первые ответы выглядели обнадёживающе, но, когда результат попадал к эксперту, начинались вопросы.
Где-то потерялась важная деталь. Тут упомянута не та нормативка. А здесь сравнили цены материалов и сделали вывод о выгоде, не учтя расходы на эксплуатацию.
Хуже всего то, что по самому ответу ошибку не заметишь: он подробный, логика, на первый взгляд, стройная. Вот только решение по нему принимать нельзя.
Поэтому мы разделили работу.
В нашей системе 16 шагов: 14 ИИ-этапов и две детерминированные фазы. Агенты-исследователи собирают аргументы по разным направлениям, а критик проверяет, выдерживают ли они проверку, не упущены ли ограничения, достаточно ли данных для вывода и нет ли противоречий между частями анализа.
«Основной движок у нас работает на семействе моделей Google Gemini: Pro используем для сложных контекстных рассуждений, Flash — для более простых задач. Критиком выбрали Claude: он хорошо справлялся с проверкой, но выполнять на нём всю работу было бы слишком дорого.
Для обогащения запроса и поиска контекста используем Perplexity на Sonar Pro. Если сервис недоступен или возвращает подозрительно мало информации, переключаемся на Sonnet с Web Search от Anthropic. Но это резервный вариант: он работает медленнее и обходится примерно в пять раз дороже», — говорит Дмитрий Твердохлебов.
Возьмём экономику. Исследователь пишет: материал дешевле — значит, замена выгодна. Критик проверяет, что именно сравнивали. Если только закупочную цену, то до вывода о стоимости владения ещё далеко.
Критик, увы, тоже может ошибаться, поэтому живой эксперт проверяет и исходные аргументы, и замечания к ним. Но искать слабые места теперь — отдельная задача системы до того, как отчёт попадёт к человеку.
Что в результате: агенты выставляют баллы по своим направлениям, а итоговый вердикт определяется по заданным правилам.
В зависимости от баллов вердикт может быть разным: «только пилот», «нужна проверка» или «не заменять». Так человек понимает, какое действие следует из анализа: испытать идею в ограниченном масштабе, разобраться с недостающими сведениями или отказаться от замены и забыть как страшный сон.
Расскажу чуть подробнее про роль критика. Он формулирует возражения: какой вывод нужно оспорить, почему, насколько серьёзен риск и какие данные или испытания нужны для проверки. Эти замечания попадают в итоговый синтез и могут изменить рекомендацию: сузить область применения, добавить обязательные условия, ограничить замену пилотом или дать основание для отказа.
Пример. В одном из прогонов по многослойной полимерной упаковке критик усилил уже ранее известный риск: после стерилизации материал может расслоиться и потерять барьерные свойства. Критик указал, что нужны испытания до и после обработки. Благодаря этому рекомендация получила статус «только пилот».
Отмечу, что бесконечного спора здесь нет — есть только один этап критики. Повторное исследование запускает уже эксперт: добавляет уточнение и пересчитывает нужный раздел. А ещё, если синтез не принимает предложенное критиком основание для отказа, он должен явно объяснить причину.
Так система научилась охлаждать наш энтузиазм. Но выяснилось, что сделать это можно и по-другому.
Маленькая история большого косяка
Начинали мы со строительной тематики. При переходе в другие отрасли оказалось, что просто подставить в запрос новое изделие недостаточно.
В одном из разборов система оценивала медицинскую упаковку по строительным СНиПам. Нормативный анализ в ответе был, но к нашему вопросу не подходил. Отраслевику промах очевиден, а системе нужно объяснить, какие требования относятся к этому применению и на какие документы опираться.
Так появилась настройка под сегмент. Эксперт один раз подробно отвечает на вопросы в интерфейсе, исправляет сведения и добавляет документы. Дальше этими данными пользуются коллеги. Им не нужно заново объяснять системе особенности своей области, а агентам есть на что опереться.
Ещё одна история очень буквально указала на ограничения сервиса. Знаете, что такое обечайка?
Это оболочка вокруг стаканчика — например, со сметаной. Подходящего сегмента в каталоге системы не было, поэтому оценить гипотезу замены не удалось.
Стало понятно: пользователям нужна возможность добавлять новые сегменты. Нельзя один раз объяснить системе, что такое упаковка, и ожидать одинаково полезного анализа для любого её вида. Мы всё равно возвращаемся к конкретному изделию: что оно делает, в каких условиях используется и какие к нему требования.
Для разработки это разумно, а для пользователя — не очень: он пришёл за готовым ответом, а его просят помочь инструменту разобраться в задаче. Хотел сэкономить время, а приходится его тратить. Поэтому настройку упростили и объяснили: пользователь должен понимать, зачем вопрос и как ответ поможет в следующих разборах.
В общем, переход к новым отраслям стал совместной работой с экспертами. Они помогали настроить систему, а заодно находили ошибки...
Из чего выросли три правила системы?
АБС-пластик + тормоза = ?
В одном из ответов АБС-пластик превратился в «тормоза»: модель узнала знакомую аббревиатуру, но выбрала значение из другой области.
Можно посмеяться и исправить, но ошибка в названии меняет весь разбор: система ищет не те свойства и делает выводы не о том объекте. Хорошая структура отчёта сама по себе это не исправит.
Так появился отраслевой словарь. Термины нужно объяснять системе в контексте материалов и их применения: эксперт понимает их почти автоматически, а модели этого навыка пока не хватает.
Побочный эффект погружения в полимерную терминологию: Дмитрий временно стал звать кота Гомополимером. К коту годами не прилипала ни одна кличка — он отзывался только на «кот» и «котя». Спойлер: «Гомополимера» он тоже проигнорировал. Зато какой опыт для всех нас, включая кота.
Дешевле купить !== дешевле использовать
Другая ошибка была серьёзнее: расчёт упускал стоимость эксплуатации.
Допустим, вариант дешевле на старте, но его чаще приходится обслуживать или менять. Остановившись на цене покупки, можно выбрать решение, которое в итоге обойдётся дороже.
Поэтому понадобилась методика стоимости владения: что включать в затраты и за какой период сравнивать варианты. Иначе в одном разборе «выгоднее» будет означать дешёвый материал, а в другом — меньшие расходы за всё время использования.
Правило такое: если данных об эксплуатации не хватает, это видно в результате — и эксперт понимает, что перед ним предварительная оценка, которую ещё предстоит дополнить.
Ссылка на норму vs вопрос закрыт
В одном из случаев агент сослался на отменённую норму: нашёл документ, вставил ссылку в отчёт и сформулировал на этой базе вывод. Но опираться на него при решении о замене было нельзя.
Так появилось правило проверки актуальности нормативных документов. Найти подходящий по теме текст — это только часть работы. Нужно ещё выяснить, можно ли использовать его прямо сейчас.
Снова вспомню медицинскую упаковку: у нормы проверяем и актуальность, и применимость. Действующий строительный документ не станет подходящим для другой отрасли только потому, что его не отменили.
Как превратить красивое демо в рабочий инструмент?
Здесь помогли три свойства.
Первое — скорость. Ожидание результата оставалось долгим. Нужно разобраться в настройке, запустить анализ, дождаться результата и проверить его. Чем сложнее этот путь, тем труднее встроить инструмент в повседневную работу.
Поэтому мы упростили настройку, добавили понятную инструкцию и занялись скоростью: чем больше действий до первого полезного результата, тем сложнее начать пользоваться системой.
Что конкретно сделали: независимые поисковые вызовы внутри одного раунда агента стали выполнять параллельно. Одновременно запускаются и две пары независимых этапов: нормативная проверка с расчётом экономики и анализ рынка со сравнением потребительских качеств.
А ещё мы дополнительно ограничили ожидание отдельных вызовов и число поисковых раундов на некоторых этапах, сократили объём загружаемых страниц и убрали дублирование данных в контексте итогового синтеза. Так мы сокращаем последовательное ожидание и риск затяжных прогонов.
Второе — объективная польза. Система должна помогать проверять гипотезы и принимать решения по проектам. За отчётом стоит исследование: поиск источников, проверка свойств материала, нормативов и экономики замены. Если агенты провели его неверно, эксперт заново собирает данные и проверяет гипотезу вручную — и быстрый прогон времени не экономит.
Отчёт должен помогать в проектах развития: в одном случае — переходить к пилоту, в другом — собрать недостающие данные, в третьем — отказаться от замены и не тратить на неё следующие месяцы.
Поэтому «не заменять» — тоже полезный результат. Система не обязана поддерживать любую идею с полимером: важно понять, какие идеи выдерживают проверку и куда имеет смысл двигаться дальше.
Третье — стабильность, которую обеспечивает постоянная поддержка инструмента. Новые сегменты, документы, замечания экспертов и смена моделей требуют работы после запуска: один раз настроить анализ на все случаи нельзя.
Со стороны кажется, что мы всего лишь автоматизируем сбор информации. Но приходится разбираться буквально во всём: как рассуждает эксперт, почему доверяет одному аргументу и сразу отбрасывает другой, где замечает ограничение, когда неспециалист видит вполне хороший ответ.
Вопросов ещё много, гораздо больше, чем ответов.
А дальше куда?
Дальше хотим подключать новые отрасли, ускорять анализ и перейти к самостоятельному поиску идей замены материалов. Как и с людьми: рано или поздно хочется, чтобы коллега не только выполнял поручения, но и сам что-то предлагал.
Пока система помогает проверить идею, с которой пришёл человек, но хотим поручить ей и поиск таких возможностей.
Многим кажется, что лучший ИИ — тот, который быстро помогает находить решение. А мне стало ясно, что во многих делах, которые мы делегируем ИИ, важнее его способность возразить: «А почему вы вообще решили, что это сработает?»
Благодаря этому вопросу идею ещё можно проверить до пилота и затрат. Так что коллегу, который портит всем удовольствие своей духотой, мы точно оставляем в команде.
А как бы вы строили такую систему? Выделяли бы критика в отдельного агента? Какие модели выбрали бы и как проверяли бы, что спор помогает находить ошибки? Ну и главный вопрос.
А вы знали, что такое обечайка?