

Доброго времени суток! Меня зовут Дмитрий Созинов, я Senior DevOps в команде платформы ядра банка. Мы разрабатываем общие решения для команд ядра банка: пайплайны, Helm-чарты и Java-библиотеки, сервисы для интеграции с ядром, общую инфраструктуру для логирования и трейсинга.
Приглашаю вас окунуться в страшную историю о том, как мы посреди тёмной ночи, пока никто не видит, на велосипеде перевезли 400 сервисов между кластерами KaaS. И всё это с возможностью отката.
А всё потому, что три месяца хорошо готовились: переносили окружения одно за другим, оттачивали процесс, ловили и исправляли возможные точки отказа. Мы перебрали несколько готовых инструментов, но в итоге всё-таки сделали свой велосипед. Его конструкция оказалась столь хороша, что пригодилась нам ещё несколько раз. Но это уже совсем другая история...
Постановка задачи
В какой-то момент команда Compute, которая предоставляет нам Kubernetes-as-a-Service, объявляет, что нынешние кластеры устарели и пора мигрировать на новые. Мы, конечно, удивляемся такому манёвру, но виду не подаём и идём собирать инфу о масштабе предстоящих работ.
На календаре видим, что до дедлайна остаётся около четырёх месяцев. Намечаем карандашиком переезд прода через три, чтобы оставить место для манёвра на случай, если что-то пойдёт не по плану.
По итогам сбора информации получаем примерно такую картину:
Дано:
~400 сервисов, развёрнутых через Helm общим пайплайном, некоторые более года назад
25+ неймспейсов
5 кластеров (1 test, 2 preview, 2 prod)
МНОГО КОФЕ
Нюансы:
В новых кластерах более строгие политики безопасности
Некоторые манифесты были изменены вручную (кто без греха — пусть первый бросит камень)
Не все приклады умеют работать более чем в одном инстансе
Подключения к БД конечны
Поэтому просто раскатать всё в новых кластерах не получилось бы. Нужно было подменить упоминания старых кластеров, дописать недостающие блоки в манифесты, не потерять ручные изменения, как правило учётные данные, и предусмотреть ограничения по количеству одновременно работающих инстансов.
При этом мы хотели сохранить возможность отката на старые кластеры, а в идеале ещё и научиться откатывать версии релизов через helm rollback.
Едим слона по частям
Для начала собираем информацию по всем внешним зависимостям и заказываем сетевые доступы.
Пока ждём выполнения этих заявок, сортируем сервисы, определяем порядок переезда, планируем скейлинг с учётом количества подключений к базам и взаимосвязей сервисов (вот и пригодились архитектурные схемы).
Примерно на этом этапе нужно ответить на самый интересный вопрос: каким инструментом переносить манифесты? По сути, нам нужно взять простыню текста из одного кластера, немного над ней пошаманить и положить в другой кластер. Звучит как задача, которую уже решали другие инженеры. Наверняка в опенсорсе есть что-то на этот случай.
Opensource, я призываю тебя!
В результате тщательного гугления и обдумывания получаем примерно такой список:
GitLab CI-пайплайн. Казалось бы, самый очевидный вариант. Пайп у нас обкатан, работает надёжно, зачем изобретать что-то ещё? Но перспектива прожать ~400 × 2 кнопок для двух кластеров и следить за каждым Helm-релизом в GitLab-раннере выглядит не особо человеко-выполнимой. Можно, конечно, переезжать постепенно, но тогда придётся координировать действия команд, ловить разные split-brain ситуации и разбираться с различиями в версиях и конфигах. Опасно, сложно, почти гарантированы аварии.
Velero Operator. Широко используемый инструмент, у которого все действия выполняются через CR, что довольно удобно. Но нам нужно не просто перенести манифесты из одного кластера в другой, а ещё и пропатчить их по дороге. И вот тут возможностей для патча на лету оказалось маловато.
Argo CD. Стильно-модно-молодёжно, GitOps. На бумаге гарантирует соответствие состояния кластеров тому, что лежит в CD-репах. Но чтобы всё это заработало у нас, нужно сначала научиться его готовить, обработать каждый corner case (разные команды по-разному деплоятся) и при этом не нарушить существующий флоу разработки. Звучит сложно и долго. Как будто перепрыгивать на новый подход доставки одновременно с миграцией между кластерами не лучшая идея.
kube-dump. Консольная утилита, по сути набор алиасов кkubectl. Вроде бы подходит для нашей задачи, но есть нюанс: нужны права админа в кластере (которых не было в кластере исхода). А если их нет, придётся писать поверх неё ещё один враппер. Проще уже свой набор алиасов написать. К тому же патча на лету здесь тоже нет, так что этот вариант отпадает.Самописный скрипт. Как вы могли догадаться, мы выбрали именно этот вариант. Уж больно специфичный набор условий сложился в этом переезде. Готовые решения закрывают отдельные задачи, но ни одно из рассмотренных не подходит нам со всеми ограничениями сразу. Так что закатываем рукава, достаём инструменты и идём собирать свой велосипед!
Наши велосипеды самые велосипедистые!
Итак, определимся, что именно мы переносим. Все приклады раскатаны через Helm. Если возьмём только то, что упомянуто в релизах, при переезде избавимся от манифестов которые не нужны. Плюс облегчим фильтрацию по названию приклада.
Решено, переносим только Helm-релизы! И тут есть один интересный момент. Helm создаёт в Kubernetes секрет, в котором описывает, что собирается разворачивать. Наша задумка заключалась в том, чтобы отредактировать этот секрет и положить в новый кластер так, чтобы Helm даже не заметил подмены. Это позволило сохранить стабильный релиз из старого кластера, но уже с настройками нового. Если сразу после переезда кто-нибудь неудачно накатит свежую версию и потребуется helm rollback, всё пройдёт как ни в чём не бывало. Как будто старый релиз изначально был раскатан в новом кластере.
Набросаем алгоритм работы скрипта:
Выгрузить из KubeAPI секреты Helm-релизов.
Выгрузить из KubeAPI live-манифесты.
Если отдельные манифесты правились руками, то пропатчить манифесты релиза live-манифестами.
Подменить все упоминания имени кластера.
Внести в манифесты патчи безопасности.
Собрать заново секрет Helm-релиза, чтобы после переноса всё ещё можно было сделать rollback.
Сохранить файлы манифестов локально.
Вывести в консоль команду на применение в новом кластере и сохранить в отдельный файл, чтобы потом не искать.
Можно заодно автоматизировать остановку и поднятие прикладов в кластерах. Но спринты не бесконечны, а задачи делать ВЕЛИКИЙ КОМБАЙН, КОТОРЫЙ МОЖЕТ ВСЁ, у нас не стоит. Поэтому останавливаемся на полуручном решении.
Теперь посмотрим, что получалось на выходе. Допустим, нам нужно перенести приклады из кластера my-cluster в new-cluster. Для примера возьмём два неймспейса: ns-1 с приложениями app-11 и app-12 и ns-2 с приложениями app-21 и app-22.
По результатам работы скрипта получаем следующую структуру файлов.
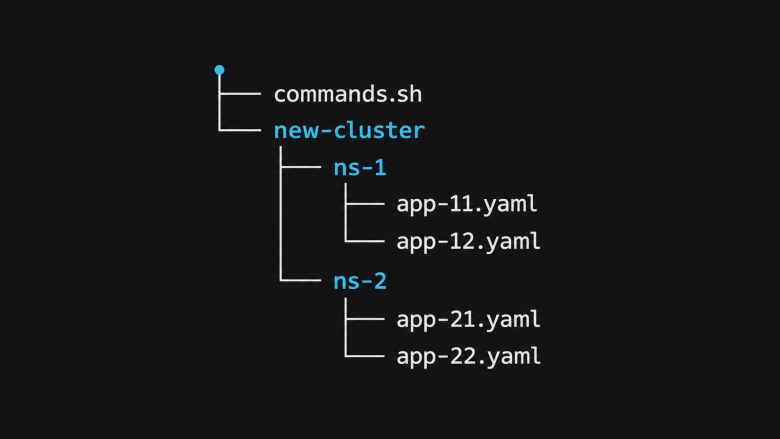
commands.sh — башовый скрипт формата «перейти в контекст кластера new-cluster, применить манифесты из директории ns-1 на неймспейс ns-1, из директории ns-2 на неймспейс ns-2, …»
app-XX.yaml — собранные в один файл манифесты приложения: Deployment, Service, Ingress, ConfigMap и так далее.
На этом этапе у нас на компе уже лежит «слепок» того, что мы хотим видеть в целевом кластере. А дальше возникало два варианта:
Запустить
commands.sh, применить всё разом и ждать результата.Разбить установку на этапы и по итогам каждого из них фиксить, откатывать или продолжать работы.
Делать абы-как не вариант (ядро банка переносим, всё таки!), поэтому идем по второму сценарию.
Он сказал «поехали», он махнул рукой...
Итак, нон-прод окружения мы перенесли, процесс отладили, вроде бы всё готово.
Назначаем работы на 4 часа утра.
За месяц, за неделю, за день до проведения работ извещаем коллег.
Встаём в 3 утра, за 15 минут до начала. Запускаем скрипт, открываем страничку с CRQ, на часах 4:00. Я навожу курсор на кнопку «Начать работы» и глубоко вдыхаю...
В первую очередь переносим сервисы, на которые завязаны остальные системы, эдакие прослойки между ядром и остальным банком. Это как раз наши, платформенные.
По пути следим за подключением к БД и нагрузкой на хосты. Дашборды в Grafana мелькают как стробоскоп-калейдоскоп. Где-то не хватает коннектов, а часть сервисов тушим в старом кластере. Полёт нормальный.
Вот уже перенесены две трети сервисов, и тут в очередном неймспейсе не стартует приклад. А вместе с ним ещё два в бутлупе. В логах таймауты подключения к одной из БД. Начинаем разбираться.
Кластер БД состоит из трех нод (условно db-host-1, db-host-2, db-host-3), а сетевой доступ пробит только до первого хоста.
Благо у этих сервисов все взаимодействия асинхронные и они без проблем могут работать в пустом кластере. Оставляем их в старом кластере, делаем заметку на полях: «Перенести попозже». Лоб покраснел, рука немного болит, но мы едем дальше.
Первый кластер готов, а второй на очереди.
И в самый ответственный момент...
...Всё прошло без сюрпризов: мы докатили оставшиеся приклады, схлопнули что могли в старом кластере, окончательно перенаправили общий пайплайн и синхронный трафик в новые кластеры и довольные ушли спать.
Выводы
Не бойтесь масштабных работ! Если правильно разделить всё на этапы и подготовиться, в том числе заказать все сетевые доступы, то огромная СТРАШНАЯ монструозная задача превратится в тыкву набор тасок в спринте, которые планомерно двигают нас к успешному финалу.
Как показала практика, не обязательно автоматизировать прям всё. Мы сознательно отказались от идеи строить ВЕЛИКИЙ КОМБАЙН, а поручили перенос манифестов одному маленькому, но гордому скрипту, оставив на ручном управлении остановку и запуск прикладов. Так наш велосипед решал именно ту задачу, ради которой его собирали.