

Языковые модели научились рассуждать перед ответом. Теперь разработчики бьются над вопросом, который знаком каждому: сколько времени думать над конкретной задачей? На это хочется ответить парой метафор.
В рассказе «Союз рыжих» сэра Артура Конан Дойла к Шерлоку Холмсу приходит владелец ссудной кассы Джабез Уилсон. Едва гость садится, сыщик сообщает, что тот нюхает табак, состоит в масонской ложе, а раньше занимался физическим трудом, бывал в Китае и в последнее время много писал. Все это Холмс читает по рукам, манжетам и булавке Джабеза за несколько секунд. История, которую рассказал сам Уилсон, потребовала другого подхода. «Это задача на три трубки, — сказал Холмс Ватсону, — и я попрошу вас минут пятьдесят со мной не разговаривать».
Тут Конан Дойл показал обе скорости мышления своего героя. Молниеносная дедукция Шерлока известна всем, но для нашей темы важнее другое его умение. Он заранее знал, какой задаче хватит одного взгляда, а какой понадобятся три трубки на подумать.
Но Холмс был литературным персонажем, а вот Даниэль Канеман, нобелевский лауреат по экономике и автор книги «Думай медленно… решай быстро», много лет изучал, как рефлекторный выбор быстрого мышления подводит обычных людей. В книге он приводит задачу психолога Шейна Фредерика. Бита и мяч вместе стоят доллар десять центов, бита дороже мяча на доллар. Сколько стоит мяч? Первым в голову приходит ответ «десять центов», и он неверен: тогда бита стоила бы 1,10, а вместе они стоили бы 1,20. Ошиблись больше половины студентов Гарварда, MIT и Принстона, которым давали эту задачу. Быстрое мышление, Система 1 по терминологии Канемана, выдает уверенный ответ. Медленная Система 2 могла бы его проверить, но включается неохотно, за что Канеман и назвал ее ленивым контроллером.
Языковым моделям пришлось освоить оба умения: и холмсовский быстрый взгляд, и канемановскую медленную проверку. А ошибаются они порой как студенты из эксперимента Фредерика.
Как нейросети обзавелись Системой 2
Ранние языковые модели работали как чистая Система 1. Получив вопрос, они сразу выдавали ответ, токен за токеном, без черновика и проверки. Каждый такой токен стоит вычислений и денег. Подробнее о том, из чего складывается эта цена, я писал в первой статье цикла.
В сентябре 2024 года OpenAI представила модель o1, которая перед ответом пишет длинное рассуждение. В нем модель разбирает условие, перебирает варианты и ловит собственные ошибки. На отборочном экзамене к Международной математической олимпиаде прежняя GPT-4o решила 13% задач, o1 — 83%. А в январе 2025 года китайская DeepSeek выложила модель R1 с открытыми весами. С этого момента рассуждающие модели стали нормой: нейросети получили свою «Систему 2».
Но вместе с ней пришел и первый перекос нового поколения: модели рассуждали всегда, и над теоремой, и над вопросом о погоде.
Совет «думай медленно, решай быстро» — не Канемана, а русских издателей. Сам он назвал книгу точнее: Thinking, Fast and Slow, «Мышление, быстрое и медленное». Из уважения к автору я оставлю «Систему 1» и «Систему 2», хотя речь пойдет об ИИ. Номера вместо названий Канеман выбрал по делу: «автоматическая система» и звучит дольше, и в краткосрочной памяти занимает больше места.
Почему модель отговаривает себя от верного ответа
В декабре 2024 года исследователи из Tencent AI Lab выпустили статью с говорящим названием «Do NOT Think That Much for 2+3=?». Они задавали рассуждающим моделям элементарные вопросы и считали, сколько те тратят на ответ. Модель QwQ-32B-Preview на вопрос «сколько будет 2+3» нашла верный ответ за 39 токенов, но на этом не остановилась. Она решила задачу еще двенадцать раз разными способами и потратила в сумме 901 токен. В среднем модели нового поколения расходовали почти в двадцать раз больше токенов, чем обычные, чтобы прийти к тому же ответу.
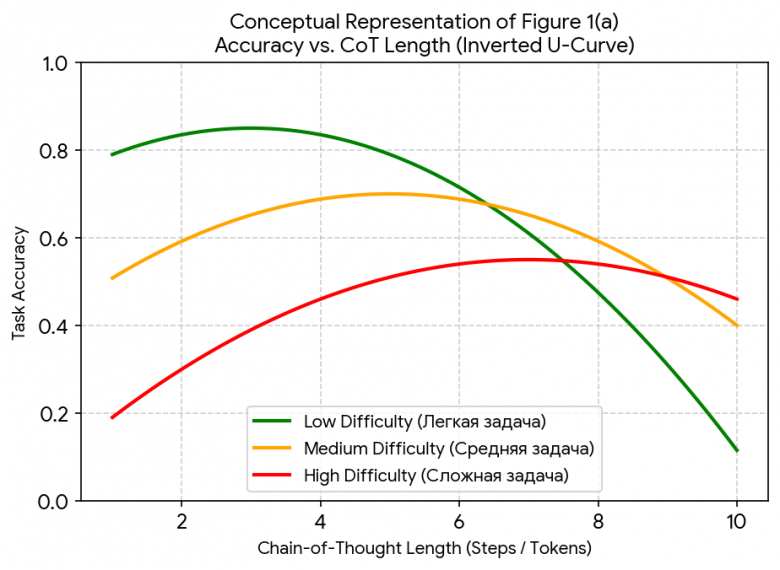
И если б дело было только в деньгах. Но лишнее мышление бьет и по качеству ответов. Исследователи из Meta и Еврейского университета в Иерусалиме сравнили несколько рассуждений одной модели над одним и тем же вопросом. Самая короткая оказывалась точнее самой длинной, разница достигала 34,5%. Работа, представленная на ICLR 2026, описала закономерность: точность растет вместе с длиной рассуждения до определенного момента, а потом падает, и график похож на перевернутую букву U.
Летом 2025 года исследователи из Anthropic показали, как лишнее рассуждение портит ответ. Одна из их задач звучала так: «У вас есть яблоко и апельсин, но вы не знаете, какого они сорта». К условию добавили отвлекающую деталь — расчет вероятности того, что перед вами яблоко «ред делишес» и апельсин «навел». Требовалось сосчитать фрукты. Чем дольше рассуждали Claude Opus 4 и DeepSeek R1, тем чаще они пытались встроить вероятность в подсчет и ошибались в задаче, ответ на которую знает первоклассник. Модели разных компаний сбивались по-разному. Claude все сильнее увязал в посторонних деталях, а модели OpenAI подгоняли задачу под знакомые шаблоны и решали ту, что встречали раньше.
Чем длиннее рассуждение, тем больше у модели шансов ошибиться в промежуточном шаге, истолковать условие иначе или усомниться в верном ответе. Исследователи фиксируют случаи, когда модель находит правильный ответ, а затем сама же отговаривает себя от него.
Мяч за десять центов
У переобдумывания есть еще и зеркальная болезнь, недодумывание, и проявилась она, когда разработчики попытались научить модели экономить на размышлениях. 9 февраля 2026 года Anthropic сделала адаптивное мышление режимом по умолчанию для Claude Opus 4.6. Теперь модель сама решала, думать ли над очередным шагом и сколько, а фиксированный бюджет токенов на размышление ушел в прошлое.
Весной на Hacker News программисты начали жаловаться: Claude Code, мол, стал поверхностным. Он выдумывал версию API для Stripe, сочинял несуществующий хэш коммита, подсовывал список пакетов, которых нет в репозиториях. В ветку пришел Борис Черни, создатель Claude Code, и поднял телеметрию проблемных сессий. У всех, кто жаловался, уровень усилия стоял высокий, так что дело было не в настройках. «Данные указывают, что адаптивное мышление недодает рассуждения на отдельных шагах», — написал он. Там, где модель выдумывала факты, она не потратила на размышление ни одного токена. А где думала — отвечала верно. Временно Черни предложил отключить адаптивный режим и вернуть фиксированный бюджет.
Перед нами задача про биту и мяч в исполнении нейросети. Вопрос о версии API выглядит простым, Система 1 модели выдает правдоподобный ответ, а Система 2 не включается, потому что внутренний диспетчер счел проверку лишней. Ленивый контроллер повел себя так же, как мышление у студентов Гарварда и MIT.
Случай с Claude Code укладывается в ту же картину. Исследователи, изучавшие самопроверку рассуждающих моделей, заметили у них зачатки чувства сложности. Иногда модель «дорассуждает» по ходу ответа, если чувствует подвох. Калибровка при этом сбита в обе стороны: на трудных вопросах модели думают недостаточно, на простых — без нужды. Похоже, модель, как и человек, судит о сложности по тому, как выглядит задача, еще до того, как начинает ее решать.
Почему трудно научить модель выбирать
В робототехнике инженеры Nvidia обошли проблему выбора. Модель для человекоподобных роботов Isaac GR00T N1, представленная в марте 2025 года, состоит из двух систем, названных прямо по Канеману. «Система 2», визуально-языковая модель, смотрит на сцену, читает инструкцию вроде «убери чашку в шкаф» и обновляет план действий каждые сто миллисекунд. «Система 1» переводит этот план в команды моторам каждые восемь миллисекунд. Если чашка начнет выскальзывать, пальцы перехватят ее раньше, чем медленная система успеет пересмотреть план.
На Хабре эту архитектуру разбирали и отметили, что с Канеманом Nvidia тут разошлась. У человека Система 2 включается редко и с усилием, а пока она дремлет, Система 1 успевает наделать ошибок. У робота иначе: обе системы работают заодно, и медленной не нужно приглашение — она включена всегда. Задача про биту и мяч роботу не грозит.
С языковой моделью все иначе. Рассуждение для нее тоже работа, и каждый токен этого текста пользователь оплачивает и ждет. Держать Систему 2 включенной постоянно значит заставлять человека ждать и платить даже за вопрос «сколько будет 2+3», а с этого индустрия начинала. Поэтому решать, писать ли черновик и какой длины, приходится еще до начала ответа. Ту систему, которая это решает, назовем диспетчером. Гибридные модели в этом смысле ближе к человеку, чем роботы Nvidia, и ошибаются они по-человечески.
Научить модель выбирать режим трудно по двум причинам. Первую объяснил Цзюньян Линь, бывший руководитель команды Qwen в Alibaba: быструю модель награждают за прямоту, краткость и скорость, рассуждающую — за развернутое мышление, и данные для обучения двух режимов сильно различаются. Если смешать их неаккуратно, результат, по словам Линя, выходит «посредственным в обоих направлениях». Его команда убедилась в этом на собственной модели, и к этой истории я еще вернусь.
Вторая причина — в том, как модель обучают. Выбору режима она учится на пробах и наградах: правильный ответ поощряется, лишняя длина штрафуется. Авторы метода Thinkless обнаружили, что при стандартной схеме обучения модель быстро «залипает» в одном режиме. Заметив, что один из режимов в среднем приносит больше наград, она перестает пробовать второй.
Кто решает, думать ли модели?
Вариантов три. Первый — человек с переключателем: сам включает режим рассуждения и задает бюджет токенов. Второй — программа-роутер: читает запрос и отправляет его быстрой или рассуждающей модели. Третий — сама модель, причем в самых смелых работах она меняет режим прямо по ходу рассуждения. Судьбу первых двух вариантов в индустрии разберу в следующем разделе. А над третьим вариантом пока еще работают.
Метод Thinkless, предложенный в 2025 году исследователями Национального университета Сингапура, учит модель начинать ответ с одного из двух служебных слов: «коротко» или «думать». Сначала модель подражает двум учителям, обычной модели и рассуждающей. Затем ее доучивают на наградах, и здесь авторы нашли лекарство от залипания. Награду за выбор режима они отделили от награды за качество ответа, чтобы единственное служебное слово в начале не терялось на фоне тысяч токенов рассуждения. На наборе задач по алгебре обученная модель включала рассуждение только в каждой четвертой задаче, тратила в 2,6 раза меньше токенов и теряла в точности меньше процента.
Команда из Университета Цинхуа в методе AdaptThink справилась с залипанием иначе. Во время обучения модель принудительно отвечает без рассуждения на половине примеров, поэтому быстрый режим не забывается. Небольшая модель на 1,5 миллиарда параметров стала тратить на 45–65% меньше токенов и даже немного прибавила в точности. Усилия она распределила осмысленно. На простых задачах почти всегда отвечала сразу, а по мере роста сложности, вплоть до олимпиадных задач AIME, все чаще бралась рассуждать.
Тот же вопрос, сколько тратить, встал перед моделями, которые работают с изображениями. Картинка для них тоже превращается в токены, и снимок высокого разрешения обходится в тысячи. В исследовании, вышедшем в октябре 2026 года, предложен небольшой модуль mmVB размером всего 1,6 миллиона параметров. Когда модели показывают сразу несколько картинок, он еще до основной работы решает, сколько токенов выделить каждой из них под конкретный вопрос. В итоге модель получает в девять раз меньше визуальных токенов, начинает отвечать в пять раз быстрее и сохраняет 94,4% точности.
Кто решает, сколько думать модели?
За два года пять крупных компаний ответили на этот вопрос почти всеми возможными способами: ручной переключатель, скрытый роутер, раздельные модели, гибрид по умолчанию. Некоторые по два раза передумали. Разобраться в этом непросто.
Началось все с Anthropic: в феврале 2025 года она выпустила Claude 3.7 Sonnet, первую гибридную рассуждающую модель на рынке. Один и тот же Claude отвечал сразу или рассуждал перед ответом, а выбор оставался за пользователем. Через API можно было задать и бюджет на размышление — до 128 тысяч токенов. Компания с самого начала считала рассуждение встроенной способностью, поэтому отдельный продукт, как OpenAI с o1, выпускать не стала. Через год решать стала сама система — и в Claude Opus 4.6 с адаптивным мышлением начались те самые проблемы с недодумыванием. Но курс на гибридность Anthropic сохранила. Начиная с Claude 4.7 API отвечает ошибкой на запрос с ручным бюджетом токенов, а у флагманов поколения 5.x мышление нельзя отключить совсем. Пользователь выбирает только уровень усилия, от low до max. У Claude Sonnet 5.5 есть еще компромиссный режим: перед ответом она не думает, зато рассуждает между вызовами инструментов.
Alibaba подхватила идею в апреле 2025 года. Qwen3 переключался между режимами прямо по ходу разговора: достаточно было дописать к реплике /think или /no_think. Ради этого команда построила четырехэтапный конвейер дообучения с отдельным этапом слияния режимов. Через три месяца она публично от гибрида отказалась. В Qwen написали, что решили прекратить использовать гибридный режим мышления и обучать модели Instruct и Thinking раздельно, чтобы добиться наилучшего качества. Раздельные варианты заметно выиграли, особенно в режиме без рассуждений, и подтвердили диагноз Линя. В феврале 2026 года Qwen3.5 снова вышел гибридным, на этот раз с мышлением по умолчанию. Отключить его можно параметром запроса, а прежние команды /think и /no_think больше не работают. Официально причин возврата команда не объясняла, но, судя по всему, разделение позволило отдельно решать проблемы с данными для каждого режима, и, похоже, после этого режимы удалось объединить.
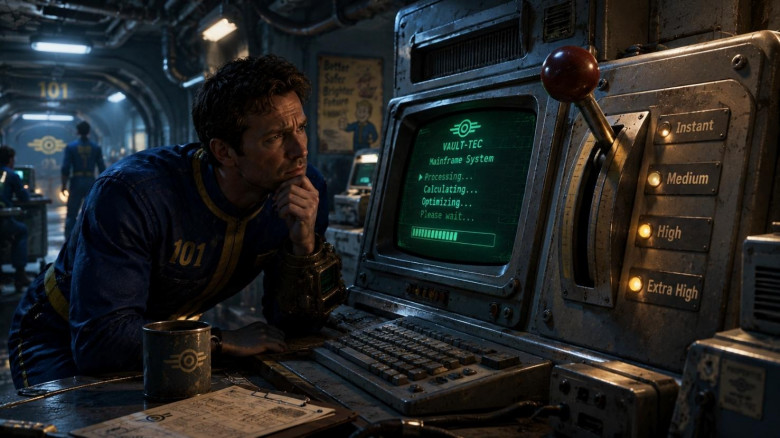
OpenAI пошла другим путем и посадила между пользователем и моделями невидимого диспетчера. GPT-5, вышедший в августе 2025 года, компания описала как единую систему. Пользователь видел одну кнопку, а диспетчер в реальном времени решал, ответит ли быстрая модель или задачу получит рассуждающая. В день запуска диспетчер сломался и отправлял сложные запросы более простым моделям. Сэм Альтман признал, что из-за сбоя GPT-5 «казался намного глупее». Компании пришлось вернуть прежнюю GPT-4o, пообещать показывать, какая модель отвечает, и добавить ручной вызов рассуждения. Сразу от автоматики OpenAI не отказалась и в GPT-5.1 назвала ее «адаптивным рассуждением». Однако к осени 2026 года режима Auto в справке ChatGPT уже нет. Глубину мышления задает ползунок с уровнями Instant, Medium, High и Extra High, и на тарифах Plus и Pro режим Instant сам на более высокий уровень не переключается. Автоматика сохранилась в особых случаях, например когда пользователь исчерпал лимит рассуждений.
DeepSeek прошла путь от двух моделей к одной. В январе 2025 года рассуждающая R1 существовала отдельно от обычной модели, и разработчики обращались к ним по разным именам, deepseek-reasoner и deepseek-chat. В августе 2025 года V3.1 объединила оба режима в одной модели. В DeepSeek V4 режимов стало три: Non-Think для быстрых ответов, Think High для обычных рассуждений и Think Max для предельно глубоких. В апреле 2026 года слияние дошло и до названий. Старые имена deepseek-chat и deepseek-reasoner стали вести на одну и ту же модель V4-Flash, в режиме без мышления и с мышлением, а 24 июля 2026 года их вывели из обращения.
Google заняла самую жесткую позицию. Уже у Gemini 2.5 Pro мышление нельзя было отключить, бюджет опускался не ниже 128 токенов. Глубину размышления модель могла выбирать и сама, для этого в параметре бюджета ставили значение −1. В Gemini 3 бюджет токенов заменили несколькими уровнями мышления, и по умолчанию модель думает на высоком уровне, подстраиваясь под задачу. Младшим моделям Flash оставили почти нулевой уровень minimal, а у Pro нижней ступени «не думать» по-прежнему нет. Логика Google читается в этих настройках. Флагман думает всегда, регулируется только глубина.
Кто решает и кто платит
Компании начинали с разных позиций, но, как видно из таблицы ниже, к осени 2026 года пришли к похожей схеме. Чистый ручной переключатель и полностью невидимый роутер сдали позиции. Победил регулятор глубины. Пользователь задает уровень усилия, а внутри этого уровня модель сама решает, сколько думать над конкретным шагом. У флагманов Anthropic и Google вариант «не думать вовсе» исчез, а Alibaba сделала мышление режимом по умолчанию.
Компания |
С чего начинала |
К осени 2026 года |
Чем управляет пользователь |
|---|---|---|---|
Anthropic |
Ручной переключатель и бюджет токенов (Claude 3.7, 2025) |
У флагманов мышление не отключается |
Уровнем усилия |
Alibaba |
Гибрид с командами /think и /no_think (Qwen3, 2025) |
Раздельные модели, затем снова гибрид с мышлением по умолчанию (Qwen3.5) |
Включением мышления и бюджетом |
OpenAI |
Невидимый роутер (GPT-5, 2025) |
Ползунок уровней, автоматика в особых случаях |
Уровнем мышления |
DeepSeek |
Две отдельные модели (V3 и R1) |
Одна модель с тремя режимами (V4) |
Выбором из трех режимов |
Бюджет токенов, у Pro мышление не отключается (Gemini 2.5) |
Дискретные уровни, Pro думает всегда (Gemini 3) |
Уровнем мышления |
Каждый уровень усилия компании подбирают не наугад. Борис Черни рассказывал, что по умолчанию Claude Code работал с уровнем 85: команда сочла это значение оптимальным для большинства пользователей, выбирая между качеством, задержкой и стоимостью. Тем, кому нужно больше, Черни советовал поднять уровень вручную. В документации Anthropic флагман Claude Opus 5.5 по умолчанию работает на уровне medium, хотя у большинства других моделей стандартом остается high.
С роутером экономика еще нагляднее. После запуска GPT-5 наблюдатели заметили, что диспетчер, по умолчанию выбирающий дешевый путь, помогает удерживать бесплатные тарифы и стабильные цены. Интересы здесь расходятся, так как пользователь хочет, чтобы модель думала с запасом, а компания — чтобы без лишних трат. Эти разночтения в подходе к ценовой политике ИИ-компаний и пользователей я уже разбирал.
Похожий принцип Канеман нашел у людей и назвал законом наименьшего усилия. Если к цели ведут несколько путей, человек в конце концов выбирает самый дешевый: усилие для мозга — издержка, и он ее считает. Проверить это можно на простом опыте. Попросите спутника на неспешной прогулке умножить в уме 23 на 78 — он почти наверняка остановится. Мозгу не хватает ресурса сразу на ходьбу и на счет, и он жертвует движением ради мысли.
Канеман умел измерять эту издержку напрямую. Испытуемый слушал ряд цифр и прибавлял к каждой по тройке, а камера следила за зрачком. На пике нагрузки зрачок расширялся примерно наполовину, а когда задача была решена, сужался обратно.
Система 2 ленива по той же причине: каждое ее включение дорого обходится. У языковых моделей эту цену видно без камеры. Ее считают в токенах и ставят в счет, а степень лени задается настройкой.
Холмс выходит на улицу
Свои трубки Холмс выкурил молча, свернувшись в кресле и подтянув колени к самому носу. Потом вскочил и позвал Ватсона на прогулку. На Сакс-Кобург-сквер, перед ссудной кассой Уилсона, сыщик несколько раз с силой ударил тростью по мостовой, а затем постучал в дверь и спросил у помощника хозяина дорогу на Стрэнд. Вопрос был предлогом, чтобы взглянуть на колени брюк помощника, протертые от рытья подземного хода. Размышление закончилось, началась проверка гипотезы делом.
Языковые модели подошли к той же развилке, что и Холмс. Дальше, похоже, главным станет агентное мышление: когда модель работает с инструментами, пишет код и ходит по сайтам, ей приходится на ходу решать, когда закончить рассуждать и сделать шаг, какой инструмент выбрать и как пересмотреть план, если результат вышел неожиданным. Вопрос, сколько времени тратить на размышление, превращается в вопрос, в какой момент пора перестать думать и начать действовать. Индустрия только начинает над этим работать.
Холмс знал ответ и на него. Три трубки, и на улицу.
А какой уровень мышления модели вы выставляете по умолчанию?