

Под капотом Spring WebFlux: Event Loop, block() и почему ThreadLocal вас подведет
Привет, Хабр! Снова Вадим Белый, Middle Java-разработчик в компании «Синимекс». Часть моей работы — помогать джунам разбираться с архитектурными решениями.
Это вторая статья нашего цикла про реактивную Java. Напомню, с чего все началось.
В первой статье я рассказывал о Spring MVC, на котором построено большинство корпоративных приложений. Spring MVC использует модель «один поток на запрос»: каждый HTTP-запрос занимает отдельный поток, и этот поток остается занятым все время обработки, включая ожидание ответа от базы данных или внешних API. При небольшой нагрузке это работает отлично, но когда запросов становится много, потоки начинают простаивать в ожидании I/O (ввода-вывода), потребляя память и ресурсы сервера.
Именно поэтому в последние годы набрал популярность Spring WebFlux — модуль Spring для реактивного программирования, который использует неблокирующий ввод-вывод: поток не ждет ответа, а освобождается для обработки других запросов, и возвращается к задаче только когда данные готовы. Теоретически это позволяет обслуживать тысячи одновременных соединений небольшим числом потоков.
Так вот. У нас в «Синимекс» периодически вспыхивал внутренний холивар: кто-то из команды регулярно приходил с идеей «давайте переведем все на WebFlux, это же современно», а кто-то не менее регулярно отвечал «зачем, MVC справляется». Спор ходил по кругу, пока мы не решили заменить ощущения цифрами: провели внутренний бенчмарк, собрали результаты в методичку, а заодно складывали в копилку ловушки, в которые попадали джуны (и не только) при переезде на реактивщину.
Потом мы посмотрели на этот материал и поняли, что он способен сэкономить время не только нам. Так появилась идея о цикле статей.
Цель у него простая: провести разработчика за руку по всему пути работы с реактивной Java. В первой статье мы разбирались, нужен ли вам WebFlux и чем он отличается от виртуальных потоков и MVC. В этой — постараемся понять, как не сломать то, что мы выбрали.
Итак, допустим, по чек-листу в первой статье для вашего проекта WebFlux оправдан. Но как написать реактивный код так, чтобы он работал так, как обещает документация, а не так, как получается в инцидентах?
Я покажу, что у WebFlux под капотом, и разберу четыре фактора, которые чаще всего превращают реактивное приложение в блокирующий кошмар:
block()внутри пайплайна,молча теряющийся
ThreadLocal,контекст, который нужно правильно пробросить, и
легаси-код, который нельзя просто выбросить.
И прежде чем начать, повторю тот же дисклеймер: сеньорам нового тут будет мало — текст для тех, кто делает первые шаги в реактивном стеке.
Что происходит внутри, когда приходит запрос
Помните рисунок из первой части, на котором человечек жонглирует шариками «HTTP»? Это не просто метафора, а конкретный механизм под названием event loop — сердце всей реактивной модели. Давайте посмотрим на него вблизи, чтобы все происходящее не казалось абстракцией.
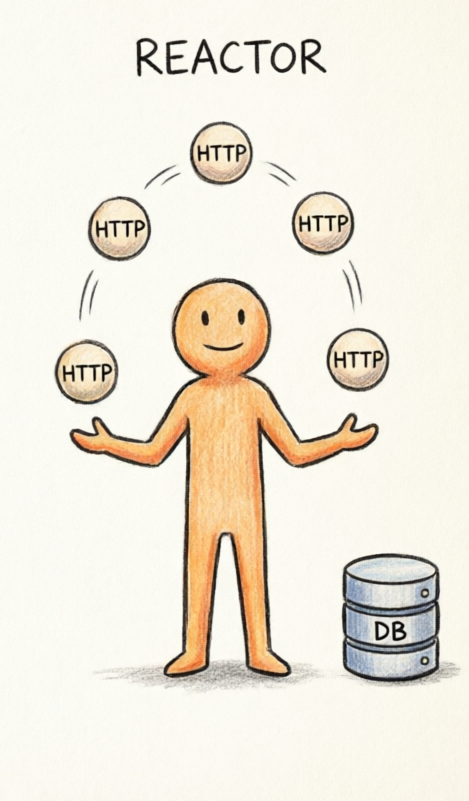
Spring WebFlux по умолчанию использует сервер Reactor Netty. При старте он создает небольшое число потоков event loop — обычно по числу ядер CPU. Вспомните стенд нашего бенчмарка из первой статьи: Intel Core i5-7500, 4 ядра. Значит, на той машине Reactor Netty поднимал 4 потока event loop. И эти 4 потока обслуживали все входящие запросы. Все без исключений.
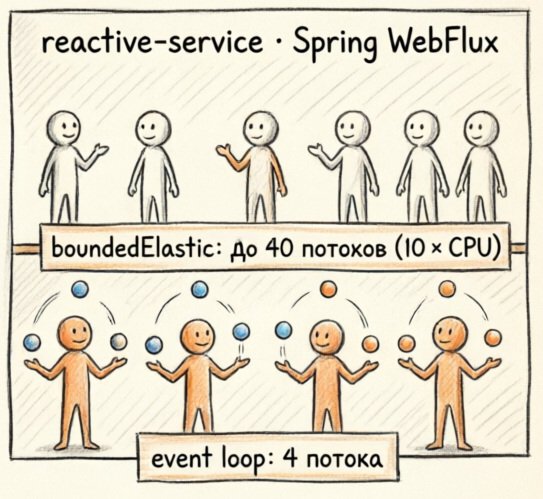
Устроен каждый такой поток просто: это бесконечный цикл, который каждую итерацию проверяет очередь задач. Пришел запрос — поток взял его и начал выполнять пайплайн. Дошел пайплайн до ввода-вывода — скажем, до запроса в базу через R2DBC (Reactive Relational Database Connectivity — реактивного аналога JDBC для работы с реляционными БД), и начинает происходить то, что отличает реактивную модель от всего, к чему вы привыкли в Spring MVC.
В частности, поток не ждет ответа: он сохраняет в памяти ссылку на следующий шаг пайплайна («когда придут данные — продолжить отсюда»), отдает запрос сети и возвращается в очередь за новыми задачами. А когда приходит ответ, любой свободный поток event loop достает из памяти эту ссылку и продолжает выполнение — причем не обязательно тот же самый, что начинал обработку.
Это означает, что «поток освобождается сразу после отправки асинхронной операции», как я и писал в первой статье. Никакой магии тут нет — просто конкретная ссылка на следующий шаг пайплайна, сохраненная в памяти.
Здесь же живет еще один механизм — backpressure, который в первой статье я указывал, как один из критериев выбора WebFlux. В первой статье я уже упоминал, что в Reactive Streams темп диктует подписчик — через объект Subscription он сообщает, сколько элементов готов принять прямо сейчас, и издатель не отправляет следующие элементы. Благодаря этому быстрый производитель не «затапливает» медленного потребителя, и вся система ведет себя предсказуемо даже под пиковой нагрузкой.
Из этого можно сделать вывод, что поток event loop — ресурс дефицитный: их у нас на тестовой машине было 4 на все запросы. И если такой поток застрянет, встанет не один ваш запрос, а вообще все запросы, назначенные на этот поток — и соседи по железу вас не поблагодарят. Именно поэтому все четыре проблемы, о которых я расскажу дальше, так или иначе сводятся к одному: не дать event loop'у застрять.
Главный грех: block() внутри пайплайна
Первая ловушка — самая коварная для новичка, потому что выглядит как спасение: джун пишет реактивный контроллер, и в середине цепочки ему вдруг нужно «просто получить значение и идти дальше» — например, вытащить пользователя, а потом по нему уже сходить за заказами. В этом случае можно использовать волшебные методы Mono.block(), Flux.blockFirst(), Flux.blockLast(): они принудительно блокируют текущий поток, пока из Publisher не придет результат. На первый взгляд решение удобное — писал же так в Spring MVC годами, и ничего.
Выглядит все действительно безобидно, но на деле это самая настоящая дыра в трюме. Давайте посмотрим на типовой пример, чтобы стало совсем ясно:
Листинг 1. Антипаттерн: block() внутри реактивного пайплайна
@GetMapping("/users/{id}/orders")
public Mono<OrderSummary> getUserOrders(@PathVariable Long id) {
    // Блокируем event loop, пока БД возвращает пользователя
    User user = userRepository.findById(id).block();

    // Вторая блокировка на том же потоке
    List<Order> orders = orderRepository.findByUserId(id)
        .collectList().block();

    return Mono.just(new OrderSummary(user, orders));
}
Давайте разберем, что здесь происходит на уровне потоков: поток event loop принял запрос, дошел до первого block() — и встал, ожидая БД. Потом кое-как отмер и тут же уперся во второй block(). И всё это время запросы, назначенные на этот поток, тихо стояли в очереди. На нашей тестовой машине с 4 потоками event loop достаточно 4 одновременных «медленных» запросов, чтобы сервер в принципе перестал отвечать — и это и есть тот самый блокирующий кошмар.
Напомню просты правила обращения с block() в реактивном коде, которые стоит вызубрить:
- запрещено: block() внутри операторов (map, flatMap, filter), в контроллерах WebFlux и в сервисах, возвращающих Mono/Flux;
- допустимо с осторожностью: в main() демонстрационного приложения и в утилитах вне реактивного контекста;
- в тестах: StepVerifier (утилита из пакета reactor-test для проверки реактивных цепочек в тестах) вместо block(), потому что block() еще и прячет проблемы с таймингами, и зависший тест становится сложно диагностировать.
Теперь, когда мы знаем, чего делать нельзя, самое время посмотреть, как жить правильно без block(). И тут у нас есть три рабочих сценария в зависимости от того, что именно вам нужно.
Листинг 2. Вместо block() — продолжаем цепочку операторов
@GetMapping("/users/{id}/orders")
public Mono<OrderSummary> getUserOrders(@PathVariable Long id) {
    return userRepository.findById(id)
        .flatMap(user -> orderRepository.findByUserId(id)
            .collectList()
            .map(orders -> new OrderSummary(user, orders)));
}
Листинг 3. В тестах — StepVerifier
@Test
void shouldReturnUserOrders() {
    StepVerifier.create(userService.getUserOrders(1L))
        .assertNext(summary -> assertEquals(3, summary.getOrders().size()))
        .verifyComplete();
}
Листинг 4. Если нужен мост в синхронный мир — Mono.toFuture()
public CompletableFuture<User> getUserAsync(Long id) {
    return userRepository.findById(id).toFuture();
}
Ловушка ThreadLocal: куда делся ваш traceId
Вторая ловушка скрытая — в нее попадают те, кто, казалось бы, все сделал правильно. Речь про ThreadLocal — стандартный в джавовом мире способ держать данные «в контексте текущего потока»: MDC (Mapped Diagnostic Context) с механизмом Slf4j для привязки контекста (например, traceId) к логам, Spring Security с текущим пользователем, Hibernate с сессией, да мало ли что еще придумали за двадцать лет существования платформы. В Spring MVC все предсказуемо: один запрос — один поток — одно значение на все время обработки.
Reactor эту модель ломает, и делает это довольно подло. Напомню, что после ответа БД выполнение может продолжиться в другом потоке, а ThreadLocal, как недвусмысленно следует из названия, привязан к потоку, а не к запросу. Посмотрим на классический пример, который часто встречается в прод-багах:
Листинг 5. ThreadLocal теряет значение при переключении потока
ThreadLocal<String> currentUser = new ThreadLocal<>();
currentUser.set("user-123");

Mono.fromCallable(() -> currentUser.get())          // "user-123" — ещё тот же поток
    .subscribeOn(Schedulers.boundedElastic())       // ← переключение потока
    .map(val -> currentUser.get())                  // null — уже другой поток
    .subscribe(System.out::println);
Первый get() возвращает user-123: мы все еще в том же потоке, где положили значение.
Но после subscribeOn выполнение уезжает в поток пула, где наш ThreadLocal пуст, — и map получает null. Никаких исключений, никаких ошибок в логах: данные просто молча исчезают. И в проде это выглядит именно так: traceId пропадает из логов на середине цепочки, SecurityContextHolder.getContext().getAuthentication() возвращает null в сервисе, а какая-нибудь старая библиотека, читающая ThreadLocal напрямую, видит пустоту и ведет себя непредсказуемо.
И тут важный нюанс, который ловит даже тех, кто думал, что он в домике: даже если вы нигде явно не писали subscribeOn или publishOn, это отнюдь не гарантирует выполнение в одном потоке. Дело в том, что переключения делают сами реактивные библиотеки: например, большинство драйверов R2DBC после получения ответа от базы сами переводят выполнение цепочки в новый поток. Так что стратегия «просто не переключать потоки вручную» — не выход, ловушка все равно захлопнется.
Хорошая новость в том, что у Project Reactor есть ответ на эту проблему.
Решение: Reactor Context и context-propagation
Чтобы не зависеть от капризов планировщика, у Project Reactor есть собственный механизм передачи данных сквозь цепочку — Context. Он иммутабелен и привязан не к потоку, а к подписке, и поэтому спокойно переживает любые переключения планировщиков, сколько бы их ни было в цепочке.
Листинг 6. Reactor Context: данные путешествуют с подпиской, а не с потоком
Mono.deferContextual(ctx -> {
        String userId = ctx.get("userId");
        return Mono.fromCallable(() -> userRepository.findById(userId));
    })
    .subscribeOn(Schedulers.boundedElastic())
    .map(user -> transform(user))
    .contextWrite(Context.of("userId", "user-123"));
Хочу отметить одну неочевидную вещь: contextWrite вызывается в конце цепочки, но при этом данные доступны всему upstream. Это не опечатка и не баг, а особенность реактивной модели: подписка распространяется снизу вверх, поэтому контекст оказывается «установлен» раньше, чем данные начинают течь сверху вниз. К этому просто надо привыкнуть — после пары своих пайплайнов уже не замечаешь.
Context отлично решает задачу для вашего собственного кода, однако есть одно “но”: MDC и Spring Security читают ThreadLocal напрямую и про Reactor ничего не знают, поэтому просто так их на Context не пересадить. Для таких случаев команда разработчиков из Micrometer сделали библиотеку context-propagation: она регистрирует адаптеры, которые сами переносят значения ThreadLocal в Reactor Context и восстанавливают их при каждом переключении потока.
implementation 'io.micrometer:context-propagation:1.1.1'
Листинг 7. Регистрация адаптера и включение автоматического проброса
// Один раз при старте приложения
ContextRegistry.getInstance()
    .registerThreadLocalAccessor(
        "myKey",
        myThreadLocal::get,     // сохранить из ThreadLocal в Context
        myThreadLocal::set,     // восстановить из Context в ThreadLocal
        myThreadLocal::remove   // почистить ThreadLocal после выполнения
    );

// Включаем автоматический проброс в Reactor
Hooks.enableAutomaticContextPropagation();
На практике все еще проще. Начиная со Spring Boot 3.2, Spring Security и Spring Boot Actuator подключают свои адаптеры автоматически — лишь бы context-propagation была в classpath. Поэтому для стандартных случаев вам не придется писать даже этот код.
Итог после всех этих настроек приятный: traceId доживает до конца цепочки, контекст безопасности доступен в любом операторе, а вам не нужно постоянно думать, в каком потоке прямо сейчас идет выполнение. Но, как водится, не все в нашем коде бывает новым и реактивным — и тут мы подходим к четвертой ловушке.
Изоляция легаси: fromCallable и boundedElastic
Последняя ловушка из нашего списка уже не про ошибку в коде, а про суровую организационную реальность. Даже в совершенно новом реактивном сервисе обязательно найдется что-то блокирующее — JDBC-драйвер какой-нибудь старой базы, сторонний SDK, который писали еще при царе Горохе, файловый ввод-вывод или библиотека от вендора, который про реактивщину даже не слышал. Переписать все на R2DBC получается далеко не всегда, и тут важно понять, как с этим жить, не ломая всю модель из первого раздела.
Я уже писал, что выпускать блокирующий вызов напрямую в event loop нельзя. Для таких случаев у Reactor предусмотрен выделенный пул Schedulers.boundedElastic(): его потоки как раз созданы именно для ожидания. По умолчанию — до 10 потоков на ядро CPU и очередь до 100 000 задач, а на нашей тестовой машине — до 40 потоков, как я упоминал в первой статье.
Механика тут такая: поток event loop регистрирует задачу в boundedElastic и немедленно освобождается; блокирующий вызов выполняется в потоке пула; а результат возвращается в цепочку. Все честно и без сюрпризов.
Но есть один нюанс, на котором регулярно сыпятся даже внимательные разработчики: вызов нужно правильно обернуть, иначе вся магия boundedElastic пойдет насмарку. Давайте сравним два, казалось бы, похожих варианта:
Листинг 8. Неправильно: Mono.just() выполняет блокирующий вызов сразу
public Mono<User> findUserById(Long id) {
    // findById выполнится СРАЗУ, на потоке, который собирает цепочку,
    // — возможно, на потоке event loop
    return Mono.just(userRepository.findById(id))
        .subscribeOn(Schedulers.boundedElastic());
}
Дело в том, что Mono.just() вычисляет значение немедленно, еще до всяких subscribeOn, еще при сборке цепочки, — то есть блокировка происходит на вызывающем потоке, которым вполне может оказаться event loop. Соответственно, subscribeOn тут уже не спасет — вызов уже случился.
Листинг 9. Правильно: Mono.fromCallable() откладывает вызов до подписки
public Mono<User> findUserById(Long id) {
    return Mono.fromCallable(() -> userRepository.findById(id))
        .subscribeOn(Schedulers.boundedElastic());
}
А вот fromCallable откладывает вычисление до момента подписки — а к этому моменту subscribeOn уже успел перенести выполнение в boundedElastic. Как видите, разница в одну строчку, а последствия принципиально разные.
Кроме того, такой подход позволяет распараллелить независимые блокирующие вызовы, что на практике дает ощутимый выигрыш по времени ответа. Судите сами: три последовательных вызова по 100 мс — это 300 мс, а через Mono.zip — около 100 мс.
Листинг 10. Параллельные блокирующие вызовы через Mono.zip
public Mono<UserProfile> buildUserProfile(Long userId) {
    Mono<User> user = Mono.fromCallable(() -> userRepository.findById(userId))
        .subscribeOn(Schedulers.boundedElastic());
    Mono<List<Order>> orders = Mono.fromCallable(() -> orderRepository.findByUserId(userId))
        .subscribeOn(Schedulers.boundedElastic());
    Mono<Settings> settings = Mono.fromCallable(() -> settingsRepository.findByUserId(userId))
        .subscribeOn(Schedulers.boundedElastic());

    // Все три вызова идут параллельно: общее время ≈ max(t1, t2, t3)
    return Mono.zip(user, orders, settings)
        .map(t -> new UserProfile(t.getT1(), t.getT2(), t.getT3()));
}
А для операций, результат которых в принципе никто не ждет (аудит, уведомления, метрики), есть отдельный паттерн fire-and-forget.
Листинг 11. Fire-and-forget: выполняем и не блокируем цепочку
public void sendAuditEvent(AuditEvent event) {
    Mono.fromRunnable(() -> auditService.send(event))
        .subscribeOn(Schedulers.boundedElastic())
        .doOnError(e -> log.error("Audit failed", e))
        .subscribe();
}
Вместо вывода: четыре правила реактивной гигиены
Event loop не блокируем. Этих потоков у вас по числу ядер CPU, и они обслуживают все запросы сервиса сразу.
block()в контроллерах и пайплайнах — нет. Цепочка операторов; в тестах —StepVerifier; мост в синхронный мир —toFuture().ThreadLocalмолча теряет значения. Свои данные носим в ReactorContext, чужие (MDC, Security) пробрасываем через context-propagation от Micrometer.Легаси изолируем в boundedElastic через
fromCallable, а неjust. Независимые вызовы параллелим черезMono.zip.
На сегодня все. В следующей статье — шпаргалка по операторам: разберем flatMap, concatMap, flatMapSequential и switchMap, чтобы выбирать их не наугад; посмотрим, как zip умеет зависать навечно на молчаливом источнике и как прикрыться timeout; и выясним, почему onErrorContinue внутри flatMap — мина замедленного действия.
Подписывайтесь на блог компании «Синимекс», чтобы не пропустить продолжение. А если уже наступали на block() или ThreadLocal в проде — расскажите в комментариях: ваша история сэкономит кому-то нервы.