

Пересобираю свой Kubernetes-кластер на Proxmox из тех же компонентов, что используются в промышленной среде: Gateway API, реплицируемое хранилище, настоящие IP-адреса для LoadBalancer. И всё это на одном мини-ПК, который потребляет около 10 Вт. Система получилась достаточно экономичной, чтобы её можно было спокойно держать включённой постоянно.
У меня уже давно есть репозиторий с Terraform и Ansible для развёртывания Kubernetes на Proxmox. Всё работало, но последний раз я обновлял его ещё во времена Kubernetes 1.33. Причём под «работало» подразумевался голый кластер на kubeadm с Calico для организации сети Pod и практически ничем больше. Ни хранилища, ни возможности принимать входящий трафик. Всё это потом приходилось настраивать вручную.
В этот раз я решил собрать более полноценную систему. В первую очередь хотелось получить кластер, приближенный к промышленному, на котором можно тестировать разные решения. Ведь кластер мало похож на те, с которыми я обычно работаю, если в нём нет постоянного хранилища, способного пережить отказ узла, нормального уровня входящего трафика и сервисов типа LoadBalancer с настоящими маршрутизируемыми IP-адресами.
В прошлый раз я ещё и ошибся с выбором железа. Старый кластер работал на трёх физических узлах, каждый с 16 ГБ оперативной памяти и медленными SSD. Я исходил из того, что Kubernetes будет требователен к процессору. Но, по крайней мере в масштабах домашней лаборатории, это не так. Гораздо активнее он расходует оперативную память и нагружает дисковую подсистему.
Причём виноват был не только Kubernetes. На каждом из старых физических серверов стоял Proxmox с зеркальным ZFS-массивом, а ARC (кеш ZFS в оперативной памяти) отъедал часть этих 16 ГБ ещё до запуска первой виртуальной машины.
Поэтому теперь я решил пойти от обратного: один компьютер Dell Optiplex 3070 с процессором i5-9500T, который без дела пылился на полке, зато с 64 ГБ оперативной памяти, быстрым NVMe-накопителем Crucial P310 и Proxmox на однодисковом ZFS RAID0.
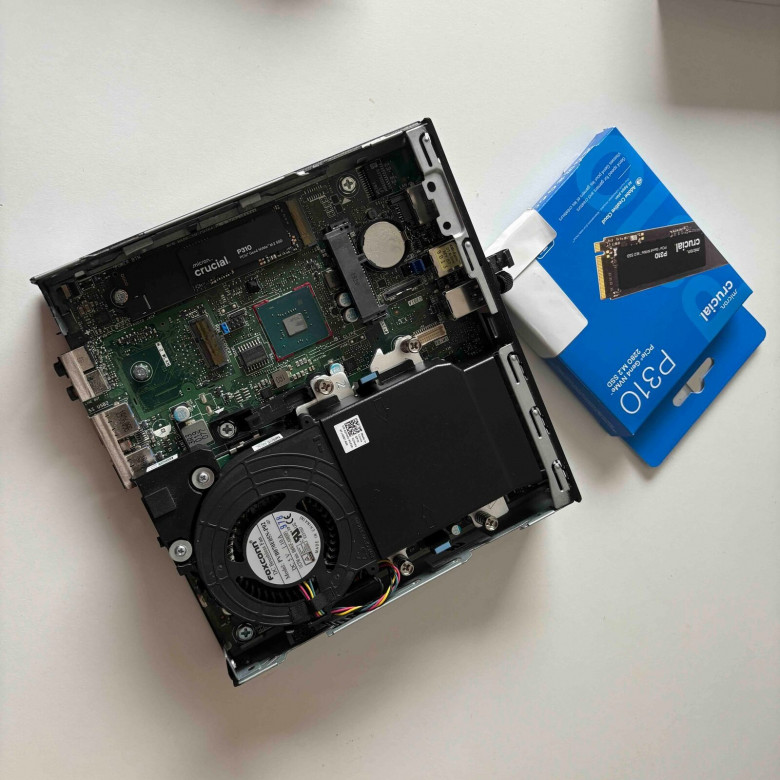
Тут должен оговориться: всё это работает на одном физическом компьютере. Репликация хранилища между двумя виртуальными машинами защищает от сбоев самих ВМ или их операционных систем, но не от выхода из строя мини-ПК. По архитектуре решение похоже на корпоративное, но масштаб последствий сбоя здесь совсем другой.
Меня это устраивает: всё-таки речь о тестовой лаборатории. К тому же каждую ночь диски виртуальных машин Proxmox резервируются на мой NAS. Так что, если мини-ПК выйдет из строя, я восстановлю ВМ из резервных копий, и через несколько минут всё снова заработает.
А насколько уверенно вы сами ориентируетесь в Kubernetes и его инфраструктурной экосистеме? Проверить свои знания можно во вступительном тесте курса «Инфраструктурная платформа на основе Kubernetes».
Стек технологий
Вот какие компоненты я планировал использовать на каждом уровне:
Уровень |
Что планировал использовать |
Гипервизор |
Proxmox VE 9 на Dell Optiplex 3070 (9500T, 64 ГБ DDR4-3200, NVMe Crucial P310 на 1 ТБ) |
Виртуальные машины |
Terraform (telmate/proxmox), клонирование из шаблона Ubuntu 26.04 с cloud-init |
Kubernetes |
kubeadm, v1.36.5 (версия задаётся через переменную Ansible) |
Среда выполнения контейнеров |
containerd 2.3 |
Сеть Pod |
Calico 3.32 |
Хранилище |
Longhorn 1.12 (по умолчанию, с репликацией) + local-path (быстрое локальное хранилище узла) |
LoadBalancer |
MetalLB 0.16 в режиме L2 |
Входящий трафик |
Envoy Gateway 1.9 (Gateway API) |
TLS |
Терминация TLS на Nginx Proxy Manager перед кластером |
Метрики |
metrics-server |
Vault для секретов? |
Менеджера секретов пока нет. Vault есть в планах, но на данном этапе можно обойтись без него. |
С TLS и DNS я немного схитрил: использовал NPM (Nginx Proxy Manager), который уже работает в моей домашней лаборатории и находится полностью за пределами кластера. Если TLS вам не нужен, всё прекрасно работает и без него.
Одна виртуальная машина для плоскости управления и два рабочих узла:
Виртуальная машина |
vCPU |
Оперативная память |
Диск |
kube-server-01 |
2 |
8 ГБ |
64 ГБ |
kube-agent-01 |
2 |
12 ГБ |
128 ГБ |
kube-agent-02 |
2 |
12 ГБ |
128 ГБ |
Виртуальные машины – Terraform
Я переработал конфигурации виртуальных машин, чтобы они больше походили на современные серверы, а не на стандартные ВМ, которые Proxmox создаёт по принципу «лишь бы запустилось» (SeaBIOS, i440fx и всё в таком духе):
Машина: q35
BIOS: OVMF (UEFI) с EFI-диском и диском для хранения состояния TPM 2.0
CPU: host
Диск: virtio-scsi-single с включёнными iothread, discard и эмуляцией SSD, чтобы команды TRIM действительно доходили до ZFS
Динамическое перераспределение памяти (ballooning): отключено. Kubernetes планирует размещение Pod исходя из доступного, по его мнению, объёма памяти. Если balloon-драйвер незаметно забирает часть этой памяти обратно, можно неожиданно получить принудительное завершение процессов из-за нехватки памяти (OOM kill)
Автозапуск: включён, чтобы кластер самостоятельно поднимался после перезагрузки физического хоста
Кроме того, виртуальной машине плоскости управления я назначил вдвое больший вес CPU по сравнению со значением по умолчанию. Если на физическом хосте возникнет конкуренция за процессорные ресурсы, etcd и API-сервер получат приоритет:
cpu {
  cores = var.server_cores
  type  = "host"
  # Удваиваем стандартный вес CPU, чтобы etcd и API-сервер получали приоритет при нехватке процессорных ресурсов хоста
  units = 200
}
Количество рабочих узлов, число ядер, объём оперативной памяти и размеры дисков задаются переменными. IP-адреса рабочих узлов назначаются последовательно, начиная с указанного начального адреса в заданной подсети.
Kubernetes – Ansible
Плейбуки я тоже основательно обновил:
Выбор версии Kubernetes. По умолчанию используется v1.36, но можно указать другую версию через
--extra-vars "k8s_version=v1.37". Командаkubeadm initпросто определяет установленную версию kubeadm, поэтому менять её нужно только в одном месте.Больше никакого
apt-key. В Ubuntu 26.04 этой утилиты уже нет, поэтому старый плейбук сразу падал. Теперь репозитории Docker и Kubernetes используют отдельные файлы ключей (keyring) с параметромsigned-by.Идемпотентная настройка репозиториев. Конфигурация источника пакетов записывается целиком в отдельный файл. Поэтому при смене версии старый репозиторий заменяется новым, а не остаётся рядом с ним.
ansible-playbook -i ./ansible/inventory/hosts --key-file ~/.ssh/my_kube_keys \
  ./ansible/roles/common/tasks/main.yaml
После установки Calico и подключения рабочих узлов я провёл быструю проверку из Pod на одном из них: сначала разрешил DNS-имя сервиса через CoreDNS, работающий в плоскости управления, а затем проверил доступ в интернет.
kubectl run nettest --image=busybox:1.37 --restart=Never --rm -i -- \
  sh -c "nslookup kubernetes.default.svc.cluster.local && wget -qO- -T5 http://example.com"
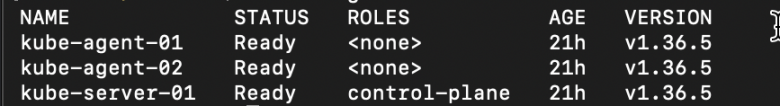
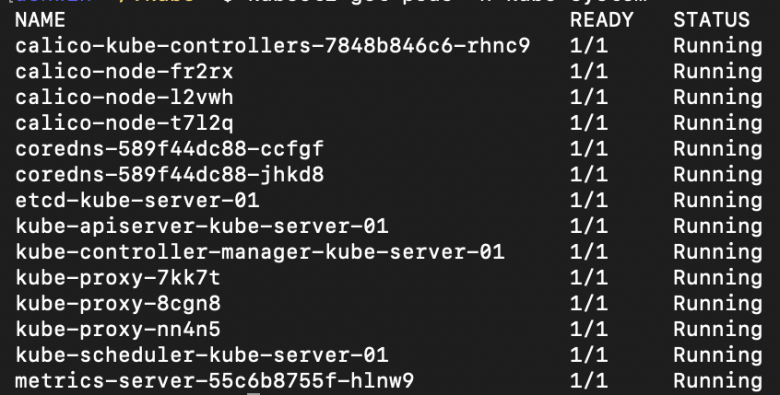
Все три узла в состоянии Ready. Примерно на этом возможности старого репозитория и заканчивались.
Хранилище – Longhorn
Для хранения данных я выбрал Longhorn. Он поддерживает репликацию томов между узлами, снапшоты, резервное копирование в S3 или NFS, расширение томов и веб-интерфейс. При этом ему не требуется ничего особенного от гипервизора.
Перед установкой нужно было немного подготовить узлы:
Установить
open-iscsiс включённымiscsid, а такжеnfs-commonдля томов с режимом доступа ReadWriteMany.Настроить загрузку модулей ядра
iscsi_tcpиdm_cryptпри старте системы.Запретить multipathd вмешиваться в работу Longhorn. В облачных образах Ubuntu multipathd запускается по умолчанию и может перехватывать блочные устройства, подключённые Longhorn, из-за чего возникают проблемы с монтированием. Лично я с этим не столкнулся: заранее изучил документацию Ubuntu по multipath и решил, что лучше перестраховаться, чем потом разбираться с последствиями.
blacklist {
    devnode "^sd[a-z0-9]+"
}
На узле плоскости управления установлен taint, поэтому Longhorn хранит данные только на двух рабочих узлах. Значит, стандартное требование трёх реплик здесь выполнить невозможно. Я уменьшил их количество до двух.
Кроме того, я добавил local-path в качестве второго класса хранения. По сути, это обычный каталог на том узле, где запущен Pod. Репликации нет, зато работает быстро. Отличный вариант для кешей и временных данных.
Класс хранения |
Для чего использовать |
|
Всё, что действительно нужно сохранить |
|
Кеши и временные данные, когда скорость важнее сохранности |
Для проверки я запустил тестовый Pod с томами обоих классов, записал в каждый файл и прочитал его обратно. Том Longhorn успешно создался и перешёл в исправное состояние: по одной реплике на каждом рабочем узле.
Как уменьшить потребление ресурсов Longhorn
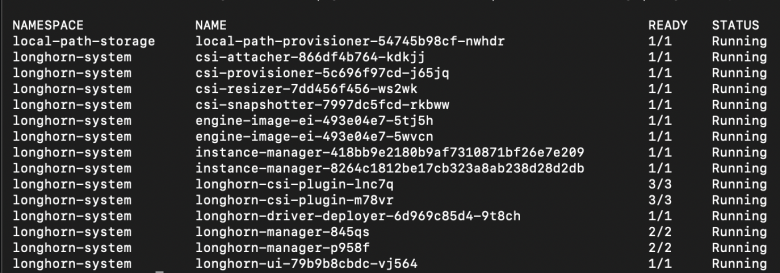
С настройками по умолчанию Longhorn развернул в моём небольшом кластере 22 Pod. Для двух рабочих узлов это показалось многовато, поэтому я решил разобраться, чем занимается каждый из них.
Главными виновниками оказались сайдкары CSI: attacher, provisioner, resizer и snapshotter. На них приходилось 12 Pod, по три реплики каждого компонента. Все они используют механизм выбора лидера, а значит, в каждый момент времени реально работает только один Pod каждого типа. Остальные два просто ждут на случай, если первый выйдет из строя. В кластере с двумя рабочими узлами особой пользы от такой избыточности нет.
Веб-интерфейс Longhorn по умолчанию тоже запускается в двух репликах. Но это всего лишь веб-интерфейс без собственного состояния, который я открываю от силы раз в неделю.
longhornUI:
  replicas: 1
csi:
  attacherReplicaCount: 1
  provisionerReplicaCount: 1
  resizerReplicaCount: 1
  snapshotterReplicaCount: 1
В результате количество Pod сократилось с 22 до 14. Остались демоны, которые действительно выполняют основную работу и запускаются по одному экземпляру на узел: manager, плагин CSI, instance manager и engine image. Пожалуй, сильнее облегчить Longhorn уже не получится.
За это пришлось пойти на компромисс: если узел, на котором работает сайдкар CSI, выйдет из строя, создание и подключение новых томов задержится примерно на минуту, пока Pod не будет повторно назначен на другой узел. На уже смонтированные тома это не повлияет.
Как организовать входящий трафик – MetalLB + Envoy Gateway
Над этой частью я думал дольше всего.
Сначала хотелось пойти самым простым путём: открыть NodePort и направлять на него трафик через Nginx Proxy Manager (NPM), который уже обслуживает остальные сервисы моей домашней лаборатории.
Но у NodePort есть свои неудобства. Приходится обращаться к IP-адресу конкретного узла через порт из диапазона 30000. NPM не умеет работать с пулами вышестоящих серверов с проверкой их доступности. А если бы мне понадобилась маршрутизация по SNI, пришлось бы вручную прописывать конфигурацию nginx с ssl_preread в обход интерфейса NPM. Нет уж, спасибо.
Раньше очевидным решением внутри кластера был ingress-nginx, но теперь этот проект закрыт: команда Kubernetes прекратила выпуск новых версий и исправлений безопасности. Сам Ingress API больше не развивается, а дальнейшее развитие экосистемы связано с Gateway API. Поэтому я выбрал следующую связку:
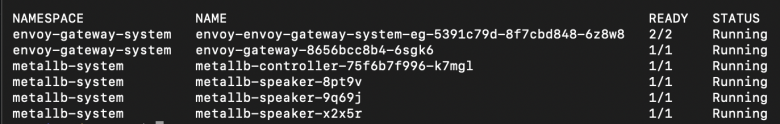
MetalLB в режиме L2 – выдаёт сервисам типа
LoadBalancerнастоящие IP-адреса локальной сети из небольшого диапазона, который я выделил за пределами пула DHCP. Если один из узлов выходит из строя, IP-адрес переходит на другой. При единственном физическом хосте пользы от этого немного, но если я когда-нибудь добавлю новые серверы, ничего переделывать не придётся. К тому же именно так подобные задачи решают в промышленных кластерах на собственной инфраструктуре.Envoy Gateway – реализация Gateway API, которая позволяет обрабатывать трафик L7 (
HTTPRoute,GRPCRoute) и L4 (TCPRoute,UDPRoute,TLSRoute) через единую точку входа. Всё настраивается через YAML-манифесты, которые хранятся рядом с конфигурациями соответствующих приложений.
Internet ─► NPM (TLS, *.k8s.mydomain.com) ─► MetalLB IP ─► Envoy Gateway ─► HTTPRoute ─► app
Шлюз получает фиксированный IP-адрес от MetalLB через ресурс EnvoyProxy и принимает обычный HTTP-трафик для *.k8s.mydomain.com. NPM отвечает за TLS с помощью уже настроенного Let’s Encrypt и перенаправляет весь трафик на этот IP-адрес. Теперь для публикации нового приложения достаточно создать HTTPRoute. К настройкам NPM больше возвращаться не нужно:
apiVersion: gateway.networking.k8s.io/v1
kind: HTTPRoute
metadata:
  name: myapp
spec:
  parentRefs: [{name: eg, namespace: envoy-gateway-system}]
  hostnames: [myapp.k8s.mydomain.com]
  rules: [{backendRefs: [{name: myapp, port: 8080}]}]
Примечание: Helm-чарт MetalLB по умолчанию также устанавливает frr-k8s – Pod с пятью контейнерами на каждом узле. Он нужен только для BGP, а в режиме L2 ничего не делает. Поэтому достаточно добавить --set frrk8s.enabled=false, и лишние Pod не появятся.
Ловушка с X-Forwarded-Proto
При первом же запросе через curl всё заработало, но в заголовках ответа тестового приложения обнаружилось следующее:
X-Forwarded-Proto: http
Хотя я подключался по HTTPS. NPM правильно установил заголовок, но Envoy услужливо перезаписал его, указав протокол своего соединения с NPM, то есть обычный HTTP.
В результате приложения за Envoy считали бы, что к ним обращаются по HTTP. Отсюда и циклические перенаправления, ссылки с http:// на страницах и защищённые cookie, которые незаметно перестают устанавливаться.
Решение – указать Envoy, что перед ним находится один доверенный промежуточный прокси:
apiVersion: gateway.envoyproxy.io/v1alpha1
kind: ClientTrafficPolicy
metadata:
  name: trust-reverse-proxy
  namespace: envoy-gateway-system
spec:
  targetRefs:
    - group: gateway.networking.k8s.io
      kind: Gateway
      name: eg
  clientIPDetection:
    xForwardedFor:
      numTrustedHops: 1
После этого X-Forwarded-Proto стал содержать https, а в X-Real-Ip появился настоящий IP-адрес клиента.
Первым через эту схему я опубликовал веб-интерфейс Longhorn. Теперь все ссылки на API в нём корректно формировались с https://.
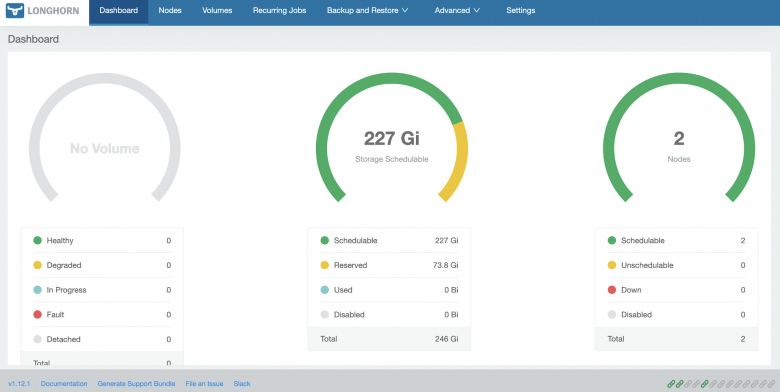
Примечание: у веб-интерфейса Longhorn нет авторизации. Любой, кто получит к нему доступ, сможет удалять тома. У меня интерфейс доступен только из локальной сети, но я всё равно собираюсь защитить его с помощью Envoy SecurityPolicy.
«Мои узлы используют 70% оперативной памяти!»
Через несколько дней Proxmox начал показывать, что каждый узел использует около 70% оперативной памяти. Первой мыслью было увеличить объём RAM. Но прежде я решил разобраться, что происходит на самом деле:
Узел |
RAM |
Реально используется |
Страничный кеш |
Доступно |
kube-server-01 |
8 ГБ |
24% |
3,5 ГБ |
6,0 ГБ |
kube-agent-01 |
12 ГБ |
9% |
7,5 ГБ |
10,8 ГБ |
kube-agent-02 |
12 ГБ |
9% |
7,4 ГБ |
10,8 ГБ |
Давление на память (PSI) на всех узлах оказалось нулевым. Почти все эти 70% приходились на страничный кеш, который Linux заполнил при загрузке образов и дисковых операциях Longhorn. Если приложениям понадобится память, система сразу освободит её за счёт кеша.
Proxmox считает эту память занятой, потому что механизм ballooning отключён. Без balloon-драйвера гостевая система не может сообщить гипервизору, сколько памяти она реально использует. Поэтому Proxmox учитывает все страницы памяти, к которым виртуальная машина когда-либо обращалась на физическом хосте.
На этот показатель стоит обращать внимание, только если оперативная память заканчивается у самого физического хоста. А для оценки состояния виртуальных машин лучше следить за доступной памятью (available) и PSI.
После установки metrics-server команда kubectl top показала ту же картину:
NAME             CPU(cores)   CPU(%)   MEMORY(bytes)   MEMORY(%)
kube-agent-01    105m         5%       912Mi           7%
kube-agent-02    123m         6%       930Mi           7%
kube-server-01   298m         14%      1897Mi          24%
Вся платформа целиком – Kubernetes, Calico, Longhorn, MetalLB, Envoy Gateway и metrics-server – занимает меньше 4 ГБ оперативной памяти. Самый прожорливый отдельный процесс – kube-apiserver, которому требуется около 830 МБ.
И кто там говорил, что Kubernetes слишком тяжёлый для мини-ПК?
Теперь, когда вопросы с хранилищем и входящим трафиком решены, у меня наконец-то есть полноценный кластер, на котором можно нормально разворачивать и тестировать разные решения.
Первым делом я хотел попробовать настроить SPIRE для идентификации рабочих нагрузок:
SPIRE – выдача идентификаторов SPIFFE рабочим нагрузкам внутри кластера.
Entra ID Federated Identity Credentials – обмен JWT, выданного SPIRE, на токен Azure без необходимости где-либо хранить секреты.
Федерация SPIRE-to-SPIRE – объединение кластера с отдельным доменом доверия (возможно, на самостоятельной ВМ) с поддержкой mTLS между доменами.
Но это уже тема для отдельной статьи.
Весь код Terraform и Ansible доступен в репозитории, если захотите попробовать собрать такой кластер самостоятельно.
Стенд развёрнут на Proxmox VE 9.2.2, Kubernetes v1.36.5 и Ubuntu 26.04.
Собрать Kubernetes-кластер — одна задача, наладить работу приложений в нём — уже другая. Здесь важно разобраться, как K8s взаимодействует с контейнерными runtime и как автоматизировать сборку и доставку приложений. Обе темы будут разбираться на ближайших бесплатных уроках Otus:
10 ноября, 20:00. «CRI — обзор контейнерных runtime». Записаться
16 ноября, 20:00. «GitlabCI + ArgoCD — сборка и доставка приложений, не покидая кластер». Записаться
Больше открытых уроков можно посмотреть в календаре мероприятий.