

Как построить конвейер обезличенных синтетических данных и убедиться, что они не врут? Собрал полезную статью для руководителей разработки и QA, продакт‑менеджеров и всех, кто работает с тестовым контуром.
Я уже более 10 лет работаю с тестовыми средами, и раньше делал ошибку: выгружал из прода 200 000 строк, менял фамилии на обезличенные шаблоны, и считал, что все окей. А затем как‑то заметил, что в выгрузке остались номера договоров. Мне повезло, что именно я нашел их первым, особенно учитывая всё более суровую регуляторку. С тех пор я отношусь к тестовым данным также серьезно, как к проду.
И я такой не один. По опросу «Гарды» среди российских компаний почти половина регулярно переносит в тестовые среды копии продуктивных баз без изменений, а 18,8% держат тестовые базы в том же кластере, что и боевые. При этом с 30 мая 2025 года по 420-ФЗ утечка данных 1 000–10 000 человек стоит юрлицу от 3 до 5 млн рублей, а повторная — от 1% до 3% годовой выручки, минимум 25 млн.
Какие задачи решает создание синтетических массивов?
Прежде чем браться за тестовые данные, важно четко сформулировать, зачем вам это. Есть четыре основных задачи, которые можно решить с их помощью.
Задача |
Что критично воспроизвести |
Чем можно пожертвовать |
Типичный объём |
Основной метод |
Функциональное и регресс |
Покрытие состояний и переходов, ссылочная целостность, валидность форматов, наличие всех справочных значений |
Реальные пропорции. Хоть 50/50 — лишь бы все ветки были |
100 МБ — 20 ГБ |
Правила + подмножество прода |
Нагрузочное и производительность |
Кардинальность, скошенность, корреляции, доля NULL, длина строк, распределение по партициям, физический порядок вставки |
Осмысленность конкретных значений — планировщику всё равно, «Петров» там или «Ыфвап» |
0,5 — 50 ТБ |
Статистика + масштабирование |
Обучение и валидация моделей |
Совместное распределение, редкие классы, временна́я динамика, сезонность, дрейф |
Точное соответствие форматам систем‑источников |
1 ГБ — 5 ТБ |
Нейросетевой синтез |
Демо, обучение людей, песочницы |
Правдоподобие «на глаз», связность историй, приличные ФИО и адреса |
Статистика вообще. Никто её не проверяет |
10 МБ — 5 ГБ |
Правила + LLM |
Бывает, что команда полгода строит пайплайн на CTGAN, покупает видеокарты, а нужны были пять тысяч строк для регресса, где важно только одно — чтобы у клиента было от нуля до семи карт. Это делается за два дня на фикстурах. В общем, всегда держите в голове конкретную цель.
Уровни реалистичности синтетических тестовых данных
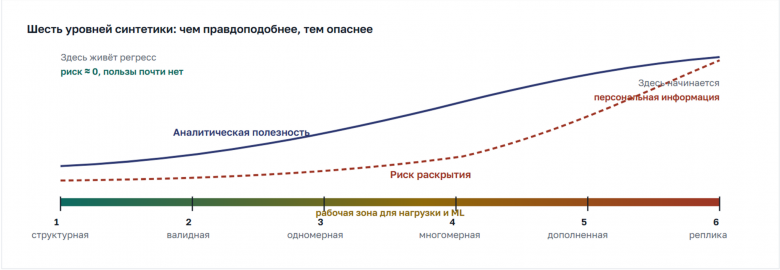
Синтетические данные бывают очень разными: от незаполненных болванок с правильными типами полей до почти полной копии прода.
№ |
Уровень |
Что воспроизводится? |
Для чего реально годится? |
Риск раскрытия |
1 |
Структурный |
Только схема: типы, длины, обязательность. Значения — шум |
Прогон миграций, проверка сборки, smoke |
Нулевой |
2 |
Валидный |
Плюс бизнес‑правила и ограничения: контрольные суммы, диапазоны, FK |
Функциональные тесты, интеграции, автотесты API |
Нулевой |
3 |
Одномерный |
Плюс маргинальные распределения каждого поля по отдельности |
Первые прикидки по объёму, отчёты «на глаз» |
Низкий |
4 |
Многомерный |
Плюс совместные распределения и корреляции между полями |
Нагрузочное тестирование, витрины, BI‑регресс |
Умеренный |
5 |
Дополненный правдоподобный |
Плюс тонкая структура: сезонность, редкие классы, поведенческие цепочки |
Обучение моделей, антифрод, аналитические гипотезы |
Заметный |
6 |
Реплика |
Практически замещает реальные данные в анализе |
Исследования и публикации — и только с формальными гарантиями |
Высокий |
Уровень выбирается под задачу (об этом писал выше). Для регресса хватает второго, для нагрузочного тестирования нужен четвертый, для машинного обучения — пятый. Шестой в корпоративной практике чаще всего не нужен.
Маскирование, псевдонимизация и синтез с юридической точки зрения
Этот раздел лучше проговорить с юристом и безопасником на первой же встрече. Разница между тремя подходами не техническая, а правовая, путают их очень часто. Закон не запрещает работать с тестовыми данными — он запрещает работать с ними небрежно. Граница между псевдонимизацией, обезличиванием и синтезом не техническая, а правовая, и цена ошибки здесь не часы переделки, а оборотные штрафы и репутация.
Маскирование с обратимым ключом — это псевдонимизация. Вы заменили фамилию на код, а ключ положили в хранилище. Субъекта без ключа не определить. Но ключ существует, а значит это по‑прежнему персональные данные. Тестовый контур остается ИСПДн со всеми требованиями к защите, и штрафы за утечку из него ложатся на вас.
Обезличивание регулируется жестко. С 1 сентября 2025 года действует приказ Роскомнадзора № 140 от 19.06.2025 (замена прежнего № 996 от 2013 г.). Методы в целом те же: идентификаторы, перемешивание, изменение состава и семантики, декомпозиция — плюс новый метод преобразования массива. Очень важны требования к самому процессу, и их редко кто читает.
Что требует приказ № 140 и что из этого ломает привычную практику:
Нельзя хранить обезличенные данные вместе с исходными. Никаких рядом лежащих clients и clients_masked.
Ключ соответствия хранится отдельно и третьим лицам не передается. Имейте в виду, что, к примеру, подрядчик по нагрузочному тестированию — это третье лицо.
Локальные акты о методах обезличивания и о применяемых системах не должны быть доступны третьим лицам. То есть описание вашего пайплайна маскирования — уже уязвимый документ.
Ведется учет всех действий. Каждую выгрузку нужно фиксировать в журнале.
Существует 6 основных способов получить тестовые данные. Рассмотрим их детально в таблице
Подход |
Обратимость |
Статус по 152-ФЗ |
Ссылочная целостность |
Годится для нагрузки |
Трудозатраты на старте |
Копия прода «как есть» |
– |
ПДн в полный рост |
идеальная |
да |
нулевые |
Маскирование с ключом (FPE / HMAC) |
есть |
ПДн (псевдонимизация) |
сохраняется |
да |
низкие |
Обезличивание по приказу № 140 |
частичная |
обезличенные ПДн, ст. 13.1 |
требует усилий |
частично |
средние |
Синтез без формальных гарантий |
нет |
не ПДн — если доказано |
нужно проектировать |
да |
высокие |
Синтез с дифференциальной приватностью |
нет |
не ПДн, с гарантией |
нужно проектировать |
хвосты умирают |
очень высокие |
Гибрид: правила + синтез + каталог патологий |
нет |
не ПДн — если доказано |
проектируется явно |
да, лучше всех |
средние |
Здесь как раз очень полезен синтез. Вы не переделываете записи реальных людей, а создаете новые. Нет записи, которая соответствует конкретному человеку, — нет и ПД. Но и здесь есть регуляторные требования.
Росстандарт выпустил первые нормативы — их подготовила Ассоциация больших данных. Три документа: ПНСТ 1064–2026 — основные понятия и термины, ПНСТ 1065–2026 — архитектура и методы синтеза, ПНСТ 1066–2026 — оценка качества результатов. Действуют они с 1 сентября 2026 года, то есть уже сейчас. Там наконец‑то есть то, чего не хватало: как оценить достоверность, как измерить риск восстановления исходных данных, как валидировать, как маркировать и проводить аудит.
Как построить конвейер синтетических данных?
Теперь переходим к практике: от минимизации хаоса в тестовых данных до автоматизации за 7 шагов. Порядок действий здесь важен, не советую перескакивать этапы.
Шаг 1. Инвентаризация и профилирование
Классифицировать поля нужно по содержимому, а не по именам. В колонке field_17 в старой таблице вполне могут лежать паспортные данные, а колонка passport — красивая, но пустая с 2019 года. Классификатор, который смотрит только на заголовки, найдет passport и пропустит field_17. А отвечать за утечку придется именно за field_17.
Для каждого поля нужно выяснить тип данных и посчитать пустые значения — отдельно пустые строки, это не одно и то же. Дальше считаем количество уникальных значений и собираем топ-20 из них: смотрим, какую долю они занимают суммарно, — так сразу видны перекосы в распределении. И вместо средней длины строки полезнее построить гистограмму распределения длин — по ней картина заметно нагляднее.
Где скрываются проблемы?
Поля‑помойки, где лежит и телефон, и адрес, и переписка с юристом. Справочники, которые внезапно оказываются ПД: к примеру, контрагенты, где половина записей — ИП, а ИП это физлицо с ФИО в названии. И косвенные идентификаторы: номер офиса, дата открытия счета и сумма первого взноса (в небольшом городе этого достаточно, чтобы найти конкретного человека).
Какие инструменты использовать?
Для быстрого старта подойдет ydata‑profiling, для повторяемых проверок — Great Expectations или Soda, а для больших таблиц — обычный SQL на ClickHouse: он быстрее любой библиотеки. Персональные данные хорошо находит из коробки «Гарда Data Masking» с машинным обучением — на старых схемах с полями f_01…f_88 она экономит недели работы.
Метрика готовности к следующему этапу — доля полей с подтвержденной классификацией. Если она ниже 95%, идти дальше бессмысленно: неизвестность просто переедет на следующий этап и найдется в проде. Да, это скучно. Да, займет две‑три недели. И обойти это не получится — я пробовал трижды.
Шаг 2. Что такое контракт на данные и зачем его создавать?
Контракт на данные — это короткий документ о том, какой датасет считается правильным. Он защитит всех от бесконечных переписок. Пишет его потребитель, а не генератор, иначе получится описание того, что удобно отдавать, а не того, что нужно. Хранить — в YAML рядом с кодом, чтобы контракт жил в версиях и проходил ревью.
# contracts/acquiring_load.yaml
dataset: acquiring_load_4tb
purpose: performance          # одна из четырёх задач, не «универсальный»
owner: perf-team
source_profile: profiles/acquiring@2026-07-14.json

volume:
  rows: 1_300_000_000
  size_tb: 4.1
  tolerance: 0.03

must_preserve:
  cardinality:
    merchant_id: { value: 41_000, tol: 0.05 }
    card_token:  { value: 78_000_000, tol: 0.05 }
  skew:
    merchant_id: { gini: 0.81, tol: 0.03 }
  partitions:
    last_90d_share: { value: 0.70, tol: 0.02 }
  nulls:
    mcc: { value: 0.031, tol: 0.005 }
  string_length:
    merchant_name: { mean: 34.2, p95: 61, tol: 0.10 }

must_not_contain: [ real_pan, real_msisdn, real_fio, real_contract_no, real_inn ]

edge_cases:                  # ссылки на каталог патологий, см. шаг 6
  include: [ EC-014, EC-021, EC-088, EC-102, EC-137 ]
  min_occurrences: 200

privacy_gates:
  exact_row_match: 0
  dcr_p5: ">= holdout"
  mia_auc: "<= 0.55"

reproducibility:
  seed: 20260901
  generator_version: "2.3.1"

lifecycle:
  ttl_days: 14
  storage_class: restricted-test
Выглядит как бюрократия, а работает как страховка: через полгода на вопрос, почему у вас 41 000 мерчантов вместо двенадцати, ответит конкретный файл, а не уволившийся коллега голосовухой. Есть три поля, которые все норовят выкинуть, а потом жалеют: seed, ttl_days и min_occurrences.
Шаг 3. Подбираем генератор для каждого типа данных
Главное не то, какой генератор выбрать, а какой генератор подходит каждой группе полей. В типичной корпоративной базе около 80% данных спокойно генерируются правилами, еще 15% требуют статистики, и лишь оставшиеся 5% — ради них и нужна нейросеть.
Разбивка по группам полей
Что генерируем? |
Чем? |
Почему именно так? |
Инструменты |
Первичные и внешние ключи, токены |
Детерминированные функции: HMAC‑SHA256, формат‑сохраняющее шифрование FF1 |
Нужна воспроизводимость и согласованность между системами. Нейросеть здесь не нужна и опасна: она может «запомнить» реальный идентификатор |
|
Форматные атрибуты РФ: ИНН, СНИЛС, БИК, номер карты |
Правила с корректными контрольными разрядами |
Валидаторы на входе отбракуют всё остальное, и вы будете тестировать не систему, а свой генератор |
Собственные функции, |
Числовые и категориальные поля с зависимостями |
Гауссовы копулы, CTGAN, TVAE |
Ловят совместное распределение и корреляции. Копула часто не хуже GAN и в десятки раз быстрее — начинайте с неё |
SDV ( |
Цепочки событий: транзакции, сессии, статусы заявок |
PAR из SDV, DoppelGANger, либо марковская цепь + распределение интервалов |
Порядок и интервалы важнее значений. В восьми случаях из десяти марковской модели достаточно, а стоит она в пятьдесят раз дешевле |
SDV |
Свободный текст: обращения, комментарии, протоколы |
Локальная LLM с жёсткими ограничителями и пост‑фильтрами |
Единственное место, где без нейросети правда никак. И единственное, где реален риск дословного запоминания |
Self‑hosted модели с русским языком; для деидентификации — NER: Natasha, DeepPavlov, Presidio |
Ссылочная структура между таблицами |
Обход графа FK сверху вниз, генерация родителей раньше детей |
Многотабличные синтезаторы формально не гарантируют целостность — это известная проблема, проверяйте руками |
SDV |
Справочники: ОКВЭД, регионы, валюты, МСС |
Копируем как есть |
Это не персональные данные. Синтезировать их — вредительство: сломаете join и потратите неделю на отладку |
– |
Шаг 4. Чем кормить генератор, чтобы синтетические данные получились реалистичными?
Главное правило: модель учится там же, где живут данные — тот же контур, те же защиты и журналы доступа. Наружу выходит только готовая модель и только после проверки на утечку.
Теперь четыре важных вещи, о которых редко пишут
Размер выборки. Табличной модели хватает 1–5 млн строк. Больше — не лучше: модель дольше учится и сильнее запоминает конкретные записи.
Дедупликация. Дубликаты — главная причина запоминания вместо обобщения. Чистим через MinHash или SimHash с порогом схожести 0,8. На одном проекте только это уменьшило утечки в десять раз.
Канарейки. Перед обучением подмешиваем 300–1000 выдуманных записей с редкими сочетаниями — редкая фамилия, необычный диагноз, точная дата. После генерации ищем их в результате. Нашли — модель течет. Не нашли — гарантий нет, но есть дешевый ежедневный сигнал для CI.
Дифференциальная приватность. Для внутреннего контура обычно лишняя: при ε ≤ 1 вымываются хвосты распределения, ради которых все и затевалось. Вдобавок шум дает ложные срабатывания статистических тестов — аналитик путает его с реальным эффектом. Данные уходят за периметр — нужна. Остаются внутри — без нее почти наверняка обойдетесь.
Шаг 5. Двухконтурная схема, без которой терабайты синтетики не получить
Суть в том, что нейросеть дает структуру, а не объем. Гнать миллиард строк через CTGAN — как возить щебень на велосипеде: можно, но бессмысленно.
Цифры простые: глубокая табличная модель на видеокарте делает десятки тысяч строк в секунду, то есть миллиард — это дни непрерывной работы. А копула или сэмплер на Spark и ClickHouse выдают миллионы строк в секунду с одной машины и растут линейно. Разница — в тысячи раз. Поэтому нужны два контура: медленный учит модель, быстрый размножает результат по требованию.
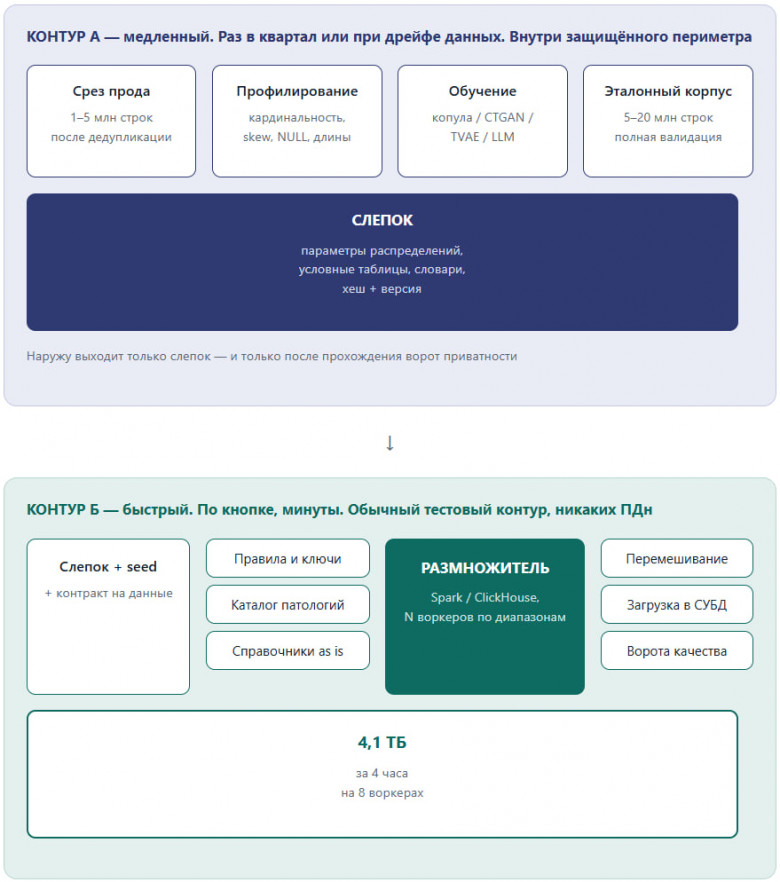
Главное в размножителе — предсказуемость. Заданы три параметра: слепок модели, seed и диапазон номеров строк — и результат всегда один и тот же. Поэтому каждый воркер генерирует свой кусок сам, без общего состояния и координации, и итог сходится побайтово.
-- ClickHouse: скелет размножителя. Zipf по мерчантам через словарь весов,
-- детерминированный PRNG от (seed, номер строки)
INSERT INTO tx_synth
SELECT
    cityHash64(:seed, n)                                  AS rid,
    dictGet('merchant_zipf', 'merchant_id',
            toUInt64(zipf_bucket(rid)))                   AS merchant_id,
    dictGet('card_pool', 'token',
            toUInt64(rid % 78000000))                     AS card_token,
    -- 70% объёма — в последние 90 дней, как в проде
    now() - toIntervalSecond(
        if(rid % 100 < 70, rid % 7776000, 7776000 + rid % 86400000)) AS ts,
    -- логнормаль по суммам + магнит на круглые значения
    round_magnet(exp(4.1 + 0.92 * randNormal(rid)))       AS amount,
    if(rid % 1000 < 31, NULL, dictGet('mcc', 'code', rid % 400)) AS mcc
FROM numbers_mt(:row_from, :row_count)
И три тонкости, которые я узнал благодаря проблемам с нагрузочным тестом.
Первая — порядок вставки. Если генерировать данные по возрастанию ключа, соседние строки станут похожими, сжатие улучшится, а 4 терабайта прода на стенде ужмутся в 1,5 — тест покажет отличные, но фальшивые цифры. В проде данные приходят вперемешку, поэтому перемешивайте их перед загрузкой, хотя бы блоками по несколько миллионов строк. Одна строчка кода — и на диске вдвое больше места.
Вторая — длина строк и доля пустых значений. Скучные метрики, но обе работают. В проде merchant_name в среднем 34 символа, а генератор выдает 12 — таблица выходит в два с половиной раза меньше. В MCC в проде 3,1% пустых значений, у вас ноль — вы не словите ни одного падения на пустом поле и получите другой размер строки в колоночном хранилище.
Третья — сколько терабайт нужно. Большинству команд — ноль. Терабайты нужны нагрузочникам и тем, кто отлаживает запросы на больших таблицах. Остальным хватает среза: 2–3% от прода со связностью покрывают около 95% сценариев, генерируются за минуты и влезают на ноутбук. Просьбы полной копии — это не потребность в данных, а недоверие к срезу, и лечится оно контрактом из шага 2, а не терабайтами.
Шаг 6. Заводим каталог патологий
Генеративная модель по своей природе сглаживает редкие случаи. Это не баг, а ее работа: она держится плотности распределения, а редкие события низкой плотности и бывают по определению. GAN к тому же схлопывает моды, VAE — размывает. Аналитику это не мешает: ему нужны среднее и корреляции. А для тестировщика это беда, потому что баги прячутся именно в хвостах.
Ни один существующий генератор сам не воспроизведет клиента с 412 картами, платеж на копейку, фамилию в 78 символов или транзакцию, пришедшуюся ровно на перевод часов. А в проде все это встречается — и на каждом таком случае однажды кто‑то падал. Отсюда и решение: гибрид, где основную массу данных рисует нейросеть, а редкие крайние случаи приносит готовый каталог исключений.
Каталог патологий — это структурированный список редких случаев: идентификатор, описание, ссылка на инцидент и целевая доля в датасете. Наполняется из четырех источников.
Багтрекер за два‑три года: выгружайте дефекты, где упоминаются данные, форматы, пустые значения и кодировки, — это золотая жила.
Постмортемы прода: каждый инцидент, вызванный данными, становится записью каталога — это дисциплина, а не техника.
Ограничения схемы: для каждого CHECK, NOT NULL и лимита длины нужны значения на границе и за ней.
И наконец, просто подумайте, как вы ломали бы свою систему, если бы за это платили.
ID |
Класс |
Патология |
Что ловит? |
EC-014 |
ФИО |
Фамилия из одной буквы; фамилия 78 символов; двойная через дефис; отчество «оглы»/«кызы»; «ё» и «е» в одной записи; висячий пробел в конце |
Обрезка полей, сортировки, поиск, ширина в отчётах и печатных формах |
EC-021 |
Даты и время |
29 февраля; 31-е в 30-дневном месяце; дата рождения 1900 и завтрашняя; переход на летнее время в исторических данных до 2014; Камчатка (+12) и Калининград (+2) в одной таблице |
Расчёт возраста, дедлайнов, SLA, ночные джобы, оконные функции |
EC-034 |
Суммы |
0,01; максимально допустимая; отрицательная; четыре знака после запятой; ровно на пороге лимита; банковское округление половин |
Переполнения, округления, лимиты, сверки на копейку |
Шаг 7. Как не дать синтетике сломать прод с помощью независимых проверок?
Невалидный датасет не публикуется. Точка. Ворота стоят в CI, у каждого — жесткий порог из контракта.
Лучший тест пригодности данных — не статистика, а планы запросов. Берете топ-50 запросов из pg_stat_statements, прогоняете EXPLAIN (ANALYZE, BUFFERS) на проде и на синтетике и сравниваете типы узлов и оценки кардинальности. Совпало — данные годные. Не совпало — сломано ровно одно распределение, и сразу видно какое. Так я за час нахожу то, что метриками искал бы неделю.
Ловушка DCR. Расстояние до ближайшей реальной записи часто выдают за доказательство приватности — это ничего не значит. Честная проверка такая: отложите часть реальных данных, которых модель не видела, и сравните DCR для этого холдаута и для синтетики. Если синтетика ближе к обучающей выборке, модель просто запоминает. За эту ошибку критикуют половину работ по синтетическим данным.
Тонкости работы с синтетическими данными в России
Тут шаблоны не работают. Зарубежные инструменты в наших реалиях выдают номер соцстрахования вместо СНИЛС и адрес в духе «улица, город, штат». Даже локаль ru_RU в популярных библиотеках дает правдоподобные строки, которые не проходят валидацию.
Следствие простое и обидное: сгенерируете ИНН двенадцатью случайными цифрами — валидатор отсеет около 90% записей. Вы будете тестировать не систему, а свой генератор, и узнаете об этом дня через три.
Атрибут |
Как ломается по умолчанию? |
Как делать? |
Источник справочника |
ИНН |
Случайные цифры не проходят проверку контрольного разряда |
Генерировать первые 9 (или 10) цифр, считать контрольные по весовым коэффициентам. Для юрлица — следить, чтобы первые две цифры соответствовали региону из адреса |
Алгоритм ФНС, коды регионов |
СНИЛС |
То же самое плюс забывают про правило «остаток 100 или 101 даёт 00» |
Веса 9…1 по девяти цифрам, остаток от деления на 101, особый случай для 100 и 101 |
Алгоритм СФР |
КПП, ОГРН, БИК |
Генерируются независимо от ИНН — и получается юрлицо из Владивостока с московским КПП |
Генерировать связкой: регион — ИНН — КПП — БИК обслуживающего банка. Связность важнее правдоподобия отдельных полей |
Справочник БИК, коды регионов |
Номер карты |
Алгоритм Луна соблюли, а БИН взяли реальный действующий — и получили номер, который может существовать |
Луна плюс БИН из тестовых диапазонов платёжных систем. Никогда не используйте боевые БИН своего банка |
Тестовые диапазоны платёжных систем |
Номер телефона |
Все записи вида +7 999 000–00-00, либо реальные существующие номера — и рассылка из тестового контура уходит живым людям |
В России нет зарезервированного диапазона по аналогии с американскими 555. Берите неназначенные диапазоны из реестра нумерации и держите отдельный чёрный список |
Реестр российской системы и плана нумерации (открытые данные Минцифры), выгрузки ЦНИИС |
Адрес |
Готовые локали склеивают случайный город со случайной улицей и случайным индексом. Валидатор адреса такое отбрасывает |
Идти сверху вниз по иерархии ФИАС/ГАР: регион — город — улица — существующий дом — индекс этого дома |
ФИАС / ГАР |
Паспорт |
Серия не соответствует региону выдачи, дата выдачи раньше даты рождения, возраст не бьётся с обязательной заменой в 20 и 45 лет |
Серия = код региона + год выпуска бланка; проверять правило замены документа по возрасту |
Коды регионов |
ФИО |
Транслит или короткие латинские строки. Ломается сортировка, ширина колонок, поиск |
Кириллица, обязательно «ё», двойные фамилии, отчества на ‑оглы и ‑кызы, склонения в тех местах, где система их показывает |
Частотные словари имён |
Правила, которые придётся написать самим. Хорошая новость: это пишется один раз и переиспользуется на всех проектах. У меня эта библиотека живёт уже пятый год и обросла тестами толще, чем сам генератор. Хорошо ещё дописать «Даты и время», «Календарь нагрузки», «Суммы и НДС».
Отдельно про кириллицу: в разных колляциях буква ё встает то после е, то в конце алфавита, и результат сортировки по полю ФИО на синтетике отличается от прода. Если автотесты сравнивают выдачу списка построчно, вы получите красные тесты на ровном месте и потратите день на выяснение, почему база сортирует не так, как ожидал разработчик. Проверяйте колляции до, а не после.
Какие инструменты выбрать в российских реалиях?
Ландшафт собран по слоям, а не по вендорам: вендоры меняются, слои — нет. Часть зарубежных платформ недоступна, а часть неприменима, потому что это SaaS: данные для обучения за периметр не выпускаешь. Открытые библиотеки ставятся локально и работают у всех одинаково.
Слой |
Международная практика |
Что применимо в РФ |
Комментарий |
Поиск чувствительных данных и профилирование |
Microsoft Presidio, ydata‑profiling, Great Expectations, Soda |
Всё перечисленное ставится локально; из коммерческих — «Гарда Data Masking» с ML‑поиском ПДн, решения InfoWatch |
Начните с открытых, коробочное берите, когда схема больше пары тысяч таблиц |
Табличный синтез |
SDV (GaussianCopula, CTGAN, TVAE, CopulaGAN), synthpop, Gretel, MOSTLY AI, Tonic, Syntho, Hazy, K2view |
SDV и synthpop — локально, без ограничений. Из отечественного развивается сервис SyntData у Сбера |
SaaS‑платформы отпадают сами: данные для обучения наружу не выпустишь |
Последовательности и временные ряды |
PAR из SDV, TimeGAN, DoppelGANger |
То же самое, всё открытое |
Марковская цепь плюс распределение интервалов часто не хуже и в разы дешевле |
Текст |
Крупные LLM через API + Presidio для деидентификации |
Только self‑hosted модели с хорошим русским. Для NER — Natasha, Slovnet, DeepPavlov |
Отправлять реальные ПДн во внешний API нельзя. Обучать на них — только локально |
Правила и фикстуры |
Faker, Mockaroo, Datafaker, dsdgen из TPC‑DS |
Faker с локалью |
Это тот слой, который вы всё равно допишете сами. Заложите на него две‑три недели |
Маскирование и подмена |
Delphix, Informatica TDM, IBM Optim |
«Гарда Data Masking», решения на |
Помните: обратимое маскирование не выводит данные из‑под 152-ФЗ |
Масштабирование до терабайт |
Spark, Trino, dbt |
Spark, ClickHouse ( |
ClickHouse на генерации плоских таблиц вне конкуренции по скорости |
Оценка качества и приватности |
SDMetrics, Anonymeter, TAPAS |
Всё открытое, работает. Как рамка для отчётности — ПНСТ 1066–2026 |
Отчёт по ПНСТ — то, что теперь спрашивают на комитете вместо рассуждений |
Никакой инструмент не закрывает всю цепочку. Реалистичный стек — это пять‑шесть открытых библиотек, одна коммерческая система маскирования и примерно три тысячи строк своего кода под российскую специфику и каталог патологий.
План создания конвейера синтетических данных на 90 дней с раскладкой по неделям
Этот алгоритм действий поможет получить первый работающий домен и научиться на нем: второй домен потом делается за две недели, третий — за одну.
Недели |
Что делаем? |
Что должно быть на выходе — иначе дальше не идём |
1–2 |
Профилирование источников, классификация полей по содержимому, поиск косвенных идентификаторов |
Профиль в формате JSON, зафиксированный по дате. Классификация ≥ 95% полей. Список «полей‑помоек», требующих NER |
3–4 |
Контракты на данные с потребителями. Выбор одного пилотного домена — самого болезненного, а не самого простого |
YAML‑контракт в репозитории, прошедший ревью потребителя. Согласованный с ИБ и юристами способ обработки: маскирование, синтез или гибрид |
4–6 |
Сборка каталога патологий: выгрузка дефектов за 2–3 года, разбор постмортемов, границы схемы |
Не менее 60 записей с ID, описанием, ссылкой на инцидент и целевой долей. Меньше 60 — вы плохо копали |
6–8 |
Пилотная генерация: слепок, размножитель, правила под российские форматы, справочники as is |
Датасет 1–10 ГБ, проходящий первые ворота. Воспроизводимый по seed побайтово |
8–10 |
Валидация: все три группы метрик, калибровка порогов, сравнение планов запросов |
Отчёт по качеству, пороги записаны в контракт, ворота стоят в CI и умеют ронять сборку |
10–11 |
Доставка: сервис выдачи окружений, версионирование слепков, TTL, журналирование |
Команда получает датасет по кнопке за минуты, без заявки в ИБ. Это главный видимый результат для бизнеса |
11–12 |
Масштабирование до целевого объёма, нагрузочная сверка с продом |
Совпадение планов на топ-50 запросов ≥ 90%. Размер таблиц на диске в пределах 5% от прода |
Подводим итоги
Синтетические данные — не панацея. Модель сглаживает хвосты, генератор путает СНИЛС с зарубежной страховкой, а терабайты прода на стенде лгут, если данные вышли слишком прилизанными. Работает только связка: инвентаризация по содержимому полей, контракт с порогами в CI, каталог патологий из реальных инцидентов, проверка приватности через холдаут и планы запросов как главный тест.
Юридические требования зафиксируйте до первой выгрузки — ошибки, связанные с приказом № 140 и штрафы по 420-ФЗ стоят слишком дорого, будьте аккуратны. Начните с одного домена и среза на 2–3% прода: этого хватит почти всем, а второй домен затем делается за две недели. Соберете конвейер целиком — тесты на синтетике будут предсказывать прод. Соберете не все — будете третий день искать баг, который сидит в вашем генераторе.
Если тема построения синтетического конвейера, да и вообще совершенствования тестового контура вам близка, — заходите в телеграм‑канал о тестировании. Там вы найдете больше информации на эту тему.