

Привет, Хабр! Меня зовут Дмитрий Бухонов, я бэкенд-разработчик во Флаувау. У нас есть production S3-хранилище, которое годами переживало разные поколения сервисов, интеграций и команд. В какой-то момент в нем накопилось больше 65 ТБ данных и десятки миллионов объектов, а стоимость хранения превысила 150 тыс. рублей в месяц. При этом мы уже не всегда понимали, какие файлы используются, кто владеет отдельными директориями и можно ли безопасно удалить тот или иной объект.
В статье я расскажу, как мы восстановили карту хранилища, организовали миграцию без остановки сервиса и сократили объем данных примерно с 65 до 45 ТБ.
Почему обычный cleanup не подошел
Исторически S3-хранилище Флаувау росло вместе с продуктом. В нем накапливались данные разных поколений сервисов: старые директории, временные файлы, артефакты интеграций, дубликаты и копии, которые могли давно перестать использоваться.
Проблема была не только в объеме. Мы постепенно теряли понимание того, что именно храним:
у некоторых директорий отсутствовал понятный владелец;
связи файлов с БД не всегда можно было восстановить;
часть данных использовалась через hardcoded URL;
существовали разные точки записи в S3;
назначение некоторых данных осталось за пределами текущей модели приложения.
К тому же стоимость хранения продолжала расти, а вот понимание содержимого — нет. При этом просто удалить все, что выглядит старым или не было связано с актуальными таблицами, нельзя: так можно потерять пользовательские файлы.
Изначально мы смотрели на задачу как на обычный cleanup:
найти ненужные файлы;
удалить их;
проверить результат;
повторить.

Но первые тесты показали, что даже технически такой подход не выглядит привлекательным. На небольшом объеме проверка существования объектов оказалась дороже самого удаления:

По предварительной оценке, устранение миллиона записей могло занять шесть дней. И это только часть данных: реальный объем хранилища превышал 65 ТБ. Но скорость оказалась не главной проблемой. Мы не могли точно определить, от каких объектов можем безопасно избавиться.
Кроме того, production продолжал работать под постоянной нагрузкой. Ночного окна для миграции не существовало, а ошибочная очистка могла привести к потере пользовательских файлов. Удаление через S3 API на таком объеме могло занять недели или месяцы.
Конечно же, все пошло не по плану. Простой клинап превратился в миграцию: мы начали переливать данные в новый бакет, а старый перевели в read-only. Это спасло отдачу файлов, которые мы еще не успели перенести или опознать.
Сначала восстановили карту данных
Прежде чем переносить файлы, мы занялись инвентаризацией. Собирали список директорий, выясняли их назначение, искали владельцев, проверяли наличие персональных данных и обсуждали спорные случаи с командами.
Нужно было понять, что делать с каждой директорией. Например, одни файлы можно было удалить, другие требовали проверки, третьи — переноса или сохранения.
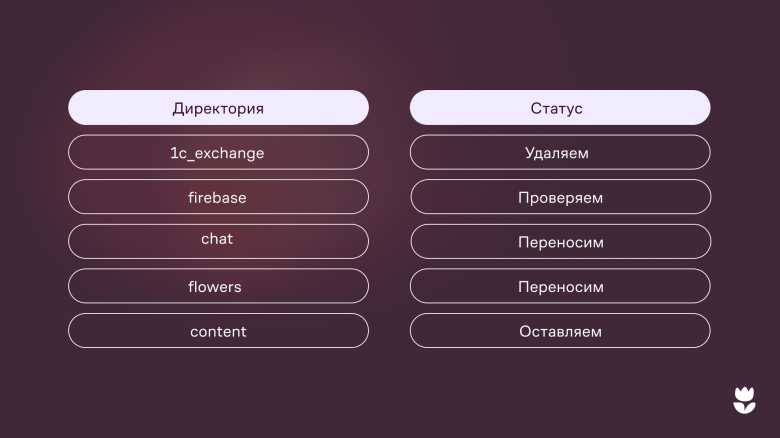
Инвентаризация позволила восстановить несколько важных связей между компонентами: кто отвечает за данные, какие файлы еще используются, какие ключи можно восстановить из БД и какие объекты существуют вне нее.
В процессе стало понятно, что «хвосты» — это не обязательно ошибка или случайность. В большом легаси-хранилище они возникают естественным образом: код меняется, сервисы переезжают, интеграции исчезают, а файлы остаются.
Поэтому мы разделили две задачи: разобраться в данных и безопасно изменить способ их хранения. Первую нельзя было решить одним скриптом удаления.
Перенесли работу с S3 в контекст Media
Следующим шагом стало восстановление архитектурной карты: список директорий S3 → владельцы → таблицы с данными → Application/MediaManager.
Мы начали переносить все обращения к S3 в контекст Media. Для других контекстов предусматривались собственные Application/ExampleMediaManager, а также ответственность за очереди, ключи и директории. Рабочее правило сформулировали так: таблица — новый MediaManager.
Это важно, потому что S3-ключ не всегда можно получить простым чтением поля из БД. В зависимости от сущности приложение может знать, какие файлы ей соответствуют, как они называются и какие варианты изображения должны существовать.
Например, из таблицы f_review_images можно получить ключи изображений отзывов, а из f_product_images — все размеры фотографий продуктов.
Для разных контекстов существовали отдельные менеджеры, в том числе:
BlogMediaManager;CategoryImageMediaManager;CertificateManager;CharityFundMediaManager;ChatMediaManager;ClientQuestMediaManager;CustomerRecipientMediaManager.
Они знали правила, по которым из данных конкретной сущности собираются реальные S3-ключи.
Но для миграции требовался общий механизм, который мог бы работать с разными таблицами единообразно. Так появился MediaCleanupProcessorManager.
Его задача — принять имя таблицы и запись, определить соответствующий контекст, вызвать нужный MediaManager и получить список S3-ключей. В результате мы получили цепочку: tableName + row → список S3-ключей
Ключевая идея здесь в том, что БД хранит бизнес-данные, а MediaManager знает правила работы с файлами. Вместе они позволяют восстановить набор объектов, которые должны существовать для конкретной сущности. Благодаря этому мы могли переносить то, что система действительно может использовать, а не пытаться скопировать весь S3 целиком.
Новый бакет вместо удаления старого
Мы решили не очищать старое хранилище на месте. Вместо этого создали новый бакет, в котором должны были остаться актуальные данные, а первый сохранили как резервный источник на время миграции.
Дальнейшую архитектуру проектировали так, будто обязательно ошибемся. Поэтому вместо необратимого удаления предусмотрели возможность прочитать файл из старого бакета, если его еще нет в новом.
Для чтения использовалась схема dual-read, single-write: чтение из нового хранилища с fallback на старое, запись — только в новое. Так мы не создавали объекты в двух местах и не усложняли миграцию синхронизацией параллельных записей. Старое хранилище оставалось источником для чтения тех файлов, которые еще не были перенесены.
Схема чтения выглядела так:
Приложение пытается получить файл из нового бакета.
Если объект найден, возвращает его.
Если новый бакет отвечает 404, запрос уходит в старый.
Старый бакет перестал быть основным местом хранения, но продолжал участвовать в обслуживании запросов. Это позволяло переносить данные постепенно, не требуя, чтобы к моменту переключения все объекты уже находились в новом месте.
Fallback оказался не только страховкой
Fallback решал две задачи одновременно:
Первая — очевидная: если файл не находился в новом бакете, пользователь все еще мог получить его из старого. Это снижало риск того, что неполная миграция приведет к недоступности данных.
Вторая задача — наблюдаемость. Каждый fallback логировался. По этим событиям можно было понять, какие объекты по-прежнему запрашиваются из старого хранилища.
Вместо того чтобы пытаться заранее угадать полный список актуальных файлов, мы получили информацию из реального трафика. Production показывал, какие объекты еще нужны, а какие уже обслуживаются из нового бакета.
Это позволяло измерять прогресс, находить отсутствующие файлы и исправлять проблемы точечно. Если объект был нужен, но не попал в новое хранилище, его можно было досинхронизировать, а не запускать полную миграцию заново.
Таким образом, fallback стал и защитным механизмом, и источником данных о фактическом использовании хранилища.
Как мы организовали управляемый перенос
Для переноса использовали консольные команды, которые позволяли выбирать таблицу и ограничивать объем обработки. Для каждой записи восстанавливались ключи, после чего задача на копирование отправлялась в очередь:
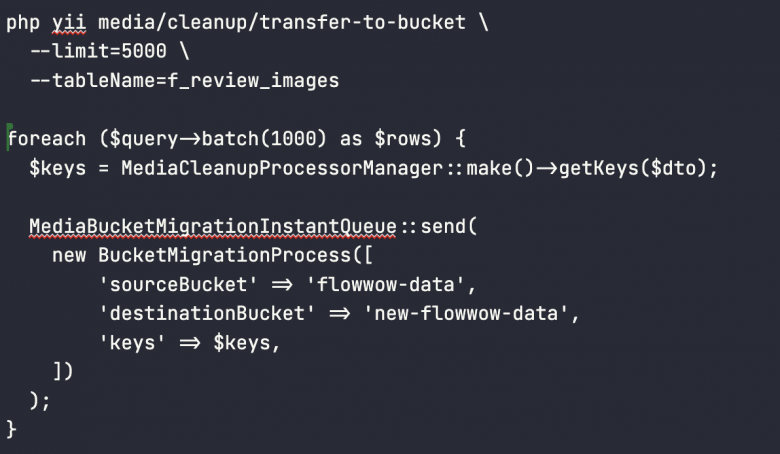
Здесь важны два момента:
обработка не требовала загружать весь набор данных в память: запрос обходился пакетами по 1 000 записей;
копирование отделено от получения данных из БД. Команда формирует набор ключей и отправляет задачу в очередь, а перенос объектов выполняется отдельно.
Такой запуск можно было ограничить конкретной таблицей, лимитом, диапазоном fromTableId / toTableId или определенными tableIds. Также можно было ограничить повторную обработку файлами, созданными до переключения записи в новый бакет.
Это позволяло управлять миграцией итеративно: запускать перенос для конкретных частей данных, повторять обработку проблемных записей и возвращаться к пропущенным объектам.
Прогрев нового бакета
Новый бакет нужно было наполнить актуальными объектами. Мы делали это постепенно, опираясь на данные БД и правила соответствующих MediaManager.
Получение ключей и копирование выполнялись отдельными задачами через RabbitMQ. Команда могла обрабатывать записи пакетами, а задачи на копирование отправлялись в очередь. Диапазоны и ограничения позволяли повторно запускать обработку с нужного места.
Такой подход давал возможность прогревать хранилище итеративно, не пытаясь перенести все объекты одним действием. При этом источником списка файлов были не имена объектов в S3 сами по себе, а бизнес-сущности, для которых приложение могло восстановить соответствующие ключи.
Но именно на этапе прогрева мы столкнулись с двумя проблемами: деградацией RabbitMQ под большой очередью и неудачной стратегией повторных попыток.
RabbitMQ: больше consumers не всегда означает быстрее
Сначала для обработки задач использовали 10 consumers. После расчетов их количество увеличили до 50, рассчитывая ускорить перенос.
На большом объеме появились проблемы:
очередь росла быстрее, чем обрабатывалась;
при 500 000 сообщений и более RabbitMQ начал хаотично зависать на подключениях;
возникали случайные connection timeout;
часть consumers простаивала;
публикация задач опережала обработку.
Большая очередь сама по себе становилась нагрузкой на инфраструктуру. Увеличение числа consumers не гарантировало, что система начнет справляться с потоком задач быстрее.
По наблюдениям во время миграции при росте очереди поведение RabbitMQ становилось нестабильным, а часть обработчиков не получала полезной работы. В результате мы не могли рассматривать количество consumers как единственный параметр, определяющий скорость переноса.
Этот опыт также повлиял на то, как мы стали смотреть на обработку ошибок: даже если отдельная задача завершается неудачно, важно понимать, должна ли она вообще занимать ресурсы повторной попыткой.
Retry может снижать throughput
Во время копирования часть объектов физически отсутствовала в старом бакете. Но система воспринимала такие случаи как временную ошибку и повторяла обработку.
В результате одна проблемная запись могла занимать десятки секунд. Consumers тратили время на новые попытки, которые не могли привести к успешному копированию, а общий throughput падал.
Retry имеет смысл при временных инфраструктурных сбоях: сетевых проблемах, тайм-аутах или временных ошибках S3. Но если исходного объекта нет, повторная попытка не поможет.
В коде это различие выражено через проверку NoSuchKey:
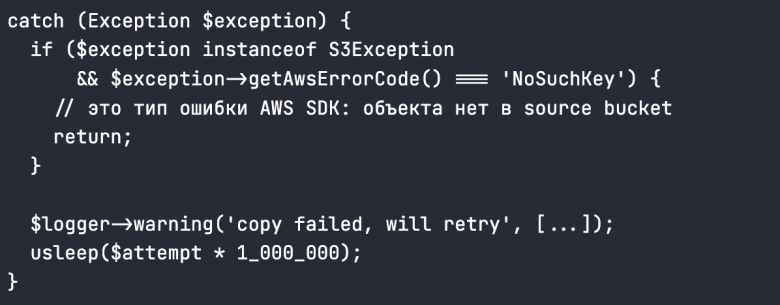
Если AWS SDK возвращает NoSuchKey, обработка завершается без новой обработки. Для остальных ошибок в этом фрагменте предусмотрены логирование и retry с задержкой, зависящей от номера попытки.
Смысл решения не в том, чтобы отказаться от повторов вообще. Retry необходим, когда ошибка может исчезнуть сама. Но он становится вредным, если система снова запускает операцию, которая не может завершиться успешно без изменения исходных данных.
Для миграции это особенно важно: миллионы объектов и большая очередь превращают даже небольшую долю бесполезных повторов в заметную нагрузку.
Что получилось в итоге
В результате мы перенесли актуальные данные в новый бакет и постепенно сократили зависимость от старого хранилища.
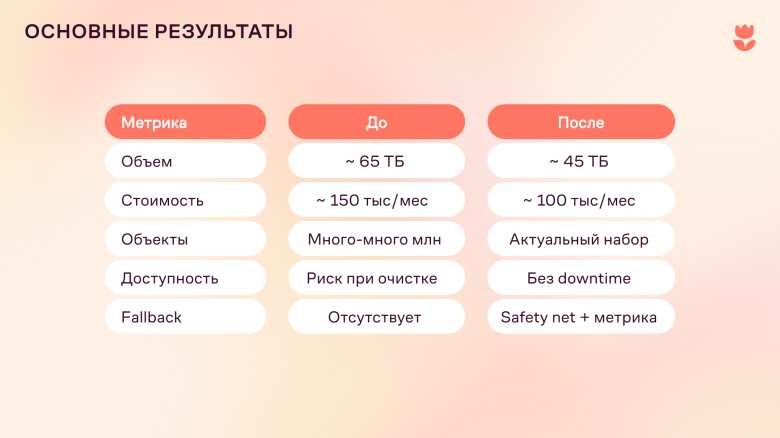
Около 90% запросов почти сразу начали обслуживаться новым бакетом. По мере миграции fallback постепенно свелся практически к нулю. Пользователи не заметили перехода, downtime не потребовался, а потерянные объекты удалось досинхронизировать точечно.
Дополнительно мы сделали дешевый резервный слой на всякий случай с последующей очисткой через lifecycle-политику.
Результатом всего этого приключения стала не только экономия на хранении. Мы получили более понятную модель работы с файлами: стало проще связывать бизнес-сущность с набором S3-ключей, определять владельца данных и понимать, какие объекты еще используются.
Урок мы усвоили: любая миграция подсвечивает грабли, которые годами лежали в коде. И хотя история не терпит сослагательного наклонения, мы выделили несколько вещей, которые стоило бы сделать раньше:
Упорядочить владение директориями и ключами, чтобы миграция не превращалась в расследование многолетнего легаси.
Не допускать прямых обращений к S3 в обход Media.
Хранить связи между файлами и бизнес-сущностями прозрачнее: если приложение умеет восстановить ключи из данных сущности, набор объектов можно переносить адресно.
Раньше внедрить наблюдаемость для S3-операций: логи fallback помогли увидеть реальные обращения к старому бакету.
Продумывать поведение при ошибках до запуска массовой обработки.
Главные выводы
Этот проект начинался как попытка удалить лишние файлы из S3, но в итоге превратился в восстановление знаний о собственном хранилище.
Для нас здесь оказалось несколько важных инженерных принципов:
Не всегда нужно начинать с удаления. Если нельзя доказать, что данные больше не используются, безопаснее построить миграцию с возможностью отката, чем выполнять необратимую очистку.
Файлы нужно связывать с бизнес-сущностями. БД хранит данные, а MediaManager знает правила построения ключей. Вместе они позволяют восстановить список объектов для переноса.
Fallback может быть инструментом наблюдаемости. Он не только защищает от ошибок миграции, но и показывает, какие файлы реально запрашиваются из старого хранилища.
Retry должен зависеть от типа ошибки. Повторная попытка полезна при временном сбое, но бессмысленна для отсутствующего объекта.
Нужно проектировать не только успешный сценарий. При миграции на таком объеме стоит учитывать рост очереди, нестабильные соединения, потерянные объекты и длительную работу без отдельного окна обслуживания.
В итоге мы не просто сократили объем S3 с 65 до 45 ТБ, а сделали работу с файлами более управляемой и восстановили часть знаний, которые со временем потерялись вместе с историей сервисов.
Если вы сталкивались с миграцией легаси-хранилища или восстанавливали связи между файлами и бизнес-данными, расскажите в комментариях, какие подходы помогли вам не потерять данные и сохранить доступность production.